<?xml version="1.0" encoding="utf-8"?><feed xmlns="http://www.w3.org/2005/Atom" ><generator uri="https://jekyllrb.com/" version="4.4.1">Jekyll</generator><link href="/feed.xml" rel="self" type="application/atom+xml" /><link href="/" rel="alternate" type="text/html" /><updated>2025-12-29T09:18:25+00:00</updated><id>/feed.xml</id><entry><title type="html">阅读与观影：2025 片段</title><link href="/life/2025/12/25/2025-retrospect.html" rel="alternate" type="text/html" title="阅读与观影：2025 片段" /><published>2025-12-25T05:08:28+00:00</published><updated>2025-12-25T05:08:28+00:00</updated><id>/life/2025/12/25/2025-retrospect</id><content type="html" xml:base="/life/2025/12/25/2025-retrospect.html"><![CDATA[<ul id="markdown-toc">
  <li><a href="#历史" id="markdown-toc-历史">历史</a>    <ul>
      <li><a href="#宗教改革" id="markdown-toc-宗教改革">宗教改革</a></li>
      <li><a href="#英美法革命" id="markdown-toc-英美法革命">英美法革命</a></li>
    </ul>
  </li>
  <li><a href="#科学革命2" id="markdown-toc-科学革命2">科学革命[^2]</a></li>
  <li><a href="#政治与社会" id="markdown-toc-政治与社会">政治与社会</a>    <ul>
      <li><a href="#中国社会" id="markdown-toc-中国社会">中国社会</a></li>
      <li><a href="#医患关系" id="markdown-toc-医患关系">医患关系</a></li>
      <li><a href="#性别" id="markdown-toc-性别">性别</a></li>
    </ul>
  </li>
  <li><a href="#科幻" id="markdown-toc-科幻">科幻</a></li>
  <li><a href="#哲学4" id="markdown-toc-哲学4">哲学[^4]</a></li>
  <li><a href="#其他能在脑海中留下印象的书影" id="markdown-toc-其他能在脑海中留下印象的书影">其他能在脑海中留下印象的书影</a></li>
  <li><a href="#新发现的播客" id="markdown-toc-新发现的播客">新发现的播客</a></li>
  <li><a href="#对于-2026-的期待" id="markdown-toc-对于-2026-的期待">对于 2026 的期待</a></li>
</ul>

<p>今年使用 <a href="https://github.com/XiangpengHao/seen">seen</a> 来进行知识碎片的管理，在保持阅读量的同时相较于上一年更加系统。</p>

<h2 id="历史">历史</h2>

<ul>
  <li><a href="https://book.douban.com/subject/35641448/">罗马史研究入门（第二版）</a>：选读了罗马史概述，文笔非常流畅。快速翻阅了后面几章文献综述，可作为工具书对感兴趣处进行查阅。
    <ul>
      <li><a href="https://movie.douban.com/subject/1421781/">HBO 罗马</a></li>
      <li><a href="https://www.xiaoyuzhoufm.com/episode/670e37c40d2f24f28947f5c5">与徐松岩漫谈古希腊三大史家：希罗多德、修昔底德与色诺芬</a></li>
      <li><a href="https://www.xiaoyuzhoufm.com/episode/65fb07802d9eae5d0a0851e5">古希腊罗马的世界，离我们并不遥远</a></li>
      <li><a href="https://www.xiaoyuzhoufm.com/episode/65b1a5fce1421fa3c2a341f3">“古希腊的历史是伪造的？”聊聊希腊伪史论</a></li>
      <li><a href="https://www.xiaoyuzhoufm.com/episode/652889786394d1409addb0ee">这是一盘很大的棋：人为什么天生就爱阴谋论？</a></li>
    </ul>
  </li>
  <li><a href="https://book.douban.com/subject/1065142/">欧洲文明十五讲</a></li>
  <li><a href="https://book.douban.com/subject/36089561/">中世纪的身体</a>：非常好读的一本书，通过人类形体娓娓道来中世纪人们对于周遭世界、性别、宗教、族群认同、美学等的观念。</li>
  <li><a href="https://book.douban.com/subject/35523250/">花衣魔笛手：传说背后的欧洲中世纪</a>[^1]：非常好读的民俗学研究，以花衣魔笛手的传说为线索，由于”不具备构成世界观学问的民众通过传说来理解现实社会”，因此通过不同时期下的传说来展现出各个时代民众的思维世界。</li>
</ul>

<p>[NOTE] [^1]时不时想到《叫魂》，串联写历史社会实在太有趣。</p>
<h3 id="宗教改革">宗教改革</h3>

<ul>
  <li><a href="https://book.douban.com/subject/30168199/">不灭的火焰：宗教改革简史</a>：以人物作为线索串联起14到17世纪欧洲大陆与英国宗教改革进程，非常的好读，适合放在《宗教改革运动思潮》前快速扫盲。配合加州101<a href="https://www.xiaoyuzhoufm.com/podcast-topic/66a1f8e37349f7a5576eccbb">《这就是美国（一）》</a>中的部分章节食用更佳。</li>
  <li><a href="https://book.douban.com/subject/3552534/">宗教改革运动思潮</a>：初学者更推荐《不灭的火焰》进行扫盲，这本相较更偏学术。</li>
  <li><a href="https://book.douban.com/subject/24748675/">错引耶稣：《圣经》传抄、更改的内幕</a>：很有趣的一本书。解释了圣经新约的抄写中不仅有无意的错误（如笔误、漏写、重复），也有编者通过个人的需要、信仰、世界观、爱恨、欲求、处境与问题考虑的有意改动。</li>
</ul>

<h3 id="英美法革命">英美法革命</h3>

<ul>
  <li><a href="https://book.douban.com/subject/36389766/">工业革命</a>：提纲挈领，简明扼要。牛津通识读本系列对全景了解概念有很大的帮助。
    <ul>
      <li><a href="https://www.xiaoyuzhoufm.com/episode/682710a4fcbc2e206b3e850c">关税、公债与英式财政国家的起源</a></li>
    </ul>
  </li>
  <li><a href="https://book.douban.com/subject/26983920/">英国革命：1688-1689</a>：作者脉络清晰地梳理了光荣革命进程，将其描绘为英国立宪自由得以保存和发展的关键里程碑。作者强调“不流血”、限制了王权，彻底确立了议会主权高于君主的原则，并保障了一定程度的宗教宽容。末章还讨论了革命后苏格兰长老会的胜利和爱尔兰沦为英格兰殖民地的不同定局。
    <ul>
      <li><a href="https://www.xiaoyuzhoufm.com/episode/6515362ea3b0404cbf60277e">光荣革命小专题</a></li>
      <li><a href="https://www.xiaoyuzhoufm.com/episode/6824bf2f5ccf03732be3d80e">谁书写历史，谁定义进步：谈谈辉格史观</a></li>
    </ul>
  </li>
  <li><a href="https://book.douban.com/subject/26831740/">第一声礼炮：另一种视角下的美国革命</a>：不限于美国历史，对英法海战和荷兰进行了历史补充。对大英帝国的傲慢固执、短视与误判的描述应了 Barbara 最后一句 “在真理与无尽的谬误之间，物种所受到的束缚方是永恒的。”。
    <ul>
      <li><a href="https://movie.douban.com/subject/2131678/">HBO 约翰·亚当斯</a></li>
      <li><a href="https://www.xiaoyuzhoufm.com/podcast-topic/68f9ad9db76850792ae1e774">加州101《这就是美国（二）》</a></li>
      <li><a href="https://www.xiaoyuzhoufm.com/episode/6413ae006b20595a496082f9">路易十六人头落地230周年“纪念”</a></li>
      <li><a href="https://www.xiaoyuzhoufm.com/episode/63166de92e9ae0d5c32c4572">国父们的棺材板：关于美国早期共和主义的探讨</a></li>
      <li><a href="https://www.xiaoyuzhoufm.com/episode/6873a2eb93fd2d72b8f38fdb">老佛爷与革命者：谁是拉法耶特？</a></li>
      <li><a href="https://www.xiaoyuzhoufm.com/episode/6393217a5992c122f7de2d5a">与马凌聊革命浪潮中的英国与美国</a></li>
      <li><a href="https://www.xiaoyuzhoufm.com/episode/6939a3f62a383da1676e9985">账单和反诗：聊聊达恩顿的两本新书</a></li>
    </ul>
  </li>
</ul>

<h2 id="科学革命2">科学革命[^2]</h2>

<p>[NOTE] [^2]向张卜天老师致以最高的敬意。</p>
<ul>
  <li><a href="https://book.douban.com/subject/25777854/">科学革命</a>：详略得当，读下来没有阻碍，非常推荐的一本科学史入门读物。
    <ul>
      <li><a href="https://www.xiaoyuzhoufm.com/episode/65bc65190847349e0cd83c31">科学是如何起源的？</a></li>
    </ul>
  </li>
  <li><a href="https://book.douban.com/subject/26895884/">新物理学的诞生</a>：比较浅，适合高中教材配合食用。</li>
  <li><a href="https://book.douban.com/subject/30354892/">西方科学的起源：</a> 非常友好的科学史入门，清晰重建从古代到中世纪的生活、信念和活动。在末尾强调科学革命的连续性，植根于中世纪的基础，源于古典传统提供的资源。可惜内容结束在科学革命前夜，只恨太短。</li>
  <li><a href="https://book.douban.com/subject/36789556/">伽利略的望远镜：一件天文仪器引发的变革</a>：聚焦在望远镜的发明、天文发现（反驳亚里士多德“天体完美无瑕”论、地球与其他天体并无区别、木卫挑战地心说），详细描绘了《星空信使》（1610）前后的历史脉络。ps: 伽利略整字谜来和开普勒交流还挺乐的。
    <ul>
      <li><a href="https://www.xiaoyuzhoufm.com/episode/66f4a32d2adfe48b837c61da">三堂会审伽利略</a></li>
    </ul>
  </li>
  <li><a href="https://book.douban.com/subject/1110647/">哥白尼革命：西方思想发展中的行星天文学</a>：“尽管历史学家偶尔会为了哥白尼究竟是最后一个古代天文学家还是第一个近代天文学家争得面红耳赤，然而这种争辩从根本上是荒谬的。哥白尼既不是古代的也不是近代的，而是一个文艺复兴时期的天文学家，两种传统在他的工作中融合在一起。追问他的工作究竟是古代的还是近代的，就如同追问一条别处都是直的道路的转弯处是属于转弯之前那段路还是属于之后的那段。在转弯处，道路的前后两段都可以看到，而且其连续性十分明显。” 哥白尼并非站在某个终点或起点，他恰恰身处那个充满张力的拐点。在读到牛顿完成微观世界机器的建构，竟然有些感动。 ps: 作者对《天体运行论》进行注释适合我这种没读过原文的懒人（。
    <ul>
      <li><a href="https://www.xiaoyuzhoufm.com/episode/656dcb2689dfb0355cda04bc">一本“无人读过的书”</a></li>
      <li><a href="https://www.xiaoyuzhoufm.com/episode/64826cf0967dceb3da411919">哥白尼是被烧死的吗？哥白尼诞辰550周年纪念</a></li>
    </ul>
  </li>
  <li><a href="https://book.douban.com/subject/35951747/">科学革命的结构</a>：打破科学发展从不准确到准确、“错误”到“正确”的辉格史观，而是视角发生了转变。
    <ul>
      <li><a href="https://www.xiaoyuzhoufm.com/episode/668584a10bc5d7cc70a2abf6">能被证伪的玩意，还是科学？</a></li>
    </ul>
  </li>
  <li><a href="https://book.douban.com/subject/30354895/">近代物理科学的形而上学基础</a>：哥白尼对宇宙模型“简单性”的追求，开普勒对“和谐性”的坚信，伽利略的“数学世界观”，笛卡尔“机械宇宙论”的构建，上帝说让牛顿去吧，于是一切都被照亮。
    <ul>
      <li><a href="https://www.xiaoyuzhoufm.com/episode/66efe4326920a36bfcccab39">他“改变”了我们的世界</a></li>
      <li><a href="https://www.xiaoyuzhoufm.com/episode/6616b39f5dae7932c6ae8d48">火鸡科学家也配研究农场主（吗）？</a></li>
      <li><a href="https://www.xiaoyuzhoufm.com/episode/65710b7611cde6d1fdbe2c06">牛顿：我没有提出过引力理论。牛顿诞辰380周年纪念（上）</a><a href="https://www.xiaoyuzhoufm.com/episode/657a476e03a6907cd1c66e04">（下）</a></li>
    </ul>
  </li>
</ul>

<h2 id="政治与社会">政治与社会</h2>

<ul>
  <li><a href="https://book.douban.com/subject/26389495/">当代政治哲学</a>：绝佳的政治哲学综述著作，逻辑清晰，虽然费神但并无阅读障碍，串起了读完《公正》后的概念与疑惑，并引发了自身更多思考。
    <ul>
      <li><a href="https://www.xiaoyuzhoufm.com/episode/687630a493fd2d72b852c514">马基雅维利眼中的世界：作恶、美德与共和国</a></li>
      <li><a href="https://www.xiaoyuzhoufm.com/episode/689efba851528e172ad7bc05">从黑暗丛林到社会契约：利维坦之父霍布斯的机械唯物宇宙</a></li>
    </ul>
  </li>
  <li><a href="https://book.douban.com/subject/36956912/">汉娜·阿伦特与以赛亚·伯林：自由、政治与人性</a>：全书通过双重视角的对话证明“真正的哲学必须是活的”。 作者从二人犹太背景切入，犹太复国主义在30年代拉近了他们的距离，又在40年代末让他们分道扬镳。 双方对立的自由理论反映了他们对极权主义下的自由和非人性的理解上的冲突——阿伦特将集中营视为极权主义的核心，伯林则从观念史出发，警惕乌托邦主义、科学理性与积极自由可能催生的思想专制。 艾希曼审判为棱镜，折射出两人对历史罪责的差异立场：阿伦特以战时行动为荣，直面犹太合作者的道德困境；伯林则因战争期间对纳粹暴行的认知滞后而抱愧。 最后讨论双方的”理想乡“：阿伦特推崇美国立宪精神，对民众革命保持乐观，同时批判英帝国资产自由主义滋养了纳粹土壤；伯林则试图在民族主义与自由主义间寻找平衡，既认可良性民族认同的价值，又警惕德国”压弯的树枝”民族主义的扭曲形态。
    <ul>
      <li><a href="https://movie.douban.com/subject/10748498/">汉娜·阿伦特</a></li>
    </ul>
  </li>
  <li><a href="https://book.douban.com/subject/30288945/">国家与自由：昆廷·斯金纳访华讲演录</a>：用图像学分析霍布斯卷首图，并简明扼要探讨“自由”这一概念在西方政治理论中的谱系。</li>
  <li><a href="https://book.douban.com/subject/6397522/">论自由</a>：认定某一意见正确是因为它在一切与之竞争的场合中都未被驳倒，与认定它正确乃是因它不容反驳，这两者之间有着天壤之别。</li>
</ul>

<h3 id="中国社会">中国社会</h3>

<ul>
  <li><a href="https://www.goodreads.com/book/show/199347135-other-rivers">Other Rivers: A Chinese Education</a>：何伟在离开川大后的新书，视角值得一读。本来写了很多感想，但发现豆瓣已经移除了该书的条目。
    <ul>
      <li><a href="https://podcasts.apple.com/us/podcast/what-broke-the-u-s-china-relationship/id268213039?i=1000712510993">What Broke the U.S.-China Relationship?</a></li>
    </ul>
  </li>
  <li><a href="https://book.douban.com/subject/36161687/">人地之间：中国增长模式下的城乡土地改革</a>：非常棒，结合陶老师几期播客食用更佳：
    <ul>
      <li><a href="https://www.xiaoyuzhoufm.com/episode/648bc6ba830480fdfa05460e">对话经济学者陶然</a></li>
      <li><a href="https://www.xiaoyuzhoufm.com/episode/65004a622e8dc6113e746608">陶然谈土地财政与经济增长的未来</a></li>
      <li><a href="https://www.xiaoyuzhoufm.com/episode/68879903edf3fa32d5f20cb5">土地财政困局新解，对话陶然</a></li>
      <li><a href="https://www.xiaoyuzhoufm.com/episode/65b8d0a801c425338305c247">巨债与转型：钟宁桦谈地方债的前世今生</a></li>
    </ul>
  </li>
  <li><a href="https://book.douban.com/subject/37305024/">人性的深渊：吴谢宇案</a>：遗憾没有对谢天琴进行更深入的探讨，且日记引用也缺乏时间标注。吴谢宇的懦弱、自我欺骗、扭曲的世界观和各种援引令人窒息。
    <ul>
      <li><a href="https://www.xiaoyuzhoufm.com/episode/683ec9f031215eb5061995ad">追踪吴谢宇弑母案始末</a></li>
      <li><a href="https://www.xiaoyuzhoufm.com/episode/6833454641ef875a12293a7c">每个人身上，都有一部分吴谢宇</a></li>
      <li><a href="https://www.xiaoyuzhoufm.com/episode/66575ef7721e31720b95de65">社会达尔文主义从头聊：这是一个弱肉强食、优胜劣汰的世界吗？</a></li>
    </ul>
  </li>
</ul>

<h3 id="医患关系">医患关系</h3>

<ul>
  <li><a href="https://movie.douban.com/subject/36831851/">匹兹堡医护前线 第一季</a>：非常紧凑且好看，主要人物的群像都各有特色，不仅能高效地处理病患，更能利用自己的生活经验去关注心理健康和作为社会安全网托底。但剧中不少患者女性家属性格过于刻板印象令人失望。手术时不断提问自己在做什么，来保证按计划行事和头脑清醒很有启发。</li>
  <li><a href="https://movie.douban.com/subject/35101436/">成瘾剂量</a>：OxyContin 编年史。</li>
  <li><a href="https://movie.douban.com/subject/36650558/">常见副作用 第一季</a>：拾荒者统治团队制作，一如既往棒的脑洞。</li>
  <li><a href="https://mpre.lifeweek.com.cn/h5/article/detail.do?artId=243295">35岁两次患癌：”精英”标签之外，一个小镇姑娘独自面对死亡</a>[^3]：”也是到这个时候，我想说出来，这个社会不应该以绩优主义、社会达尔文主义来主导，不应该慕强恐弱，对那些”垃圾病人”、临终病人视而不见，再弱的人也应该被看见、被关怀，未来我们每个人可能都要走到这一步。我现在距离死亡还有10米，我会一直记录这10米中我经历了什么，这也是我们共同陪伴的生命体验的一部分。”</li>
</ul>

<p>[NOTE] [^3]“柱子哥把自己非常有限的时间和力气榨出大量长文章+系列视频+各种播客频道的节目，织出了一张和晚期肿瘤病人相关的信息大网，上至生死哲学，下到方方面面的实操指南、信息汇总和对社会系统的改进建议…” <a href="https://www.douban.com/people/3483055/status/5622238284/?_spm_id=MzQ4MzA1NQ&amp;dt_dapp=1&amp;_i=6666125xmY55ix">转载</a></p>

<h3 id="性别">性别</h3>

<ul>
  <li><a href="https://movie.douban.com/subject/36651114/">道格拉斯被取消了</a>：精彩绝伦，酒店戏令人叫绝。</li>
  <li><a href="https://movie.douban.com/subject/36820950/">混沌少年时</a>：第三集小演员的演技太棒，整体分析浅尝辄止，要是能再深入一些就更好了。</li>
  <li><a href="https://movie.douban.com/subject/35861791/">初步举证</a>：极其震撼，从舞台，台词到表演都无比震撼。</li>
</ul>

<h2 id="科幻">科幻</h2>

<ul>
  <li><a href="https://book.douban.com/subject/34672176/">呼吸</a>：字里行间能感受到作者不断的自省，且每一篇末尾都有着很有价值的后记，能一窥作者的灵感来源。</li>
  <li><a href="https://book.douban.com/subject/35114057/">使女的故事</a>：通过闪回、内心独白和交错的时间线，模仿记忆的不可靠性，压抑与窒息感扑面而来，最后一章笑着聊史料更是让人后背发凉。离我们又有多远呢？</li>
  <li><a href="https://movie.douban.com/subject/35783948/">人生切割术</a>：第七集标题 Chikhai Bardo 是藏传佛教中的概念，代表死亡瞬间的意识状态。对 Gemma 人生回溯让人难过又怀揣着一些期待。 ps 奶昔哥狂跑着关门去跳舞笑死。</li>
  <li><a href="https://movie.douban.com/subject/36508122/">瑞克和莫蒂 第八季</a>： 瑞克和莫蒂一百年！</li>
  <li><a href="https://movie.douban.com/subject/1972698/">守望者</a></li>
  <li><a href="https://movie.douban.com/subject/25807345/">彗星来的那一夜</a></li>
</ul>

<h2 id="哲学4">哲学[^4]</h2>

<p>[NOTE] [^4]TODO：<a href="https://www.douban.com/doubanapp/dispatch?uri=/book/27070172">哲学的历程</a> + <a href="https://book.douban.com/subject/26438558/">西方哲学史 - 从古希腊到当下</a></p>
<ul>
  <li><a href="https://book.douban.com/subject/30257757/">哲学是做出来的：初学者哲学技术指南</a>：不同于一般的导读书，该书注重的是认知技能而非历史回顾与主义分类。作者授人以渔地带着问题展示分析方法（分析问题、设计标准、其他方案缺陷、解释方案、评估方案适用性、回应可预见的批评）读下来也对自己思考论文结构有帮助。 作者最后提到阅读哲学书籍分为六步，也摘录下来。1.为结论，进行”主义”分类，了解全貌；2.为论证，了解推理结构；3.为情境，回到时空找出思考路径；以及：批判、裁定、创造。 ps: “形式”那一章不如贴上逻辑代数来的实在。</li>
  <li><a href="https://book.douban.com/subject/37229976/">学会思考：用批判性思维做出更好的判断</a>：本土化地教导如何论证。作者带着一些耳熟能详的案例进行模拟分析，相较上一本 The Practice of Philosophy 读下来更加有记忆点。
    <ul>
      <li>四分法是元方法，用在定位问题：1.是啥；2.造成啥后果（评估）；3.为啥这样（找出深层原因）；4.咋办。</li>
      <li>是啥需要归纳论证；评估需要审美、功利、道德的角度权衡；为啥需要控制变量法假设；怎么办需要按照目标、手段、利弊进行打分。</li>
      <li>且过程中伴之以对各个步骤的信息进行追溯准确性、提炼、评价（可接受性、相关性、充分性）与金字塔划分。</li>
      <li>ps: 结合 The Practice of Philosophy 的观点，记得在表达观点前：说清楚标准 + 想想如何应对可预见的批评。</li>
    </ul>
  </li>
</ul>

<h2 id="其他能在脑海中留下印象的书影">其他能在脑海中留下印象的书影</h2>

<ul>
  <li><a href="https://movie.douban.com/subject/35284254/">胜与败</a>：一场美妙的拼图游戏，喜欢刻画鲜明个性的群像戏。</li>
  <li><a href="https://movie.douban.com/subject/1301174/">傲慢与偏见</a>：Lizzy 眼睛会说话。</li>
  <li><a href="https://movie.douban.com/subject/4769314/">唐顿庄园</a>[^5]：剧情其实也挺多败笔的，但这景色就是让人停不下来。</li>
</ul>

<p>[NOTE] [^5]逛了一下唐顿庄园取景地 Highclere Castle，喜欢！</p>
<ul>
  <li><a href="https://movie.douban.com/subject/1292329/">牯岭街少年杀人事件</a>：一部60年代台湾转型的安魂曲。杨导通过外省移民的漂泊感，本省与外省帮派的冲突描述身份认同的困境；且展示出底层女性在男性暴力叙事的生存策略、少年寻找归属的街头文化（何尝不是台湾版火线呢）、体制的冷漠…来叩问暴力必然性的根源。</li>
  <li><a href="https://movie.douban.com/subject/1292206/">地下</a>：用荒诞、狂想与黑色幽默的笔触展示南斯拉夫从二战到解体的历史。</li>
  <li><a href="https://movie.douban.com/subject/35593344/">奥本海默</a>：笑着因为度蜜月而划去京都。（<a href="https://www.xiaoyuzhoufm.com/episode/64fa657e86a5e7a2d5a10466">奥本海默的“建弹大业”，诺兰的心思你别猜</a>）</li>
  <li><a href="https://movie.douban.com/subject/1292230/">刺杀肯尼迪</a>：黑白与彩色画面交替，多视角的反复闪回增加不确定性。一部极佳的檄文，传递了对权力、真相与历史的永恒追问。</li>
  <li><a href="https://movie.douban.com/subject/34839005/">克拉克森的农场 第一季</a>：几个人的化学反应太棒了！</li>
  <li><a href="https://movie.douban.com/subject/1292000/">搏击俱乐部</a></li>
  <li>失望：<a href="https://movie.douban.com/subject/10577869/">时空恋旅人</a>，<a href="https://movie.douban.com/subject/35506348/">白莲花度假村 第一季</a>，<a href="https://movie.douban.com/subject/1292365/">活着</a></li>
</ul>

<h2 id="新发现的播客">新发现的播客</h2>

<ul>
  <li><a href="https://leftovertalk.fm/">边角聊</a>：年度播客，选题（科学史，观史记）和聊天方式都很喜欢。</li>
  <li><a href="https://www.xiaoyuzhoufm.com/podcast/68aeccd6d73b7726ae9d91b6">只读半卷书</a>：爱听亮师唠嗑。</li>
  <li><a href="https://podcasts.apple.com/ca/podcast/%E5%8A%B3%E4%B8%9C%E7%87%95-%E6%B3%95%E4%B8%8E%E8%BF%9C%E6%96%B9/id1842041317">劳东燕 - 法与远方</a>：敬佩还在坚持发声的劳教授。</li>
  <li><a href="https://podcasts.apple.com/cn/podcast/%E7%BF%BB%E8%BD%AC%E5%8F%B0%E7%94%B5-%E7%BF%BB%E7%94%B5/id1119089237">翻转台电（翻电）</a>：houchen 真是精力充沛产出惊人。</li>
  <li><a href="https://www.xiaoyuzhoufm.com/podcast/625ea2bc493ea2f504a55bec">科学星球</a>：补充物理知识（。</li>
  <li><a href="https://www.xiaoyuzhoufm.com/podcast/64f6f00c8d3268493370145f">高山科学经典</a>：配合科学史食用更佳。</li>
  <li><a href="https://www.xiaoyuzhoufm.com/podcast/611719d3cb0b82e1df0ad29e">无人知晓</a>：<a href="https://www.xiaoyuzhoufm.com/episode/61ee26c84675a08411f51570">让万物穿过自己</a>，<a href="https://www.xiaoyuzhoufm.com/episode/6720836fbad346ebe6399017">鱼不存在</a>，<a href="https://www.xiaoyuzhoufm.com/episode/6819986247ebeede7efbe7dd">孟岩对话重轻</a>。</li>
  <li><a href="https://www.xiaoyuzhoufm.com/podcast/67fcb80203982ffc37b28611">热可可</a>：shiyu 和孟岩都有一种与自己相像的感觉。<a href="https://www.xiaoyuzhoufm.com/episode/68c82d4da56ca3e0c491a253">特朗普VS泰勒·斯威夫特，谁是真正的美国偶像</a>、<a href="https://www.xiaoyuzhoufm.com/episode/690a052daaf2588eb7ed4ef5">艾玛·沃森：当一个人太想成为好人</a></li>
</ul>

<h2 id="对于-2026-的期待">对于 2026 的期待</h2>

<ul>
  <li>科研更加系统化</li>
  <li>18 世纪历史的细致阅读</li>
  <li>食品相关阅读（小兔也喜欢）</li>
</ul>]]></content><author><name></name></author><category term="life" /></entry><entry><title type="html">阅读与观影：2024 片段</title><link href="/life/2024/12/23/2024-retrospect.html" rel="alternate" type="text/html" title="阅读与观影：2024 片段" /><published>2024-12-23T12:51:28+00:00</published><updated>2024-12-23T12:51:28+00:00</updated><id>/life/2024/12/23/2024-retrospect</id><content type="html" xml:base="/life/2024/12/23/2024-retrospect.html"><![CDATA[<ul id="markdown-toc">
  <li><a href="#政治与社会" id="markdown-toc-政治与社会">政治与社会</a></li>
  <li><a href="#历史" id="markdown-toc-历史">历史</a>    <ul>
      <li><a href="#德国2" id="markdown-toc-德国2">德国[^2]</a></li>
      <li><a href="#共运史" id="markdown-toc-共运史">共运史</a></li>
      <li><a href="#一战二战" id="markdown-toc-一战二战">一战&amp;二战</a></li>
    </ul>
  </li>
  <li><a href="#性别" id="markdown-toc-性别">性别</a></li>
  <li><a href="#艺术" id="markdown-toc-艺术">艺术</a></li>
  <li><a href="#经济" id="markdown-toc-经济">经济</a></li>
  <li><a href="#其他能在脑海中留下印象的书影" id="markdown-toc-其他能在脑海中留下印象的书影">其他能在脑海中留下印象的书影</a></li>
  <li><a href="#新发现的播客" id="markdown-toc-新发现的播客">新发现的播客</a></li>
  <li><a href="#技术" id="markdown-toc-技术">技术</a></li>
  <li><a href="#对于-2025-的期待5" id="markdown-toc-对于-2025-的期待5">对于 2025 的期待[^5]</a></li>
</ul>

<p>今年总共读了 39 本书，看了 104 部影视，听了 600h+ 播客。在此记录分享一些个人喜爱的作品，夹杂着一些联想来帮助强化个人<em>信念之网[^1]</em>与记忆。</p>

<p>[NOTE] [^1]信念之网：通过观察（实指法）传递信念，信念交织组成了一张巨大的信念之网，从内到外：自明性（逻辑真理）、常识、证言（权威）、假说。  ——《蒯因著作集（第5卷）》</p>

<h2 id="政治与社会">政治与社会</h2>

<ul>
  <li><a href="https://book.douban.com/subject/26389495/">当代政治哲学</a>：今年最费神的一本。作为导论满分，要是各个学科导论能做到这本书的质量和延伸那该多好呀</li>
  <li><a href="https://book.douban.com/subject/20366368/">公正-该如何做是好？</a>：内容源于 Sandel 的<a href="https://movie.douban.com/subject/25823618/">哈佛公开课</a>，作者引领着不断地进行反思批判与政治改良，以帮助读者培养德性与推理共同善</li>
  <li><a href="https://book.douban.com/subject/36985251/">过渡劳动-平台经济下的外卖骑手</a>：强烈的社会责任感和扎实的田野记录。“微观赋权，宏观收权”让看似流动性高的“过渡劳动”逐渐变为“永久零工”。平台让外卖骑手成为“该等待”的人，套利剩余劳动时间来服务另一部分人，模糊了必要劳动和社会再生产时间，并强化了区隔感</li>
  <li><a href="https://book.douban.com/subject/30441554/">六论自发性-自主、尊严，以及有意义的工作和游戏</a>：大家小书，从无政府主义的视角重申了个体自主的重要性</li>
  <li><a href="https://m.douban.com/movie/subject/1418199/">火线</a> The Wire：今年看过最棒的剧了，Better Call Soul 也得降半个档
    <ul>
      <li>视角庞杂，将观众的感受放在真实、连贯、整体的呈现之下，分五季按照不同切面：毒品交易、港口众生、官僚主义作风的市政府、无能的教育系统及平面媒体，鞭辟入里地展现巴尔的摩众生相。警民敌对的部落化状态来源于：政策层面上对贫穷人口的抛弃、执法实践中对理论的轻率想象、数据系统的作茧自缚以及立法层面对执法机关过大的赋权和对人权的退让。街头文化在没有公正也没有退路的世界里，生存的技能和人际关系都围绕着影子经济来构建，每个人都无力抵抗、都放弃并嘲笑那个正向的价值观念，并且只能投身在互相倾轧的街头中。</li>
      <li><a href="https://www.gcores.com/articles/170157">导读</a>：重轻开了一档火线导读播客，快去听！还有人没听过<a href="https://buzaichang.xyz/">《不在场》</a>吗？也快去听！</li>
      <li>一些今年比较喜欢的社会类书影：<a href="https://m.douban.com/book/subject/5414391/">寻路中国</a>、<a href="https://m.douban.com/movie/subject/1297880/">芙蓉镇</a>、<a href="https://movie.douban.com/subject/1305261/">恐怖分子</a>、<a href="https://movie.douban.com/subject/2272222/">耳朵大有福</a>、<a href="https://movie.douban.com/subject/3724118/">龙哥</a></li>
    </ul>
  </li>
  <li><a href="https://movie.douban.com/subject/4937405/">是大臣</a> &amp; <a href="https://movie.douban.com/subject/1441948/">是首相</a>：经典政治讽刺剧</li>
  <li><a href="https://movie.douban.com/subject/30181230/">我们与恶的距离</a>：短短十集，从司法公正、媒介审判、社会舆论到新闻理想、精神病患与医护、婚姻家庭。在乔安流泪和思聪的“为什么是我”的时候，眼泪止都止不住</li>
</ul>

<h2 id="历史">历史</h2>

<ul>
  <li><a href="https://book.douban.com/subject/26591910/">历史的巨镜</a>：剥茧抽丝地阐述现代性的两层基本结构：第一层是工具理性和个人权利的现代价值系统、市场经济与民族认同；第二层为国际法秩序、全球化市场与民族国家。跟推导物理公式似的很过瘾。待继续看<a href="https://m.douban.com/book/subject/35472589/">《轴心文明与现代社会》</a></li>
  <li><a href="https://book.douban.com/subject/26639302/">世界的演变</a>：有关 19 世纪的诸多专题论述的合集</li>
  <li><a href="https://www.xiaoyuzhoufm.com/podcast-topic/6650610dc59d1e57576b6856">十九世纪就在你家隔壁-高林</a>：高老爷开讲！</li>
</ul>

<h3 id="德国2">德国[^2]</h3>

<p>[NOTE] [^2]今年比较大的一件事是去德国读博，因此试着去了解了一些德国历史。</p>

<ul>
  <li><a href="https://book.douban.com/subject/36091018/">德意志贵族-一个群体的生活、历史与命运</a>：以概念辨析、衔级体系、历史演进与社会生活等角度描述德意志贵族，填充了中文世界空白（陆大鹏的播客也挺好听）</li>
  <li><a href="https://www.xiaoyuzhoufm.com/episode/615ad8a9ae1d32c4f86c1cd9">默克尔</a>、中德建交历程（<a href="https://www.xiaoyuzhoufm.com/episode/6369419e0d8d43263ef8ccd0">上</a>&amp;<a href="https://www.xiaoyuzhoufm.com/episode/64e8ad2780c9ec4c5f467f2b">下</a>）</li>
  <li><a href="https://book.douban.com/subject/26647781/">从俾斯麦到希特勒</a>：1871 到 1987，从普鲁士到两德统一前夕，清晰易读</li>
  <li><a href="https://m.douban.com/movie/subject/26389403/">巴比伦柏林</a>：魏玛共和国时期社会万花筒的展开</li>
  <li><a href="https://www.xiaoyuzhoufm.com/episode/659d259baaf80018359aff6d">魏玛共和国的犯罪史</a>、<a href="https://movie.douban.com/subject/1292055/">再见列宁</a></li>
</ul>

<h3 id="共运史">共运史</h3>

<ul>
  <li><a href="https://www.xiaoyuzhoufm.com/episode/5f3f9d1c9504bbdb776c0f6e">托洛茨基</a>、<a href="https://www.xiaoyuzhoufm.com/episode/5f3a57129504bbdb77b6d756">罗莎卢森堡</a>、<a href="https://www.xiaoyuzhoufm.com/episode/611108780f547e772c5b3b9e">李卜克内西与艾伯特</a>、<a href="https://www.xiaoyuzhoufm.com/episode/6479d125dfb3befd4beca46f">社民党的百年史</a>、<a href="http://sis.ruc.edu.cn/gzpl/abffa5ba2f5347488be66f5c0da8721c.htm">《败也“全民党”，成也“全民党”》</a></li>
</ul>

<h3 id="一战二战">一战&amp;二战</h3>

<ul>
  <li><a href="https://movie.douban.com/subject/25823668/">战前37天（英德公务员视角）</a>、<a href="https://movie.douban.com/subject/22623816/">我们的父辈（德国年轻人视角）</a></li>
  <li><a href="https://movie.douban.com/subject/35769174/">万湖会议</a>[^3]：毛骨悚然。无配乐长谈话，措辞用语惊人地熟悉。以后见之明审视今日之景，太多高效简单地将人变为数字的案例</li>
  <li><a href="https://movie.douban.com/subject/1296736/">钢琴家</a>：分食的糖块，跳跃的指尖和耳鸣的踉跄</li>
  <li><a href="https://movie.douban.com/subject/30412658/">里斯本丸沉没</a></li>
</ul>

<p>[NOTE] [^3]毒气在德语里竟然是 Giftgas…</p>

<h2 id="性别">性别</h2>

<ul>
  <li><a href="https://www.douban.com/podcast/36871347/">岩中花述</a>：鲁豫同各行各业的女性进行交谈，世界需要多一点女性声音</li>
  <li><a href="https://book.douban.com/subject/36893055/">她的荆棘</a>：子宫内膜异位症科普书</li>
  <li><a href="https://movie.douban.com/subject/27615467/">大法官金斯伯格 RBG</a>：优雅又掷地有声</li>
  <li><a href="https://movie.douban.com/subject/25821498/">妇女参政论者</a>：从一位温驯女工视角展开，性骚扰、殴打、欺骗、羞辱、街坊舆论…在不断唤 Emily 的鼓点声中揪心坐直。 “如果我们有女儿，她会过着怎样的生活” “跟你一样的生活”</li>
  <li><a href="https://movie.douban.com/subject/28427782/">我的天才女友</a>：书比影视更细腻</li>
  <li><a href="https://mp.weixin.qq.com/s/QODG-4GG80RUfp7dBMW8XA">袁源-男人可以称自己为女权主义者么？</a>非常棒的一篇文章，思路清晰，论证严谨</li>
  <li><a href="https://www.xiaoyuzhoufm.com/episode/6412a4f0e52db99e4723a70c">三八节有感-我当全职爸爸的体验</a></li>
</ul>

<h2 id="艺术">艺术</h2>

<ul>
  <li><a href="https://book.douban.com/subject/3162991/">艺术的故事</a>[^4]：要说这本书的缺点，就是太薄，以作者的知识量和表述，再写十本都不嫌多
    <ul>
      <li><a href="https://movie.douban.com/subject/26961333/">抽象：设计的艺术</a>，看完去读了《<a href="https://book.douban.com/subject/30303814/">周末速写》</a>，可爱</li>
    </ul>
  </li>
</ul>

<p>[NOTE] [^4]下半年去逛了逛<a href="https://www.instagram.com/p/DBI5lzUOGE_/?utm_source=ig_web_copy_link&amp;igsh=MzRlODBiNWFlZA==">柏林博物馆岛</a>，喜欢</p>

<ul>
  <li><a href="https://book.douban.com/subject/30247531/">听音乐（Music: An Appreciation, 11th Editon）</a>：适合乐理初学者和历史爱好者，并在几场室内音乐会感受到古典音乐会现场的魅力
    <ul>
      <li><a href="https://podcasts.apple.com/cn/podcast/%E6%97%B6%E5%85%89%E9%87%8C%E7%9A%84%E6%97%8B%E5%BE%8B-%E4%BB%8E%E9%9B%B6%E5%BC%80%E5%A7%8B%E5%85%A5%E9%97%A8%E5%8F%A4%E5%85%B8%E9%9F%B3%E4%B9%90/id1481229699?i=1000668532050&amp;l=en-GB">Vibration 歪波音室-从零开始入门古典音乐</a>、<a href="https://podcasts.apple.com/cn/podcast/%E7%A9%BF%E8%B6%8A%E5%8E%86%E5%8F%B2%E7%9A%84%E9%9F%B3%E7%AC%A6-%E5%A6%82%E4%BD%95%E6%9B%B4%E5%A5%BD%E5%9C%B0%E5%85%A5%E9%97%A8%E5%8F%A4%E5%85%B8%E9%9F%B3%E4%B9%90/id1481229699?i=1000672950215&amp;l=en-GB">如何更好地入门古典音乐</a>、<a href="https://book.douban.com/subject/2094547/">西方音乐简史-余志刚</a></li>
      <li><a href="https://movie.douban.com/subject/36538847/">Taylor Swift-The Eras Tour</a>：松仔全会唱，太厉害了！</li>
      <li>罗大佑<a href="https://www.douban.com/event/36413078/">《春龙交响夜音乐会》</a> - 广州站 2024/7/6</li>
      <li>缺省乐队<a href="https://music.apple.com/cn/album/%E5%85%B1%E5%90%8C%E7%9A%84%E5%9C%9F%E5%9C%B0/1707500254?l=en-GB">《共同的土地》</a>- 广州站 2024/4/5</li>
      <li><a href="https://www.bilibili.com/video/BV1ZzyTYvEgq/?share_source=copy_web&amp;vd_source=2eb55ce5cd5f24d2d47787beb422a587">HOPICO 与方大同</a> - 听到方大同现在的声音状态，难受</li>
    </ul>
  </li>
  <li><a href="https://movie.douban.com/subject/1424406/">星际牛仔</a>：最棒的动画</li>
  <li><a href="https://movie.douban.com/subject/25782342/">电子游戏如何改变世界</a>：游戏视角的近代史</li>
  <li><a href="https://book.douban.com/subject/26666533/">梵高手稿</a>：“我的心不再渴望任何丰功伟业，所有我在绘画中想得到的，只是熬过这一生的一种方式。”1890年，梵高卖出了第一部作品，也是扣下扳机的那一年。 “没有你，这些画不可能在不幸和颠沛流离中保持一份平静。”悲伤击垮了提奥，次年1月在荷兰去世。梵高的灵魂里有一团火，提奥一直在添柴</li>
</ul>

<h2 id="经济">经济</h2>

<ul>
  <li><a href="https://book.douban.com/subject/35005103/">经济学原理(第8版)-微观经济学分册</a>：引人入胜的教材，跟着做完了习题，非常好的入门读物</li>
  <li><a href="https://book.douban.com/subject/5311626/">A CONCISE GUIDE TO MACROECONOMICS</a>：非常好读，简短地了解了支出、货币与预期。但经常金融和金融账户解释不充分。比较值得吐槽的一点是中文译名叫《七天读懂宏观经济》</li>
  <li><a href="https://book.douban.com/subject/35546622/">置身事内-中国政府与经济发展</a>：对政府经济运作、土地财政、投融资引导、债务风险有了一定了解。各部分的扩展阅读很赞</li>
</ul>

<h2 id="其他能在脑海中留下印象的书影">其他能在脑海中留下印象的书影</h2>

<ul>
  <li><a href="https://book.douban.com/subject/35430408/">乒乓漫画</a>及<a href="https://movie.douban.com/subject/25813424/">配套动画</a>：群描出众生的羁绊，各有各的迷人之处</li>
  <li><a href="https://movie.douban.com/subject/20644938/">硅谷 1-6</a>：Kiss my piss! S5E7 结尾海尔兄弟 made in china 可还行</li>
  <li>脑洞：<a href="https://movie.douban.com/subject/35819414/">人生复本</a>、<a href="https://book.douban.com/subject/35005045/">夜晚的潜水艇</a>、<a href="https://movie.douban.com/subject/30391186/">蜘蛛侠-纵横宇宙</a>、<a href="https://movie.douban.com/subject/3986493/">神探夏洛克</a>、<a href="https://book.douban.com/subject/36328704/">太白金星有点烦</a>、<a href="https://movie.douban.com/subject/36025639/">瑞克和莫蒂 VII</a></li>
  <li>温暖：<a href="https://movie.douban.com/subject/10533913/">头脑特工队</a>、<a href="https://movie.douban.com/subject/2129039/">飞屋环游记</a>、<a href="https://movie.douban.com/subject/3792799/">岁月神偷</a>、<a href="https://movie.douban.com/subject/33444115/">我们这一天</a>、<a href="https://movie.douban.com/subject/1291583/">天空之城</a>、<a href="https://movie.douban.com/subject/20495023/">寻梦环游记</a>、<a href="https://movie.douban.com/subject/35185752/">我的章鱼老师</a>、<a href="https://movie.douban.com/subject/26858510/">Klaus</a>、<a href="https://movie.douban.com/subject/20438964/">无敌破坏王2</a></li>
  <li>失望：<a href="https://movie.douban.com/subject/35634023/">灵能百分百 Ⅲ</a></li>
</ul>

<h2 id="新发现的播客">新发现的播客</h2>

<ul>
  <li><a href="https://www.xiaoyuzhoufm.com/podcast/5f2162169504bbdb772facc3">鼓腹而游</a>：<a href="https://weibo.com/ziqilianzhi?topnav=1&amp;wvr=6&amp;topsug=1">筱狸</a>、<a href="https://www.douban.com/people/nellylin/">Nelly</a>与<a href="https://weibo.com/u/7151076970">程老板</a>唠嗑，愿称为程老板漏出肚皮时刻</li>
  <li><a href="https://www.xiaoyuzhoufm.com/podcast/67091e6e88064386beca0b78">一个玩说唱的</a>、<a href="https://music.163.com/#/radio?app_version=9.2.22&amp;id=1215716757&amp;dlt=0846">一个听说唱的</a>：小老虎真是说唱诗人</li>
  <li><a href="https://www.douban.com/podcast/36723459/">电影巨辩</a>：自从有了电影巨辩，人类的生命至少延长了三倍（时长感人且信息量爆炸</li>
  <li><a href="https://www.xiaoyuzhoufm.com/podcast-topic/66a1f8e37349f7a5576eccbb">这就是美国（一）</a>：加叔新开的美国历史，也非常推荐去年一口气听完的<a href="https://www.vistopia.com.cn/detail/163">《中东往事》</a>。想写年终总结也是因为加叔每年的朝花夕拾。不知道特朗普上台后，加叔又作何打算</li>
  <li><a href="https://www.xiaoyuzhoufm.com/podcast/609356cb925f506c9b31e8cf">越向书</a>：小宇宙评论区最活跃的主播（</li>
  <li><a href="https://podcasts.apple.com/cn/podcast/%E7%90%86%E6%80%A7%E6%89%B9%E5%88%A4/id1614253470?l=en-GB">理性批判</a>：主播德国政治学博士留学背景，讲中德关系非常棒</li>
</ul>

<h2 id="技术">技术</h2>

<ul>
  <li>年初成为了 <a href="https://github.com/tikv/community/pull/204">PD committer</a>！在贵司经历了一段非常满意且开心的时光，并将产出沉淀在了自己的<a href="https://husharp.today/resume.html">简历</a>上</li>
  <li>推荐 <a href="https://book.douban.com/subject/35904892/">Rust Atomics and Locks : Low-Level Concurrency in Practice</a>，为 rust 并发编程造轮子，且循序渐进地进行系统优化，明白了各个结构背后实现的原因</li>
  <li><a href="https://github.com/ihusharp">总结了一下造过地轮子</a>，不过大多都是出于临摹，希望能在读博期间造出真正属于自己的轮子</li>
</ul>

<h2 id="对于-2025-的期待5">对于 2025 的期待[^5]</h2>

<p>[NOTE] [^5]偶尔会被一些过去所写下的只言片语所感动，因此希望能养成记录的习惯，给自己更多被感动的机会。</p>

<ul>
  <li>提高英语水平</li>
  <li>尽量写写周记</li>
</ul>]]></content><author><name></name></author><category term="life" /></entry><entry><title type="html">Flashback Cluster in TiKV</title><link href="/distributed/2023/05/20/Flashback-in-TiKV.html" rel="alternate" type="text/html" title="Flashback Cluster in TiKV" /><published>2023-05-20T09:43:28+00:00</published><updated>2023-05-20T09:43:28+00:00</updated><id>/distributed/2023/05/20/Flashback-in-TiKV</id><content type="html" xml:base="/distributed/2023/05/20/Flashback-in-TiKV.html"><![CDATA[<ul id="markdown-toc">
  <li><a href="#背景介绍" id="markdown-toc-背景介绍">背景介绍</a>    <ul>
      <li><a href="#执行与效果" id="markdown-toc-执行与效果">执行与效果</a></li>
      <li><a href="#具体实现" id="markdown-toc-具体实现">具体实现</a>        <ul>
          <li><a href="#采用-region-锁停读写调度" id="markdown-toc-采用-region-锁停读写调度">采用 Region 锁停读写调度</a></li>
          <li><a href="#大致流程" id="markdown-toc-大致流程">大致流程</a></li>
        </ul>
      </li>
    </ul>
  </li>
  <li><a href="#代码分析" id="markdown-toc-代码分析">代码分析</a>    <ul>
      <li><a href="#流程概览" id="markdown-toc-流程概览">流程概览</a></li>
      <li><a href="#phase1-1-prepare" id="markdown-toc-phase1-1-prepare">Phase1-1: Prepare</a>        <ul>
          <li><a href="#prepare-flashback" id="markdown-toc-prepare-flashback">Prepare Flashback</a></li>
          <li><a href="#停读" id="markdown-toc-停读">停读</a></li>
          <li><a href="#readlocal--staleread" id="markdown-toc-readlocal--staleread">ReadLocal &amp; StaleRead</a></li>
          <li><a href="#停写" id="markdown-toc-停写">停写</a></li>
        </ul>
      </li>
      <li><a href="#phase1-2-prewrite" id="markdown-toc-phase1-2-prewrite">Phase1-2: Prewrite</a>        <ul>
          <li><a href="#停止-resolved-_ts-的推进" id="markdown-toc-停止-resolved-_ts-的推进">停止 resolved _ts 的推进</a></li>
          <li><a href="#读写阶段介绍" id="markdown-toc-读写阶段介绍">读写阶段介绍</a></li>
        </ul>
      </li>
      <li><a href="#phase2-1-exec--commit" id="markdown-toc-phase2-1-exec--commit">Phase2-1: Exec &amp; Commit</a></li>
      <li><a href="#phase2-2-finish" id="markdown-toc-phase2-2-finish">Phase2-2: Finish</a></li>
    </ul>
  </li>
  <li><a href="#appendix" id="markdown-toc-appendix">Appendix</a>    <ul>
      <li><a href="#一些踩过的坑" id="markdown-toc-一些踩过的坑">一些踩过的坑</a></li>
      <li><a href="#改进点" id="markdown-toc-改进点">改进点</a></li>
      <li><a href="#参考文档" id="markdown-toc-参考文档">参考文档</a></li>
    </ul>
  </li>
</ul>

<p>这是一篇原本要作为产品介绍的文章，但种种原因搁置了，最近又在完善相关功能，索性就完善一下发出来。感恩 <a href="https://ipotato.me/">JmPotato</a> 哥哥的带飞~</p>

<p>代码请见：<a href="https://github.com/pingcap/tidb/issues/37197">roadmap</a> &amp; <a href="https://github.com/tikv/tikv/issues/13303">TiKV tracking issue</a></p>

<h2 id="背景介绍">背景介绍</h2>

<p>Flashback（通常指 Oracle Flashback）是用于在用户发生误操作的时候，快速回滚至原先版本，避免产生重大损失的特性。</p>

<p>游戏行业中会不时出现版本错误等问题，定期的备份只能回滚到备份时间点，且浪费资源。TiDB v6.4.0 引入了 FLASHBACK CLUSTER TO TIMESTAMP 语法，其功能是将集群、数据库、数据表的数据恢复到特定的时间点。</p>

<p>在 TiDB 中，存在一些相关的功能：</p>

<ul>
  <li>MVCC &amp; GC：数据更新或删除都是增加新版本，历史版本通过 GC 机制进行清理。存储引擎中保存有一定时间内的历史记录，这为之后的各种恢复数据功能提供了可能。</li>
  <li>通过系统变量 tidb_snapshot 读取历史数据：指定一个 ts（不能早于 GC safepoint），读取对应时间点的数据，并且保证数据是一致的。</li>
  <li>FLASHBACK TABLE：恢复被 DROP 或 TRUNCATE 删除的表以及数据。</li>
</ul>

<p>我们最终采用在多版本并发控制（MVCC）的基础上，取出 TIMESTAMP 之前的最新时间戳数据来覆盖当前的数据。</p>

<h3 id="执行与效果">执行与效果</h3>

<p>『详细操作请参考 <a href="https://docs.pingcap.com/zh/tidb/dev/sql-statement-flashback-to-timestamp">用户文档</a>』</p>

<div class="language-sql highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">mysql</span><span class="o">&gt;</span> <span class="k">CREATE</span> <span class="k">TABLE</span> <span class="n">t</span><span class="p">(</span><span class="n">a</span> <span class="nb">INT</span><span class="p">);</span>
<span class="n">Query</span> <span class="n">OK</span><span class="p">,</span> <span class="mi">0</span> <span class="k">rows</span> <span class="n">affected</span> <span class="p">(</span><span class="mi">0</span><span class="p">.</span><span class="mi">09</span> <span class="n">sec</span><span class="p">)</span>

<span class="n">mysql</span><span class="o">&gt;</span> <span class="k">SELECT</span> <span class="o">*</span> <span class="k">FROM</span> <span class="n">t</span><span class="p">;</span>
<span class="n">Empty</span> <span class="k">set</span> <span class="p">(</span><span class="mi">0</span><span class="p">.</span><span class="mi">01</span> <span class="n">sec</span><span class="p">)</span>

<span class="n">mysql</span><span class="o">&gt;</span> <span class="k">SELECT</span> <span class="n">now</span><span class="p">();</span>
<span class="o">+</span><span class="c1">---------------------+</span>
<span class="o">|</span> <span class="n">now</span><span class="p">()</span>               <span class="o">|</span>
<span class="o">+</span><span class="c1">---------------------+</span>
<span class="o">|</span> <span class="mi">2022</span><span class="o">-</span><span class="mi">09</span><span class="o">-</span><span class="mi">28</span> <span class="mi">17</span><span class="p">:</span><span class="mi">24</span><span class="p">:</span><span class="mi">16</span> <span class="o">|</span>
<span class="o">+</span><span class="c1">---------------------+</span>
<span class="mi">1</span> <span class="k">row</span> <span class="k">in</span> <span class="k">set</span> <span class="p">(</span><span class="mi">0</span><span class="p">.</span><span class="mi">02</span> <span class="n">sec</span><span class="p">)</span>

<span class="n">mysql</span><span class="o">&gt;</span> <span class="k">INSERT</span> <span class="k">INTO</span> <span class="n">t</span> <span class="k">VALUES</span> <span class="p">(</span><span class="mi">1</span><span class="p">);</span>
<span class="n">Query</span> <span class="n">OK</span><span class="p">,</span> <span class="mi">1</span> <span class="k">row</span> <span class="n">affected</span> <span class="p">(</span><span class="mi">0</span><span class="p">.</span><span class="mi">02</span> <span class="n">sec</span><span class="p">)</span>

<span class="n">mysql</span><span class="o">&gt;</span> <span class="k">SELECT</span> <span class="o">*</span> <span class="k">FROM</span> <span class="n">t</span><span class="p">;</span>
<span class="o">+</span><span class="c1">------+</span>
<span class="o">|</span> <span class="n">a</span>    <span class="o">|</span>
<span class="o">+</span><span class="c1">------+</span>
<span class="o">|</span>    <span class="mi">1</span> <span class="o">|</span>
<span class="o">+</span><span class="c1">------+</span>
<span class="mi">1</span> <span class="k">row</span> <span class="k">in</span> <span class="k">set</span> <span class="p">(</span><span class="mi">0</span><span class="p">.</span><span class="mi">01</span> <span class="n">sec</span><span class="p">)</span>

<span class="n">mysql</span><span class="o">&gt;</span> <span class="n">FLASHBACK</span> <span class="k">CLUSTER</span> <span class="k">TO</span> <span class="nb">TIMESTAMP</span> <span class="s1">'2022-09-28 17:24:16'</span><span class="p">;</span>
<span class="n">Query</span> <span class="n">OK</span><span class="p">,</span> <span class="mi">0</span> <span class="k">rows</span> <span class="n">affected</span> <span class="p">(</span><span class="mi">0</span><span class="p">.</span><span class="mi">20</span> <span class="n">sec</span><span class="p">)</span>

<span class="n">mysql</span><span class="o">&gt;</span> <span class="k">SELECT</span> <span class="o">*</span> <span class="k">FROM</span> <span class="n">t</span><span class="p">;</span>
<span class="n">Empty</span> <span class="k">set</span> <span class="p">(</span><span class="mi">0</span><span class="p">.</span><span class="mi">00</span> <span class="n">sec</span><span class="p">)</span>
</code></pre></div></div>

<h3 id="具体实现">具体实现</h3>

<h4 id="采用-region-锁停读写调度">采用 Region 锁停读写调度</h4>

<p>我们在 Flashback 中采用 Region 锁来阻断 Flashback 过程中的所有读写以及调度，避免产生任何可能导致数据不一致的外部因素。</p>

<p><strong>通过给 Region 先上锁再 Flashback，我们可以获得以下好处：</strong></p>

<ul>
  <li>阻断任何 Flashback 过程中的读写以及调度，避免产生任何可能导致数据不一致的外部因素；</li>
  <li>由于上锁后的 Region 不会产生额外的数据写入，便于 Flashback 自由地写入和重试；</li>
  <li>由于上锁后的 Region 不会产生额外的数据写入，不再需要额外维护集群内不同 Store 和不同 Region 当前的 Flashback 成功失败状态，只需要无脑重试直到成功即可；</li>
  <li>Region 级别更符合 TiKV 内部数据管理的粒度。</li>
</ul>

<h4 id="大致流程">大致流程</h4>

<p>TiDB 首先会去判断：</p>

<ul>
  <li>FlashbackTS：是否是未来时间点，是否大于 minSafeTS，是否在 GC Safe time 内</li>
  <li>是否有非 Flashback ddl job 在时间范围内执行过</li>
  <li>是否有 DDL 任务正在执行</li>
  <li>关闭 GC，PD 调度和 auto analyze 然后开始调用 TiKV 的两阶段</li>
  <li><strong>第一阶段（Region 锁定）</strong>
    <ol>
      <li>TiDB 来确定执行 Flashback 请求的 key range；</li>
      <li>TiDB 以 region 为单位，向不同 region 发送 kv_prepare_flashback_to_version 请求，阻止读、写和调度；</li>
      <li>调用 PD 接口去拿最新的 TSO，作为执行 Flashback 的 startTS。TiDB 会持久化该 startTS，来保证 TiDB 在失败重启后也能使用相同 TS；</li>
      <li>用 Region 锁来让每个 Region 独立处理自己的 Flashback 进度
        <ul>
          <li>扫描所有的 MVCC Lock 并进行 rollback；</li>
          <li>TiKV 会在 CF_WRITE 中选择最新的 user key，并以上面提到的 startTS 先 Prewrite 上一个锁，停止 resolved_ts 的推进，将在第二阶段 Commit 上；</li>
        </ul>
      </li>
      <li>TiDB 检查所有请求是否成功返回，并重试失败请求，直到整个锁定阶段完成。</li>
    </ol>
  </li>
  <li><strong>第二阶段（执行 Flashback）</strong>
    <ol>
      <li>TiDB 取上面提到的 startTS，以及去 PD 拿最新的 TSO 作为 commitTS，TiDB 同样会持久化该 startTS，并向不同 region 发送 kv_flashback_to_version 请求 ；</li>
      <li>每个 Region 独立处理自己的 Flashback 进度
        <ul>
          <li>扫描出需要 Flashback 到的时间点以后有版本变化的键，为扫描出的键写上旧的 MVCC 版本；</li>
          <li>Commit 第一阶段中 Prewrite 写入的锁，并在完成后摘掉 Region 锁；</li>
        </ul>
      </li>
      <li>TiDB 检查所有请求是否成功返回，并以相同的 startTS 和 commitTS 重试那些失败的请求，直到整个 Flashback 执行完成。</li>
    </ol>
  </li>
</ul>

<h2 id="代码分析">代码分析</h2>

<p>让我们从 TiKV 启动开始说起 :)</p>

<p>从 cmd/tikv-server/main.rs 开始，TiKV 完成配置一系列参数后，main 函数末尾走到 server::run_tikv(config) 运行 TiKV server，通过 main 中所配置的参数选择对应 Engine，调用 run_impl 函数，在 run_server 中进行绑定，并启动 grpc_server.start(); 服务。具体的绑定启动流程可以查看<a href="https://cn.pingcap.com/blog/tikv-source-code-reading-7">此文档</a>。</p>

<p>本文关注的 Flashback 位于 <a href="https://github.com/pingcap/kvproto/blob/master/proto/tikvpb.proto#L20">kvproto</a> 对应的此处</p>

<div class="language-protobuf highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">rpc</span> <span class="n">KvPrepareFlashbackToVersion</span><span class="p">(</span><span class="n">kvrpcpb.PrepareFlashbackToVersionRequest</span><span class="p">)</span> <span class="k">returns</span> <span class="p">(</span><span class="n">kvrpcpb.PrepareFlashbackToVersionResponse</span><span class="p">)</span> <span class="p">{}</span>
<span class="k">rpc</span> <span class="n">KvFlashbackToVersion</span><span class="p">(</span><span class="n">kvrpcpb.FlashbackToVersionRequest</span><span class="p">)</span> <span class="k">returns</span> <span class="p">(</span><span class="n">kvrpcpb.FlashbackToVersionResponse</span><span class="p">)</span> <span class="p">{}</span>
</code></pre></div></div>

<p>回到 TiKV 代码，TiKV 包含多个 gRPC service。其中最重要的一个是 KvService，位于 src/server/service/kv.rs 文件中。包括 TiKV 的 kv_get，kv_scan，kv_prewrite，kv_commit 等事务操作的 API。本文 Flashback 由于采用事务模型，很自然地放在此文件中。</p>

<h3 id="流程概览">流程概览</h3>

<p>让我们先来纵览一下 Flashback 整体流程，抽出主要代码大致可以看出主要就是四步：</p>

<ol>
  <li>在开始正式的覆盖写等操作之前，先通过 raft_router 发送一个 Admin 的 PrepareFlashback 指令，完成 region meta 的持久化；</li>
  <li>在 region 被标识为 Flashback 状态后，prewrite 第一个 user_key 来阻止 resolved_ts 的推进；</li>
  <li>执行 Flashback并 commit 第 2 步写入的 key；</li>
  <li>Flashback 执行结束后通过 raft_router 发送一个 FinishFlashback 指令，进行数据清理。</li>
</ol>

<div class="language-rust highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="c1">// First Phase</span>
<span class="k">fn</span> <span class="nf">future_prepare_flashback_to_version</span><span class="p">()</span> <span class="p">{</span>
 <span class="c1">// 1. prepare the raftstore for the later flashback.</span>
 <span class="nf">send_flashback_msg</span><span class="p">(</span><span class="o">..</span><span class="p">,</span> <span class="nn">AdminCmdType</span><span class="p">::</span><span class="n">PrepareFlashback</span><span class="p">);</span>
 <span class="c1">// 2.prewrite the first user key to prevent `resolved_ts` from advancing.</span>
 <span class="k">let</span> <span class="p">(</span><span class="n">cb</span><span class="p">,</span> <span class="n">f</span><span class="p">)</span> <span class="o">=</span> <span class="nf">paired_future_callback</span><span class="p">();</span>
 <span class="n">res</span> <span class="o">=</span> <span class="n">storage</span><span class="nf">.sched_txn_command</span><span class="p">(</span><span class="n">req</span><span class="nf">.clone</span><span class="p">()</span><span class="nf">.into</span><span class="p">(),</span> <span class="n">cb</span><span class="p">);</span>
<span class="p">}</span>
<span class="c1">// Second Phase</span>
<span class="k">fn</span> <span class="nf">future_flashback_to_version</span><span class="p">()</span> <span class="p">{</span>
 <span class="c1">// 3. execute overwrite and commit the first user key.</span>
 <span class="k">let</span> <span class="p">(</span><span class="n">cb</span><span class="p">,</span> <span class="n">f</span><span class="p">)</span> <span class="o">=</span> <span class="nf">paired_future_callback</span><span class="p">();</span>
 <span class="k">let</span> <span class="n">res</span> <span class="o">=</span> <span class="n">storage_clone</span><span class="nf">.sched_txn_command</span><span class="p">(</span><span class="n">req</span><span class="nf">.into</span><span class="p">(),</span> <span class="n">cb</span><span class="p">);</span>
 <span class="c1">// 4. notify raftstore flashback has been finished.</span>
 <span class="nf">send_flashback_msg</span><span class="p">(</span><span class="o">..</span><span class="p">,</span> <span class="nn">AdminCmdType</span><span class="p">::</span><span class="n">FinishFlashback</span><span class="p">);</span>
<span class="p">}</span>
</code></pre></div></div>

<p>那就让我们首先进入第一阶段：prepare 模块！</p>

<h3 id="phase1-1-prepare">Phase1-1: Prepare</h3>

<p>Prepare 函数的目的可以概况为：停读停写停调度，持久化 Flashback 状态，停止 resolved_ts 的推进。</p>

<p>首先介绍“停读写停调度”，具体原因已经在背景介绍小节中解释过。为了实现这个目的，直觉上是在所有读写调度任务执行处进行隔断。由于 TiKV 底层采用 Raft 协议，最终会进行 Propose，Commit 然后 Apply 的流程，那么很自然地在进行 Propose 前隔断掉读写调度。</p>

<blockquote>
  <p>此处剧透 Flashback 实现为：在 Propose 处快速隔断掉 Flashback 过程中的其他读写，在 Apply 处隔断进行兜底。</p>
</blockquote>

<p>通过此文章可以了解到在 TiKV 处理 Proposal 的大致流程 <a href="https://cn.pingcap.com/blog/tikv-source-code-reading-18">TiKV 源码解析系列文章（十八）Raft Propose 的 Commit 和 Apply 情景分析</a></p>

<p>一言以蔽之：TiKV 使用了两个线程池来处理 Proposal，并且将一个 Raft Peer 分成了两部分：PeerFsm和 ApplyFsm。在处理 Proposal 的过程中，首先由 PeerFsm获取日志并驱动 Raft 内部的状态机，由 ApplyFsm根据已提交日志修改对应数据的状态机（region 信息和用户数据）。</p>

<blockquote>
  <p>可通过此文章了解 PeerFsm 和  ApplyFsm <a href="https://cn.pingcap.com/blog/tikv-source-code-reading-17">TiKV 源码解析系列文章（十七）raftstore 概览</a></p>
</blockquote>

<p>在 “PeerFsm获取日志并驱动 Raft 内部的状态机”时，会走到下面函数：</p>

<div class="language-rust highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">fn</span> <span class="nf">propose_raft_command_internal</span><span class="p">()</span> <span class="p">{</span>
 <span class="k">match</span> <span class="k">self</span><span class="nf">.pre_propose_raft_command</span><span class="p">(</span><span class="o">&amp;</span><span class="n">msg</span><span class="p">)</span> <span class="p">{</span> <span class="o">..</span> <span class="p">}</span>

 <span class="k">if</span> <span class="k">self</span><span class="py">.fsm.peer</span><span class="nf">.propose</span><span class="p">(</span><span class="k">self</span><span class="py">.ctx</span><span class="p">,</span> <span class="n">cb</span><span class="p">,</span> <span class="n">msg</span><span class="p">,</span> <span class="n">resp</span><span class="p">,</span> <span class="n">diskfullopt</span><span class="p">)</span> <span class="p">{</span>
     <span class="k">self</span><span class="py">.fsm.has_ready</span> <span class="o">=</span> <span class="k">true</span><span class="p">;</span>
 <span class="p">}</span>
<span class="p">}</span>
</code></pre></div></div>

<p>我们发现 PeerFsmDelegate::pre_propose_raft_command 函数会在 propose request 前进行检查。</p>

<p>那么很自然地将判断当前 request 是否为 Flashback 的检查放在此处。</p>

<p>需要关注的一个地方是：</p>

<p>当然不能全盘隔断，Flashback 也需要走 raft 流程，应当给予通行证。</p>

<p>随之我们发现在 RaftCmdRequest 中的 header 里面有个 flags，可以将通行证放在此处。</p>

<div class="language-rust highlighter-rouge"><div class="highlight"><pre class="highlight"><code> <span class="k">fn</span> <span class="nf">pre_propose_raft_command</span><span class="p">(</span>
     <span class="o">&amp;</span><span class="k">mut</span> <span class="k">self</span><span class="p">,</span>
     <span class="n">req</span><span class="p">:</span> <span class="o">&amp;</span><span class="n">RaftCmdRequest</span><span class="p">,</span>
 <span class="p">)</span> <span class="k">-&gt;</span> <span class="nb">Result</span><span class="o">&lt;</span><span class="nb">Option</span><span class="o">&lt;</span><span class="n">RaftCmdResponse</span><span class="o">&gt;&gt;</span> <span class="p">{</span>
     <span class="c1">// When in the flashback state, we should not allow any other request to be proposed.</span>
     <span class="k">if</span> <span class="k">self</span><span class="nf">.region</span><span class="p">()</span><span class="py">.is_in_flashback</span> <span class="p">{</span>
         <span class="k">let</span> <span class="n">flags</span> <span class="o">=</span> <span class="n">req</span><span class="nf">.get_header</span><span class="p">()</span><span class="nf">.get_flags</span><span class="p">();</span>
         <span class="k">if</span> <span class="o">!</span><span class="n">flags</span><span class="nf">.contains</span><span class="p">(</span><span class="n">FLASHBACK</span><span class="p">)</span> <span class="p">{</span>
             <span class="k">return</span> <span class="nb">Err</span><span class="p">;</span>
         <span class="p">}</span>
     <span class="p">}</span>
 <span class="p">}</span>
</code></pre></div></div>

<h4 id="prepare-flashback">Prepare Flashback</h4>

<p>在完成“隔断点”的安插后，为了让 Flashback 相关操作不受隔断顺利通行，我们会在 header 处加上 flag。</p>

<div class="language-rust highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="c1">// First Phase</span>
<span class="k">fn</span> <span class="n">future_prepare_flashback_to_version</span><span class="p">{</span>
 <span class="c1">// 1. prepare the raftstore for the later flashback. </span>
 <span class="nf">send_flashback_msg</span><span class="p">(</span><span class="o">..</span><span class="p">,</span> <span class="nn">AdminCmdType</span><span class="p">::</span><span class="n">PrepareFlashback</span><span class="p">);</span>
<span class="p">}</span>
</code></pre></div></div>

<p>所调用的 start_flashback/end_flashback 函数在加上 flag 后发送 admin req.</p>

<div class="language-rust highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">async</span> <span class="k">fn</span> <span class="n">start_flashback</span><span class="o">/</span><span class="n">end_flashback</span> <span class="p">{</span>
 <span class="o">...</span>
 <span class="n">req</span><span class="nf">.mut_header</span><span class="p">()</span>
     <span class="nf">.set_flags</span><span class="p">(</span><span class="nn">WriteBatchFlags</span><span class="p">::</span><span class="n">FLASHBACK</span><span class="nf">.bits</span><span class="p">());</span>
 <span class="c1">// call admin request directly</span>
 <span class="k">let</span> <span class="n">raft_router</span> <span class="o">=</span> <span class="n">raft_router</span><span class="nf">.lock</span><span class="p">()</span><span class="k">.await</span><span class="p">;</span>
 <span class="n">raft_router</span><span class="nf">.send_command</span><span class="p">(</span><span class="n">req</span><span class="p">,</span> <span class="n">cb</span><span class="p">,</span> <span class="o">...</span><span class="p">)</span>
 <span class="o">...</span>
<span class="p">}</span>
</code></pre></div></div>

<p>Admin request 通过 RaftStoreRouter 构成一条 RaftCommand 发送，会按照 Propose 流程，通过 pre_propose 的检查后到 PeerFsmDelegate.fsm.peer.propose 完成 Propose 一条 Raft Log。</p>

<p>之后 PeerFsm 会将 Proposal 以及已提交日志发送给对应的 ApplyFsm 来到 apply 流程。</p>

<p>ApplyFsm 会针对这些日志进行（见 ApplyFsm::handle_apply）：</p>

<ol>
  <li>完成数据的持久化。</li>
  <li>向 PeerFsm发送 ApplyRes，用于更新 PeerFsm中的 Region 状态。
 在 exec_raft_cmd 会加上 check_flashback_state，进行 Flashback 持久态的判断。此处 region 将在下面的 exec 函数中设置上，由于为串行 apply，因此在下条 cmd 来之前，便会设置好 region 信息。</li>
</ol>

<div class="language-rust highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="nf">check_flashback_state</span><span class="p">(</span><span class="k">self</span><span class="py">.region</span><span class="nf">.get_is_in_flashback</span><span class="p">());</span>

<span class="k">pub</span> <span class="k">fn</span> <span class="nf">check_flashback_state</span><span class="p">()</span> <span class="k">-&gt;</span> <span class="nb">Result</span><span class="o">&lt;</span><span class="p">()</span><span class="o">&gt;</span> <span class="p">{</span>
    <span class="c1">// The admin flashback cmd could be proposed/applied under any state.</span>
    <span class="k">if</span> <span class="nn">AdminCmdType</span><span class="p">::</span><span class="n">PrepareFlashback</span> <span class="p">||</span> <span class="nn">AdminCmdType</span><span class="p">::</span><span class="n">FinishFlashback</span> <span class="p">{</span>
        <span class="k">return</span> <span class="nf">Ok</span><span class="p">(());</span>
    <span class="p">}</span>
    <span class="k">let</span> <span class="n">is_flashback_request</span> <span class="o">=</span> <span class="n">req</span><span class="nf">.get_header</span><span class="p">()</span><span class="nf">.get_flags</span><span class="p">()</span>
                            <span class="nf">.contains</span><span class="p">(</span><span class="n">FLASHBACK</span><span class="p">);</span>
    <span class="o">...</span>
<span class="p">}</span>
</code></pre></div></div>

<p>完成 check 后执行 ApplyDelegate::exec_admin_cmd ，最终识别 Flashback 标识，到达我们的目的地 exec_flashback 函数。</p>

<div class="language-rust highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="nn">AdminCmdType</span><span class="p">::</span><span class="n">PrepareFlashback</span> <span class="p">|</span> <span class="nn">AdminCmdType</span><span class="p">::</span><span class="n">FinishFlashback</span> <span class="k">=&gt;</span> 
    <span class="k">self</span><span class="nf">.exec_flashback</span><span class="p">(</span><span class="n">ctx</span><span class="p">,</span> <span class="n">request</span><span class="p">),</span>
</code></pre></div></div>

<p>exec_flashback 放入 region 的元信息中，并完成持久态 RegionLocalState 的更新。</p>

<div class="language-rust highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">fn</span> <span class="nf">exec_flashback</span><span class="p">()</span> <span class="k">-&gt;</span> <span class="nb">Result</span><span class="o">&lt;&gt;</span> <span class="p">{</span>
    <span class="k">let</span> <span class="n">is_in_flashback</span> <span class="o">=</span> <span class="n">req</span><span class="nf">.get_cmd_type</span><span class="p">()</span> <span class="o">==</span> <span class="nn">AdminCmdType</span><span class="p">::</span><span class="n">PrepareFlashback</span><span class="p">;</span>
    <span class="k">let</span> <span class="k">mut</span> <span class="n">region</span> <span class="o">=</span> <span class="k">self</span><span class="py">.region</span><span class="nf">.clone</span><span class="p">();</span>
    <span class="n">region</span><span class="nf">.set_is_in_flashback</span><span class="p">(</span><span class="n">is_in_flashback</span><span class="p">);</span>


    <span class="nf">put_msg_cf</span><span class="p">(</span><span class="n">CF_RAFT</span><span class="p">,</span> <span class="o">&amp;</span><span class="nn">keys</span><span class="p">::</span><span class="nf">region_state_key</span><span class="p">(</span><span class="n">region_id</span><span class="p">),</span> <span class="o">&amp;</span><span class="n">old_state</span><span class="p">)</span>
    <span class="nf">Ok</span><span class="p">(</span><span class="nn">ApplyResult</span><span class="p">::</span><span class="nf">Res</span><span class="p">(</span><span class="nn">ExecResult</span><span class="p">::</span><span class="n">SetFlashbackState</span> <span class="p">{</span> <span class="n">region</span> <span class="p">}</span> <span class="p">)</span>
<span class="p">}</span>
</code></pre></div></div>

<p>ApplyFSM 在应用一批日志之后会发送一条 ApplyRes 的消息到 PeerFsm。</p>

<p>最终又回到 PeerFsm 的PeerFsmDelegate::handle_msgs 函数，走到 PeerMsg::ApplyRes { res } 分支，调用 PeerFsmDelegate::on_apply_res 完成对 Flashback 的持久态更新。</p>

<div class="language-rust highlighter-rouge"><div class="highlight"><pre class="highlight"><code>    <span class="k">fn</span> <span class="nf">on_set_flashback_state</span><span class="p">(</span><span class="o">&amp;</span><span class="k">mut</span> <span class="k">self</span><span class="p">,</span> <span class="n">is_in_flashback</span><span class="p">:</span> <span class="nb">bool</span><span class="p">)</span> <span class="p">{</span>
        <span class="c1">// update flashback state</span>
        <span class="k">self</span><span class="nf">.update_region</span><span class="p">();</span>
        <span class="c1">// 此行代码在做的事将在「停读 - ReadLocal &amp; StaleRead 」小节解释</span>
        <span class="k">self</span><span class="py">.fsm.peer</span><span class="nf">.leader_lease_mut</span><span class="p">()</span><span class="nf">.expire_remote_lease</span><span class="p">();</span>
    <span class="p">}</span>
</code></pre></div></div>

<p>梳理完后，很清晰的看到存在两个对非 Flashback 操作的隔断位置，分别位于 propose 和 apply 处。</p>

<p>那么随之而来的问题便是：在何处加入对 Flashback req 的“通行证”呢？</p>

<p>Flashback 既然可以理解为基于 MVCC 进行实现，那么便也需要通过 MVCC 的读写接口流程。因此溯源一下 MVCC 的读写流程，便能更好地找到“通行证”的放置位置。</p>

<h4 id="停读">停读</h4>

<p>让我们首先来梳理一下读流程，可结合 <a href="https://cn.pingcap.com/blog/tikv-source-code-reading-read">TiKV 源码阅读三部曲（二）读流程 来阅读详细读过程</a>。</p>

<p>在调用到 LocalReader::propose_raft_command 时，发现是通过 LocalReader::pre_propose_raft_command 进行判断 req。</p>

<p>会对 ReadLocal 和 StaleRead 进行特定逻辑处理，其余信息将转发给 RaftStore 来执行，即由 ProposalRouter::send 转发后走到我们之前所提到的 Propose 流程。</p>

<div class="language-rust highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">fn</span> <span class="nf">propose_raft_command</span><span class="p">()</span> <span class="p">{</span>
    <span class="k">match</span> <span class="k">self</span><span class="nf">.pre_propose_raft_command</span><span class="p">(</span><span class="o">&amp;</span><span class="n">req</span><span class="p">)</span> <span class="p">{</span> 
        <span class="nn">RequestPolicy</span><span class="p">::</span><span class="n">ReadLocal</span> <span class="k">=&gt;</span> <span class="o">..</span>
        <span class="nn">RequestPolicy</span><span class="p">::</span><span class="n">StaleRead</span> <span class="k">=&gt;</span> <span class="o">..</span>
        <span class="c1">// Forward to raftstore.</span>
        <span class="n">_</span> <span class="k">=&gt;</span> <span class="k">self</span><span class="nf">.redirect</span><span class="p">(</span><span class="nn">RaftCommand</span><span class="p">::</span><span class="nf">new</span><span class="p">(</span><span class="n">req</span><span class="p">,</span> <span class="n">cb</span><span class="p">)),</span>     
    <span class="p">}</span>
<span class="p">}</span>
</code></pre></div></div>

<p>这样很自然地对于除 ReadLocal 和 StaleRead 外的 req，都可以做出以下隔断：</p>

<p>在进入 read 之前，判断一下 req 中是否有 Flashback flag，便实现了在开启 Flashback 之后，只能让 Flashback 相关的读指令通行。</p>

<div class="language-rust highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">fn</span> <span class="nf">exec_snapshot</span><span class="p">()</span> <span class="p">{</span>
    <span class="o">...</span>
    <span class="k">if</span> <span class="n">ctx</span><span class="py">.for_flashback</span> <span class="p">{</span>
        <span class="n">flags</span> <span class="p">|</span><span class="o">=</span> <span class="nn">WriteBatchFlags</span><span class="p">::</span><span class="n">FLASHBACK</span><span class="nf">.bits</span><span class="p">();</span>
    <span class="p">}</span>
    <span class="n">header</span><span class="nf">.set_flags</span><span class="p">(</span><span class="n">flags</span><span class="p">);</span>
    <span class="o">...</span>
    <span class="k">self</span><span class="py">.router</span><span class="nf">.read</span><span class="p">(</span><span class="o">...</span><span class="p">)</span>
<span class="p">}</span>
</code></pre></div></div>

<p>Flashback 执行时将对 exec_snapshot 进行 ctx.for_flashback 的设置，其中 for_flashback 从哪获取的将在下文 「Phase2-1: Exec - 读取阶段」 解释。</p>

<h4 id="readlocal--staleread">ReadLocal &amp; StaleRead</h4>

<p>正如上小节提到会对 ReadLocal 和 StaleRead 存在着特定逻辑处理，可以作为扩展阅读资料了解 <a href="https://cn.pingcap.com/blog/lease-read">TiKV 功能介绍 - Lease Read</a> &amp;&amp; <a href="https://docs.pingcap.com/zh/tidb/dev/stale-read">Stale Read 功能的使用场景</a>。</p>

<p>首先看看ReadLocal 的特殊处理即对 Peer 中的 leader_lease 进行检查。当发现不在租期内时，便会转发到正常 Propose 流程中。</p>

<p>因此我们采取：在 prepare Flashback 时，对 lease 手动设置超时，来确保 local read 不会执行。</p>

<p>这便是对之前完成 apply res 之后与更新 region 同时所做的事。</p>

<div class="language-rust highlighter-rouge"><div class="highlight"><pre class="highlight"><code>    <span class="k">fn</span> <span class="nf">on_set_flashback_state</span><span class="p">(</span><span class="o">&amp;</span><span class="k">mut</span> <span class="k">self</span><span class="p">,</span> <span class="n">is_in_flashback</span><span class="p">:</span> <span class="nb">bool</span><span class="p">)</span> <span class="p">{</span>
        <span class="c1">// Update the region meta.</span>
        <span class="k">self</span><span class="nf">.update_region</span><span class="p">()</span>
        <span class="c1">// Let the leader lease to None to ensure that local reads are not executed.</span>
        <span class="k">self</span><span class="py">.fsm.peer</span><span class="nf">.leader_lease_mut</span><span class="p">()</span><span class="nf">.expire_remote_lease</span><span class="p">();</span>
    <span class="p">}</span>
</code></pre></div></div>

<p>而对于 StaleRead 的运行前提是需要不停推进 safe ts（即 resolved_ts）。会在 TiDB 检查 resolved_ts，保证 Flashback 的版本不会超过 resolved_ts，因此也完成隔断。</p>

<p>至此对于读的隔断介绍完毕。</p>

<h4 id="停写">停写</h4>

<p>可参考 <a href="https://cn.pingcap.com/blog/tikv-source-code-reading-write">TiKV 源码阅读三部曲（三）写流程</a> 阅读写请求全链路的执行流程。</p>

<p>在写的过程中 RaftKv::exec_write_requests 内部将会走向 router 进行 Propose 流程，因此在此处加上类似上文「读请求」的判断，只能让 Flashback 相关的写指令通行。</p>

<div class="language-rust highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">fn</span> <span class="nf">exec_write_requests</span><span class="p">()</span> <span class="p">{</span>
    <span class="o">...</span>
    <span class="k">if</span> <span class="n">txn_extra</span><span class="py">.for_flashback</span> <span class="p">{</span>
        <span class="n">flags</span> <span class="p">|</span><span class="o">=</span> <span class="nn">WriteBatchFlags</span><span class="p">::</span><span class="n">FLASHBACK</span><span class="nf">.bits</span><span class="p">();</span>
    <span class="p">}</span>
    <span class="n">header</span><span class="nf">.set_flags</span><span class="p">(</span><span class="n">flags</span><span class="p">);</span>
    <span class="o">...</span>
    <span class="k">self</span><span class="py">.router</span><span class="nf">.send_command</span><span class="p">(</span><span class="n">cmd</span><span class="p">,</span> <span class="n">cb</span><span class="p">,</span> <span class="n">extra_opts</span><span class="p">)</span><span class="o">?</span><span class="p">;</span>
<span class="p">}</span>
</code></pre></div></div>

<h3 id="phase1-2-prewrite">Phase1-2: Prewrite</h3>

<p>完成停读写调度后，我们遇到了一个新的问题，那就是持续推进的 resolved ts 会导致 CDC 的 Panic.</p>

<h4 id="停止-resolved-_ts-的推进">停止 resolved _ts 的推进</h4>

<p>一言蔽之 Resolved TS（TODO: 介绍 Resolved TS），由于以下原因：</p>

<ul>
  <li>
    <p>Resolved TS 组件通过观察 LockCF 的修改，维护一个 StartTS 的最小堆，有 ResolvedTS = max(ResolvedTS, min(StartTS))；</p>
  </li>
  <li>
    <p>Flashback 将以 Region 为单位移除掉所有的锁；</p>
  </li>
  <li>
    <p>正在进行 Flashback 的 Region 上将不再存在任何的锁，此时 ResolvedTS 将会正常向前推进，无论是否有数据写入。</p>
  </li>
</ul>

<p>那么将会带来：改动的 CommitTS &lt;  ResolvedTS 的情况（Flashback 的改动自始至终都使用同一个 CommitTS，ResolvedTS 随着推进迟早会超过它）。</p>

<p>为防止 resolved_ts 在我们后续执行 Flashback 前被推进，我们采用：TiDB 请求中带上一个 start_ts，TiKV 会在 CF_WRITE 中选择最新的 user key，以此 start_ts prewrite 上一个锁，将在执行完 Flashback 后 commit 清除掉。</p>

<h4 id="读写阶段介绍">读写阶段介绍</h4>

<p>回到最开始的 future_prepare_flashback_to_version 中，首先内部将 req.into。</p>

<div class="language-rust highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="c1">// First Phase</span>
<span class="k">fn</span> <span class="n">future_prepare_flashback_to_version</span><span class="p">{</span>
    <span class="o">...</span>
    <span class="k">let</span> <span class="n">res</span> <span class="o">=</span> <span class="n">storage_clone</span><span class="nf">.sched_txn_command</span><span class="p">(</span><span class="n">req</span><span class="nf">.into</span><span class="p">(),</span> <span class="n">cb</span><span class="p">);</span>
    <span class="o">...</span> 
<span class="p">}</span>
</code></pre></div></div>

<p>在此文件中实现了 PrepareFlashbackToVersionRequest 到 FlashbackToVersionReadPhase 的 from。</p>

<div class="language-rust highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">impl</span> <span class="nb">From</span><span class="o">&lt;</span><span class="n">PrepareFlashbackToVersionRequest</span><span class="o">&gt;</span> <span class="k">for</span> <span class="n">TypedCommand</span><span class="o">&lt;</span><span class="p">()</span><span class="o">&gt;</span> <span class="p">{</span>
    <span class="k">fn</span> <span class="nf">from</span><span class="p">(</span><span class="k">mut</span> <span class="n">req</span><span class="p">:</span> <span class="n">PrepareFlashbackToVersionRequest</span><span class="p">)</span> <span class="k">-&gt;</span> <span class="k">Self</span> <span class="p">{</span>
        <span class="n">FlashbackToVersionReadPhase</span> <span class="p">{</span> <span class="o">..</span> <span class="p">}</span>
    <span class="p">}</span>
<span class="p">}</span>
</code></pre></div></div>

<p>因此此处调度的实则是 FlashbackToVersionReadPhase，也即对于 sched_txn_command 将会走到由 FlashbackToVersionReadPhase 提供的 process_read 处，在执行完该函数后会触发 FlashbackToVersion 的 process_write。</p>

<div class="language-rust highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">fn</span> <span class="nf">process_read</span><span class="p">(</span><span class="k">self</span><span class="p">,</span> <span class="n">snapshot</span><span class="p">:</span> <span class="n">S</span><span class="p">,</span> <span class="n">statistics</span><span class="p">:</span> <span class="o">&amp;</span><span class="k">mut</span> <span class="n">Statistics</span><span class="p">)</span> <span class="k">-&gt;</span> <span class="nb">Result</span><span class="o">&lt;</span><span class="n">ProcessResult</span><span class="o">&gt;</span> <span class="p">{</span>
    <span class="o">...</span>
    <span class="k">let</span> <span class="n">next_cmd</span> <span class="o">=</span> <span class="n">FlashbackToVersion</span> <span class="p">{</span>
        <span class="o">...</span>
    <span class="p">}</span>
    <span class="nf">Ok</span><span class="p">(</span><span class="nn">ProcessResult</span><span class="p">::</span><span class="n">NextCommand</span> <span class="p">{</span>
        <span class="n">cmd</span><span class="p">:</span> <span class="nn">Command</span><span class="p">::</span><span class="nf">FlashbackToVersion</span><span class="p">(</span><span class="n">next_cmd</span><span class="p">),</span>
    <span class="p">})</span>
<span class="p">}</span>
</code></pre></div></div>

<p>大致流程按照如此往复读写读写，直到没有读为止。</p>

<p>由于都是属于 Flashback 操作，需要加上「通行证」后才能被 raftstore 执行。</p>

<p>因此也很合理地在 process_write 加上 Write 的通行证。</p>

<div class="language-rust highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">fn</span> <span class="nf">process_write</span><span class="p">(</span><span class="k">mut</span> <span class="k">self</span><span class="p">,</span> <span class="n">snapshot</span><span class="p">:</span> <span class="n">S</span><span class="p">,</span> <span class="n">context</span><span class="p">:</span> <span class="n">WriteContext</span><span class="o">&lt;</span><span class="nv">'_</span><span class="p">,</span> <span class="n">L</span><span class="o">&gt;</span><span class="p">)</span> <span class="k">-&gt;</span> <span class="nb">Result</span><span class="o">&lt;</span><span class="n">WriteResult</span><span class="o">&gt;</span> <span class="p">{</span>
    <span class="o">...</span>
    <span class="n">write_data</span><span class="py">.extra.for_flashback</span> <span class="o">=</span> <span class="k">true</span><span class="p">;</span>
    <span class="o">...</span>
    <span class="k">if</span> <span class="n">next_lock_key</span><span class="nf">.is_none</span><span class="p">()</span> <span class="o">&amp;&amp;</span> <span class="n">next_write_key</span><span class="nf">.is_none</span><span class="p">()</span> <span class="p">{</span>    
        <span class="o">...</span>
    <span class="p">}</span> <span class="k">else</span> <span class="p">{</span>
        <span class="k">let</span> <span class="n">next_cmd</span> <span class="o">=</span> <span class="n">FlashbackToVersionReadPhase</span> <span class="p">{</span>
            <span class="o">...</span>
        <span class="p">}</span>
    <span class="p">}</span>
<span class="p">}</span>
</code></pre></div></div>

<p>而对于 process_read，由于是从 snapshot 中读取，因此会在读取 snapshot 时加上 Read 的通行证。</p>

<div class="language-rust highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">fn</span> <span class="nf">exec_snapshot</span><span class="p">()</span> <span class="p">{</span>
    <span class="o">...</span>
    <span class="k">if</span> <span class="n">ctx</span><span class="py">.for_flashback</span> <span class="p">{</span>
        <span class="n">flags</span> <span class="p">|</span><span class="o">=</span> <span class="nn">WriteBatchFlags</span><span class="p">::</span><span class="n">FLASHBACK</span><span class="nf">.bits</span><span class="p">();</span>
    <span class="p">}</span>
    <span class="o">...</span>
    <span class="k">self</span><span class="py">.router</span><span class="nf">.read</span><span class="p">(</span> <span class="o">...</span> <span class="p">)</span>
<span class="p">}</span>
</code></pre></div></div>

<p>这也便实现了在「停读停写」后能顺利执行 flashback 相关操作。</p>

<p>具体到往复读写的过程，代码位于此处。为了流程更加清晰，我们标识出当前状态：</p>

<ol>
  <li><strong>RollbackLock</strong>：需要删除所有 start_ts 大于 Flashback version 的锁记录；
    <ul>
      <li>由于 Flashback 会把悲观锁清掉，但是清掉之后事务 commit 还是会成功的，阻止的方法是在 Flashback 删掉锁的时候，原地写 Rollback ；</li>
      <li>Rollback lock ：采用 lock 的 start_ts 写 Rollback 记录，确保时间戳会在 Flashback 之前。</li>
    </ul>
  </li>
  <li><strong>Prewrite</strong>：
    <ul>
      <li>TiDB 请求中会带上一个 start_ts， TiKV 会在需要 Flashback 的 key 中选择第一个 key，以此 start_ts 写入一个锁，以防止 resolved_ts 在我们后续进行 Flashback 前被推进。</li>
    </ul>
  </li>
  <li><strong>FlashbackWrite</strong>：
    <ul>
      <li>采用攒够一整个 batch 的方式扫描一批（256个）的 CF_WRITE；</li>
      <li>为了 Flashback 数据，我们需要从 CF_WRITE 中扫描每一个最新且独特的 key，来获得 Flashback timestamp 所对应的旧 MVCC 写记录。具体代码在此处；</li>
      <li>需要覆写一份 MvccTxn 对象的 Modify 记录，取出读取阶段的数据进行判断：</li>
    </ul>
    <ul>
      <li>如果 key 不存在对应的 version，将放置一个 Delete 标识；</li>
      <li>如果 key 存在对应的 version，且如果「不是采用 short_val，并为 LockType::Put」 ，那么将：
        <ul>
          <li>通过 load_data 获取 old version value，以 start_ts 构建 Modify，放在 CF_DEFAULT 中；</li>
          <li>通过 commit_ts 构建 Modify，放在 CF_WRITE 中。</li>
        </ul>
      </li>
    </ul>
  </li>
  <li><strong>Commit</strong>：
    <ul>
      <li>当发现已经完成所有 Write 的写入后，进入 Commit 阶段，通过 commit_flashback_key Commit first user key。</li>
    </ul>
  </li>
</ol>

<h3 id="phase2-1-exec--commit">Phase2-1: Exec &amp; Commit</h3>

<p>正如 「停止 resolved _ts 的推进」小节中描述的一样，大致流程如下：</p>

<ol>
  <li>Prepare Flashback 时：
    <ol>
      <li>Scan &amp; Rollback all locks.</li>
      <li>TiDB 请求中会带上一个 start_ts， TiKV 会在需要 Flashback 的 key 中选择第一个 key，以此 start_ts 写入一个锁，以防止 resolved_ts 在我们后续进行 Flashback 前被推进。</li>
    </ol>
  </li>
  <li>执行 Flashback 时：
    <ol>
      <li>Scan &amp; flashback the writes.
        <ul>
          <li>这部分的改动会带上 1PC 的 flag，让 CDC 等工具将其视为一阶段事务的修改</li>
        </ul>
      </li>
      <li>commit 在 1.b 中写入的锁，完成 Flashback</li>
    </ol>
  </li>
</ol>

<p>回到最开始的 future_flashback_to_version 中，也会内部进行 req.into 后走到 FlashbackToVersionReadPhase 和 FlashbackToVersion 进行读写，大致流程在「读写阶段介绍」小节已经详细介绍，就不再赘述。</p>

<h3 id="phase2-2-finish">Phase2-2: Finish</h3>

<p>在执行完成 Flashback 后，最后需要做的便是 unset 掉所有为 Flashback 服务的配置。那么便回到了经典 future_flashback_to_version 函数。</p>

<div class="language-rust highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">fn</span> <span class="nf">future_flashback_to_version</span><span class="p">()</span> <span class="k">-&gt;</span> <span class="k">impl</span> <span class="n">Future</span><span class="o">&lt;</span><span class="n">Output</span> <span class="o">=</span> <span class="n">ServerResult</span><span class="o">&lt;</span><span class="n">FlashbackToVersionResponse</span><span class="o">&gt;&gt;</span> <span class="p">{</span>
    <span class="o">...</span>
    <span class="c1">// 3. notify raftstore the flashback has been finished</span>
    <span class="n">raft_router_clone</span><span class="nf">.significant_send</span><span class="p">(</span><span class="n">region_id</span><span class="p">,</span> <span class="nn">SignificantMsg</span><span class="p">::</span><span class="n">FinishFlashback</span><span class="p">)</span><span class="o">?</span><span class="p">;</span>
<span class="p">}</span>
</code></pre></div></div>

<p>流程与 Prepare 大致相同，发送 Admin 指令，完成持久态的取缔。</p>

<p>至此，完成整个 Flashback！</p>

<h2 id="appendix">Appendix</h2>

<h3 id="一些踩过的坑">一些踩过的坑</h3>

<p><code class="language-plaintext highlighter-rouge">TODO</code></p>

<h3 id="改进点">改进点</h3>

<p>现有机制在可用性和易用性上有一些不足：</p>

<ul>
  <li>相关操作仅限于数据被 GC 回收之前，这个窗口期可能比较小，一旦 safepoint 更新过了之后就不能用了；</li>
  <li>如果把 GC lifetime 调长，历史数据将占用大量的存储空间；</li>
  <li>GC lifetime 是全局配置，不能针对某些 database 或 table 调整；</li>
</ul>

<h3 id="参考文档">参考文档</h3>

<p><a href="https://cn.pingcap.com/blog/tikv-source-code-reading-read">TiKV 源码阅读三部曲（二）读流程 来阅读详细读过程</a></p>

<p><a href="https://cn.pingcap.com/blog/tikv-source-code-reading-write">TiKV 源码阅读三部曲（三）写流程</a></p>

<p><a href="https://cn.pingcap.com/blog/tikv-source-code-reading-7">TiKV 源码解析系列文章（七）gRPC Server 的初始化和启动流程</a></p>

<p><a href="https://cn.pingcap.com/blog/tikv-source-code-reading-12/">TiKV 源码解析系列文章（十二）分布式事务</a></p>

<p><a href="https://cn.pingcap.com/blog/tikv-source-code-reading-13">TiKV 源码解析系列文章（十三）MVCC 数据读取</a></p>

<p><a href="https://cn.pingcap.com/blog/tikv-source-code-reading-17">TiKV 源码解析系列文章（十七）raftstore 概览</a></p>

<p><a href="https://cn.pingcap.com/blog/tikv-source-code-reading-18">TiKV 源码解析系列文章（十八）Raft Propose 的 Commit 和 Apply 情景分析</a></p>]]></content><author><name></name></author><category term="distributed" /></entry><entry><title type="html">自己动手画 CPU《计算机组织与结构实验》（四）</title><link href="/cpu/2020/11/13/hust-cpu-study_4.html" rel="alternate" type="text/html" title="自己动手画 CPU《计算机组织与结构实验》（四）" /><published>2020-11-13T10:00:52+00:00</published><updated>2020-11-13T10:00:52+00:00</updated><id>/cpu/2020/11/13/hust-cpu-study_4</id><content type="html" xml:base="/cpu/2020/11/13/hust-cpu-study_4.html"><![CDATA[<ul id="markdown-toc">
  <li><a href="#四处理器设计实验" id="markdown-toc-四处理器设计实验">四、处理器设计实验</a>    <ul>
      <li><a href="#前置背景知识" id="markdown-toc-前置背景知识">前置背景知识</a>        <ul>
          <li><a href="#介绍单总线双总线三总线数据通路" id="markdown-toc-介绍单总线双总线三总线数据通路">介绍单总线、双总线、三总线数据通路</a></li>
          <li><a href="#数据通路-与-cpu-结构之间的关系" id="markdown-toc-数据通路-与-cpu-结构之间的关系">数据通路 与 CPU 结构之间的关系</a></li>
        </ul>
      </li>
      <li><a href="#一单周期-mips-cpu设计" id="markdown-toc-一单周期-mips-cpu设计">一、单周期 MIPS CPU设计</a>        <ul>
          <li><a href="#1r-型" id="markdown-toc-1r-型">1、R 型</a></li>
          <li><a href="#2i-型" id="markdown-toc-2i-型">2、I 型</a></li>
          <li><a href="#3syscall" id="markdown-toc-3syscall">3、Syscall</a></li>
        </ul>
      </li>
      <li><a href="#二单周期硬布线控制器" id="markdown-toc-二单周期硬布线控制器">二、单周期硬布线控制器</a></li>
      <li><a href="#三mips-微程序-cpu-设计" id="markdown-toc-三mips-微程序-cpu-设计">三、MIPS 微程序 CPU 设计</a></li>
    </ul>
  </li>
</ul>

<p><a href="https://www.icourse163.org/course/HUST-1205809816">配套慕课</a></p>

<h2 id="四处理器设计实验">四、处理器设计实验</h2>

<h3 id="前置背景知识">前置背景知识</h3>

<p><img src="/assets/blog_image/2020-11-13-hust-cpu-study_4/image-20201114110538633.png" alt="image-20201114110538633" /></p>

<p>首先介绍<strong>数据通路</strong></p>

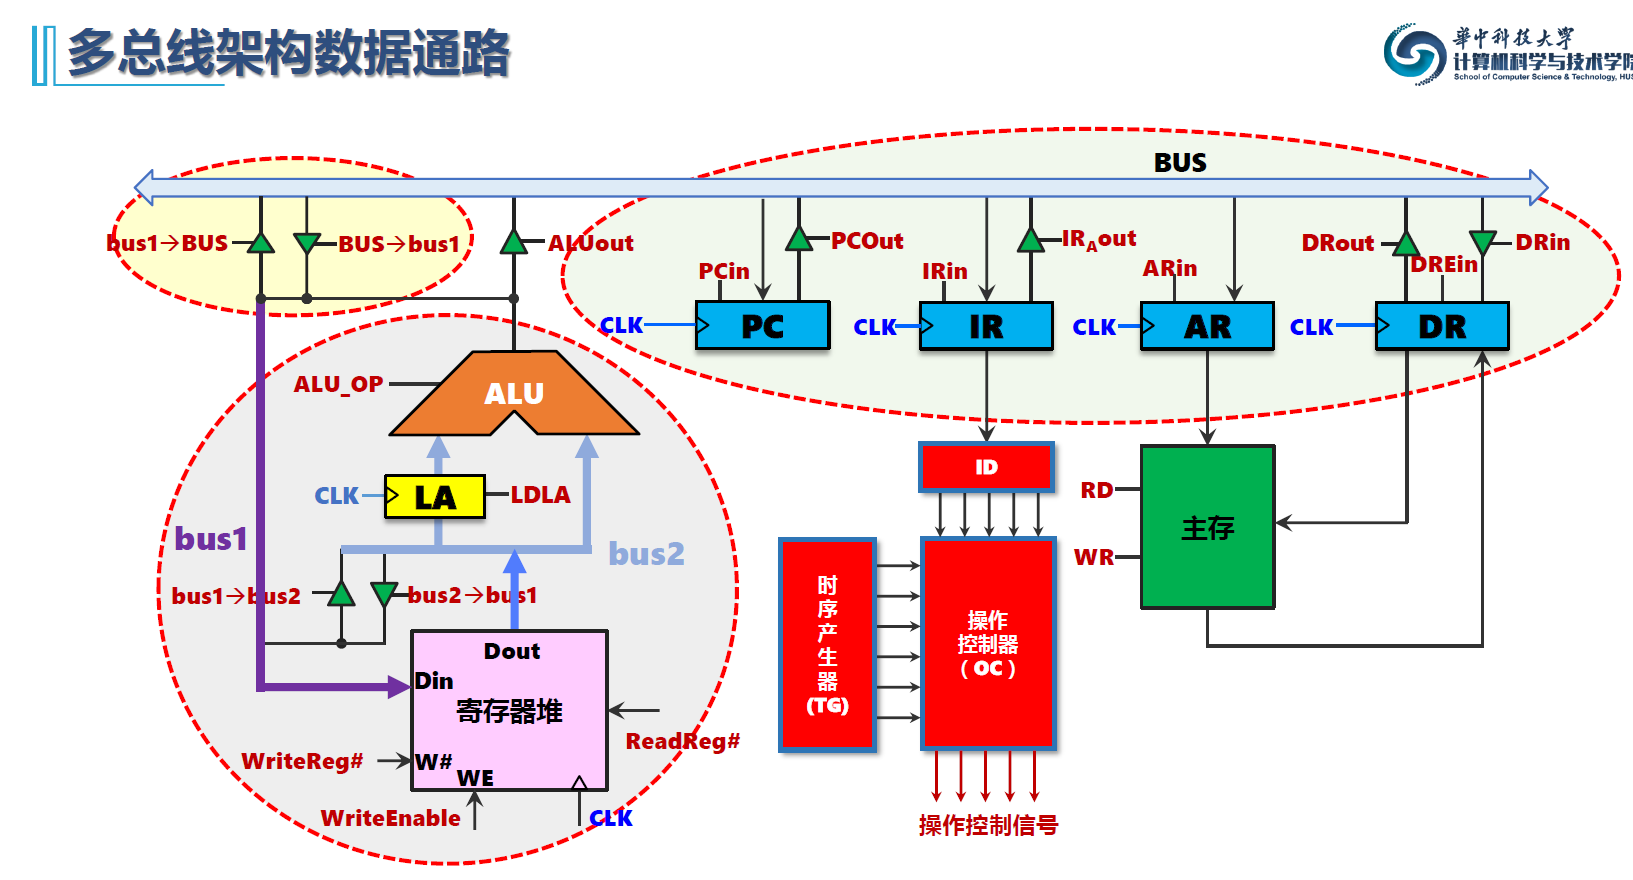
<p><img src="/assets/blog_image/2020-11-13-hust-cpu-study_4/image-20201114104952804.png" alt="image-20201114104952804" /></p>

<p><strong>现代 CPU 多采用 专用通路</strong></p>

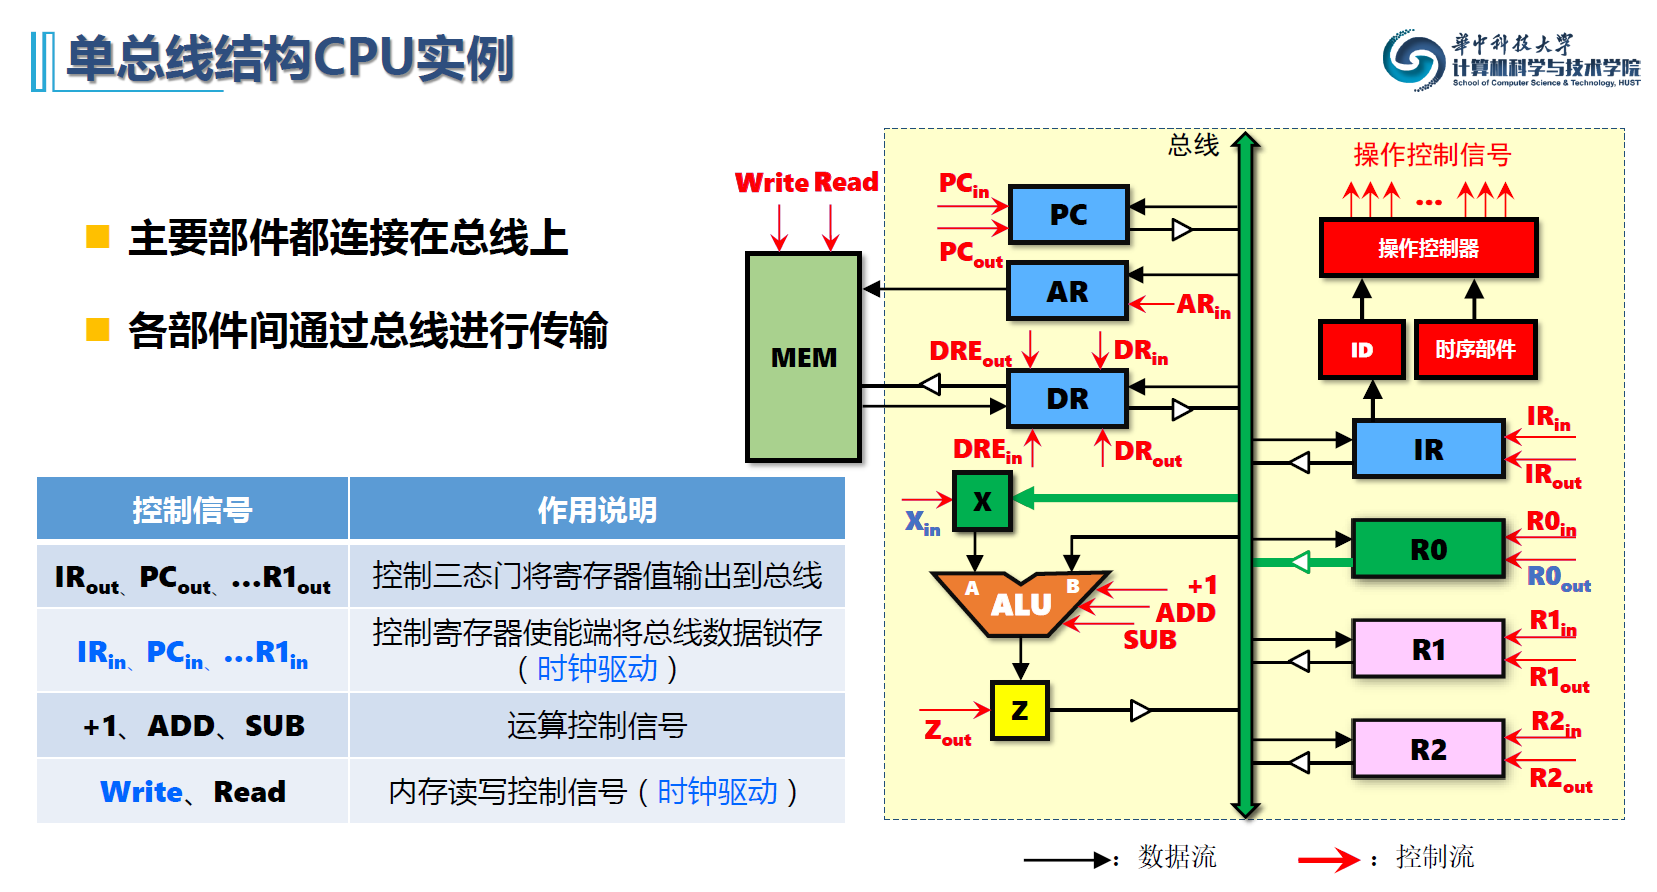
<ul>
  <li>共享通路(总线型)
主要部件都连接在公共总线上,各部件间通过总线进行数据传输
结构简单，实现容易 ,但并发性较差,需分时使用总线,效率低</li>
  <li>专用通路
并发度高，性能佳,设计复杂,成本高
可以看作多总线结构</li>
</ul>

<h4 id="介绍单总线双总线三总线数据通路">介绍单总线、双总线、三总线数据通路</h4>

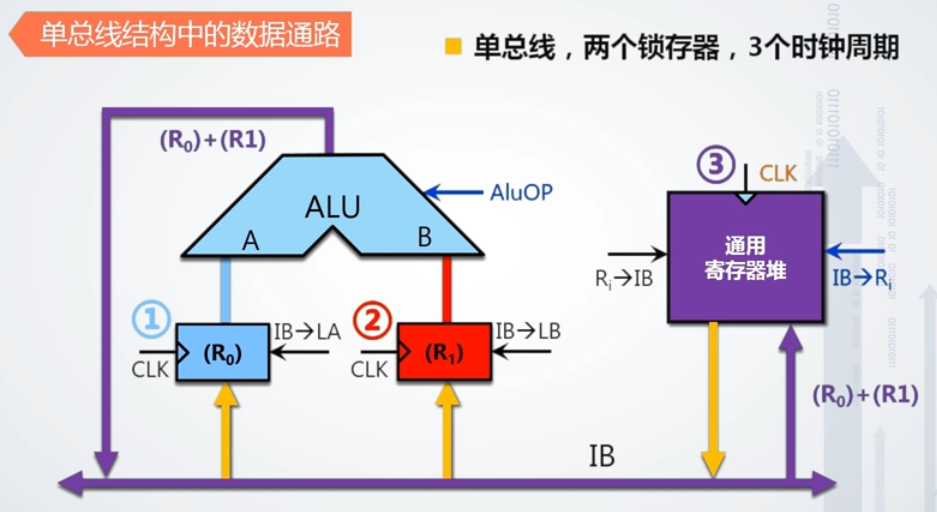
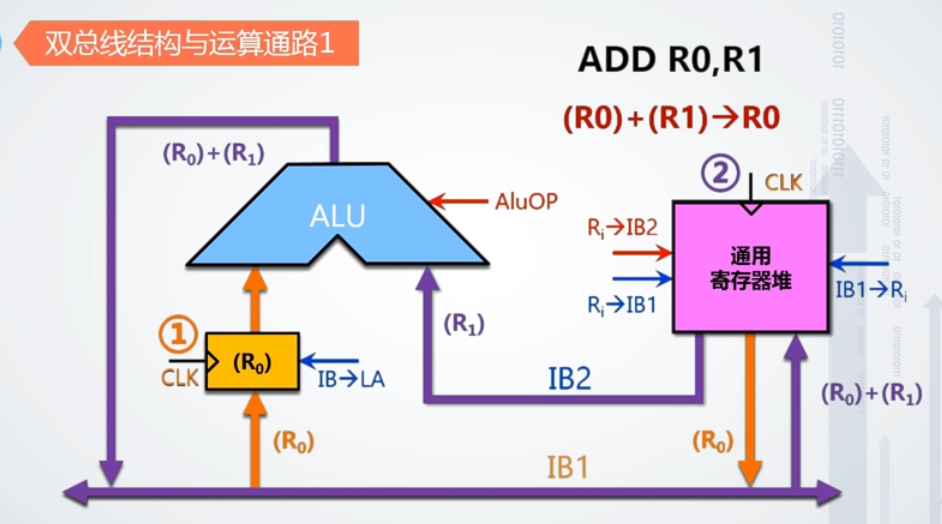
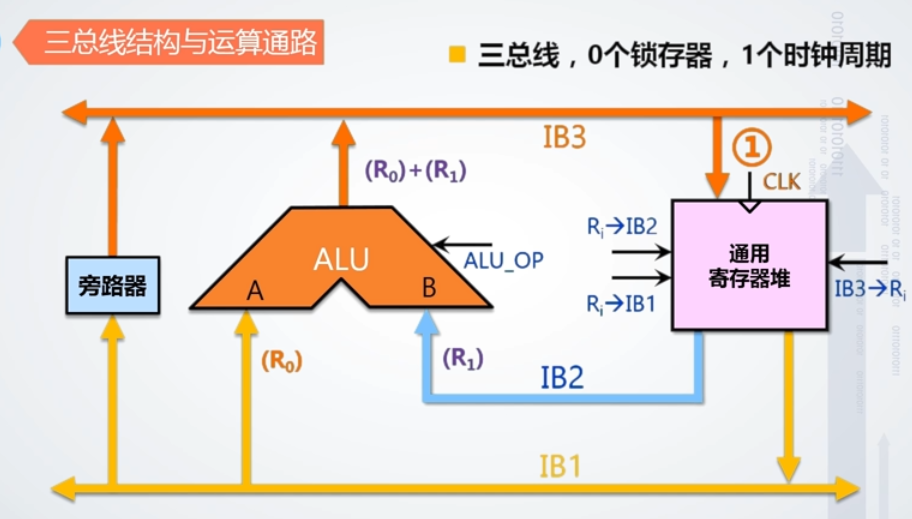
<p>对指令</p>

<pre><code class="language-assembly">ADD R0,R1
(R0)+(R1) -&gt; R0
</code></pre>

<p>单总线</p>

<p><img src="/assets/blog_image/2020-11-13-hust-cpu-study_4/image-20201114105521293.png" alt="image-20201114105521293" /></p>

<p>双总线</p>

<p><img src="/assets/blog_image/2020-11-13-hust-cpu-study_4/image-20201114105706866.png" alt="image-20201114105706866" /></p>

<p>三总线 并发写入</p>

<p><img src="/assets/blog_image/2020-11-13-hust-cpu-study_4/image-20201114105835266.png" alt="image-20201114105835266" /></p>

<h4 id="数据通路-与-cpu-结构之间的关系">数据通路 与 CPU 结构之间的关系</h4>

<p><img src="/assets/blog_image/2020-11-13-hust-cpu-study_4/image-20201114110109759.png" alt="image-20201114110109759" /></p>

<p>左下角是互斥的控制信号，因此可见冲突性较大，并发度小</p>

<p><img src="/assets/blog_image/2020-11-13-hust-cpu-study_4/image-20201114110033962.png" alt="image-20201114110033962" /></p>

<p>多总线将 ALU 与 取指令 逻辑分开，因此可以并发执行。</p>

<p><img src="/assets/blog_image/2020-11-13-hust-cpu-study_4/image-20201114110308476.png" alt="image-20201114110308476" /></p>

<p>单周期 MIPS 要求一条指令需要在一个时钟周期内完成。</p>

<table>
  <thead>
    <tr>
      <th>REGISTER</th>
      <th>NAME</th>
      <th>USAGE</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td>$0</td>
      <td>$zero</td>
      <td>常量0(constant value 0)</td>
    </tr>
    <tr>
      <td>$1</td>
      <td>$at</td>
      <td>保留给汇编器(Reserved for assembler)</td>
    </tr>
    <tr>
      <td>$2-$3</td>
      <td>$v0-$v1</td>
      <td>函数调用返回值(values for results and expression evaluation)</td>
    </tr>
    <tr>
      <td>$4-$7</td>
      <td>$a0-$a3</td>
      <td>函数调用参数(arguments)</td>
    </tr>
    <tr>
      <td>$8-$15</td>
      <td>$t0-$t7</td>
      <td>暂时的(或随便用的)</td>
    </tr>
    <tr>
      <td>$16-$23</td>
      <td>$s0-$s7</td>
      <td>保存的(或如果用，需要SAVE/RESTORE的)(saved)</td>
    </tr>
    <tr>
      <td>$24-$25</td>
      <td>$t8-$t9</td>
      <td>暂时的(或随便用的)</td>
    </tr>
    <tr>
      <td>$28</td>
      <td>$gp</td>
      <td>全局指针(Global Pointer)</td>
    </tr>
    <tr>
      <td>$29</td>
      <td>$sp</td>
      <td>堆栈指针(Stack Pointer)</td>
    </tr>
    <tr>
      <td>$30</td>
      <td>$fp</td>
      <td>帧指针(Frame Pointer)</td>
    </tr>
    <tr>
      <td>$31</td>
      <td>$ra</td>
      <td>返回地址(return address)</td>
    </tr>
  </tbody>
</table>

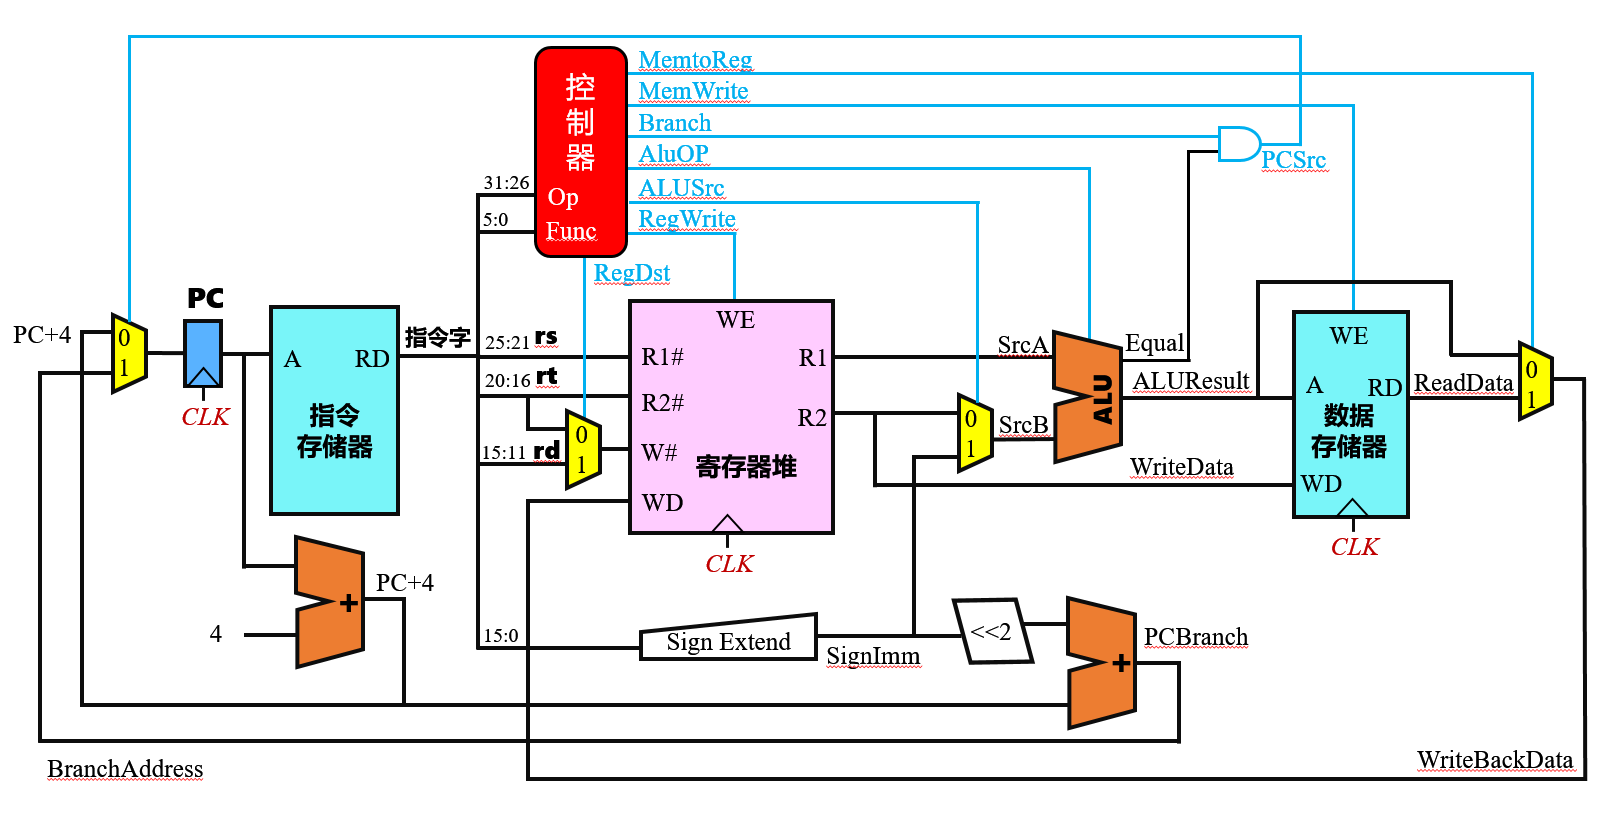
<h3 id="一单周期-mips-cpu设计">一、单周期 MIPS CPU设计</h3>

<p>实验内容</p>

<p>利用运算器实验，存储系统实验中构建的运算器、寄存器文件、存储系统等部件以及 Logisim 中其它功能部件，构建一个32位 MIPS CPU 单周期处理器。数据通路如下图所示：</p>

<p><img src="/assets/blog_image/2020-11-13-hust-cpu-study_4/image-20201113180337561.png" alt="image-20201113180337561" /></p>

<blockquote>
  <p>1) 立即数寻址（immediate addressing），操作数是位于指令自身中的常数。</p>

  <p>2) 寄存器寻址（register addressing），操作数是寄存器。</p>

  <p>3) 基址寻址(base addressing)或偏移寻址( displacement addressing），操作数在内存中，其地址是指令中基址寄存器和常数的和。</p>

  <p>4) PC相对寻址（PC-relative addressing），地址是PC和指令中常数的和。</p>

  <p>5) 伪直接寻址（pseudodirect addressing），跳转地址由指令中26位字段和PC高位相连而成。116硬件/软件接口　虽然我们把MIPS系统结构按32位地址描述，但是几乎所有的微处理器(包括MIPS)都能进行64位地址扩展(见附录E和2.18节)。这些扩展主要是针对大型程序的需要。指令集的扩展使得体系结构发展的同时，保持软件和下一代体系结构的向上兼容性。</p>
</blockquote>

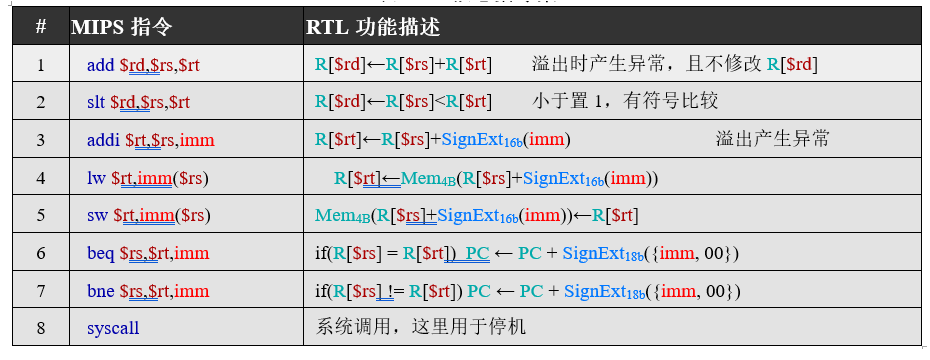
<p>要求支持8条 MIPS 核心指令，最终设计实现的 MIPS 处理器能运行实验包中的冒泡排序测试程序 sort.asm，该程序自动在数据存储器0~15号字单元中写入16个数据，然后利用冒泡排序将数据升序排序，要求统计指令条数与 MARS 中的指令统计数目进行对比。</p>

<p><img src="/assets/blog_image/2020-11-13-hust-cpu-study_4/image-20201113180401322.png" alt="image-20201113180401322" /></p>

<p><strong>电路框架</strong></p>

<table>
  <thead>
    <tr>
      <th>信号</th>
      <th>输入/输出</th>
      <th>位宽</th>
      <th>功能描述</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td>CLK</td>
      <td>输入</td>
      <td>1</td>
      <td>时钟信号</td>
    </tr>
    <tr>
      <td>PC</td>
      <td>输出</td>
      <td>32</td>
      <td>程序寄存器的值</td>
    </tr>
    <tr>
      <td>IR</td>
      <td>输出</td>
      <td>32</td>
      <td>当前指令字</td>
    </tr>
    <tr>
      <td>RegWrite</td>
      <td>输出</td>
      <td>1</td>
      <td>寄存器文件写使能控制信号</td>
    </tr>
    <tr>
      <td>RDin</td>
      <td>输出</td>
      <td>32</td>
      <td>寄存器文件写入端口的数据</td>
    </tr>
    <tr>
      <td>MemWrite</td>
      <td>输出</td>
      <td>1</td>
      <td>存储器写使能控制信号</td>
    </tr>
    <tr>
      <td>MDin</td>
      <td>输出</td>
      <td>32</td>
      <td>存储器写入端口的数据|</td>
    </tr>
  </tbody>
</table>

<p>完成设计后，加载 sort.hex 程序，测试排序功能。</p>

<p>Mem[PC++] -&gt; IR 即 PC++ 是每次加上一条指令的长度。32 位，因此此处为 PC + 4。</p>

<p>1、首先完成 PC 的 +4。是由于 32 位 MIPS 机中所有指令字长均为 4 字节，每条指令在存储器中占用 4 字节的存储单元。而 <strong>PC 中存放的地址是 字节地址</strong>（PC为 32 位，即存放一个表明 一个字节 的地址）。</p>

<p><img src="/assets/blog_image/2020-11-13-hust-cpu-study_4/image-20201114104004327.png" alt="image-20201114104004327" /></p>

<p>而<strong>指令存储器存放的是 字地址</strong>。因此要取出低两位。而长度为 10 位（ROM 定下的），因此取 2-11 位。</p>

<p>R型（Register）指的是寄存器型，I型（Immediate）指的是立即数型，J型（Jump）指的是无条件转移型。</p>

<p>现在对于各个指令进行分析</p>

<h4 id="1r-型">1、R 型</h4>

<p><strong>1、add 指令</strong></p>

<ul>
  <li><strong>无间址周期</strong></li>
</ul>

<p><img src="https://lyxf2000-1259802619.cos.ap-beijing.myqcloud.com/20200210124601.png" alt="无间址周期" /></p>

<p>为 R 型指令， 建立过程如下</p>

<p><img src="/assets/blog_image/2020-11-13-hust-cpu-study_4/image-20201116160122062.png" alt="image-20201116160122062" /></p>

<p><strong>2、SLT指令</strong></p>

<p>如果R2的值小于R3，那么设置R1的值为1，否则设置R1的值为0  SLT R1,R2,R3</p>

<p><img src="https://lyxf2000-1259802619.cos.ap-beijing.myqcloud.com/20200210124531.png" alt="SLT指令" /></p>

<p>若为 STL， 那么会在 ALU 进行运算，由于 单周期控制器的 MemToReg（写入寄存器的数据来自存储器即 LW 指令特有） 会为 0 ，因此选择 ALU 判断后的结果，写入到 Din，即 R[rd] 中</p>

<p><img src="/assets/blog_image/2020-11-13-hust-cpu-study_4/image-20201116162636099.png" alt="image-20201116162636099" /></p>

<h4 id="2i-型">2、I 型</h4>

<p><strong>1、addi 指令</strong></p>

<p>ADDI  把一个寄存器的内容加上一个立即数  ADDI R1,R2,#3</p>

<ul>
  <li><strong>无间址周期</strong></li>
</ul>

<p><img src="https://lyxf2000-1259802619.cos.ap-beijing.myqcloud.com/20200210124545.png" alt="无间址周期" /></p>

<p>为 I 型指令，而立即数为 16 位，因此需要扩展</p>

<p><strong>扩展选择符号扩展</strong></p>

<p>addi $s1, $s2, 100 —-»&gt;  $s1 = $s2 + 100</p>

<p><img src="/assets/blog_image/2020-11-13-hust-cpu-study_4/image-20201116163736464.png" alt="image-20201116163736464" /></p>

<p><strong>2、LW</strong></p>

<p><strong>从存储器中</strong>读取一个字的数据到寄存器中  LW R1, 0(R2)</p>

<p>MIPS 的仿存指令属于 I 型指令，访存地址 等于 变址寄存器 $rs 的值 加上 16 位立即数。</p>

<ul>
  <li><strong>基址寻址</strong></li>
</ul>

<p><img src="https://lyxf2000-1259802619.cos.ap-beijing.myqcloud.com/20200210124413.png" alt="基址寻址" /></p>

<p><img src="/assets/blog_image/2020-11-13-hust-cpu-study_4/image-20201116163812207.png" alt="image-20201116163812207" /></p>

<p>而 MemToReg 用于选择是否是从存储器中读出。</p>

<p><img src="/assets/blog_image/2020-11-13-hust-cpu-study_4/image-20201116162636099.png" alt="image-20201116162636099" /></p>

<p><strong>3、SW</strong></p>

<p>把一个字的数据从寄存器存储到存储器中  SW R1, 0(R2)</p>

<ul>
  <li><strong>基址寻址</strong></li>
</ul>

<p><img src="https://lyxf2000-1259802619.cos.ap-beijing.myqcloud.com/20200210124423.png" alt="" /></p>

<p><img src="/assets/blog_image/2020-11-13-hust-cpu-study_4/image-20201116164109047.png" alt="image-20201116164109047" /></p>

<p>实现如图</p>

<p><img src="/assets/blog_image/2020-11-13-hust-cpu-study_4/image-20201116164516605.png" alt="image-20201116164516605" /></p>

<p><strong>3、Beq</strong></p>

<p>数据跳转指令，标志寄存器中Z标志位等于零时, 跳转到BEQ后标签处</p>

<ul>
  <li><strong>PC相对寻址</strong></li>
</ul>

<p><img src="/assets/blog_image/2020-11-13-hust-cpu-study_4/image-20201116165002779.png" alt="image-20201116165002779" /></p>

<p><img src="/assets/blog_image/2020-11-13-hust-cpu-study_4/image-20201116165011352.png" alt="image-20201116165011352" /></p>

<blockquote>
  <p>Q:  此处为何要移位？</p>

  <p>A:  立即数中的地址表示是<strong>按字来算</strong>的，对于按字节编址的存储器来说（1字-&gt;4字节）需要乘4
 当然如果你的存储器是按字编址就不需要乘4或左移2位了</p>
</blockquote>

<p><img src="/assets/blog_image/2020-11-13-hust-cpu-study_4/image-20201116175812867.png" alt="image-20201116175812867" /></p>

<p><strong>4、bne</strong></p>

<p>数据跳转指令，标志寄存器中Z标志位不等于零时, 跳转到BNE后标签处</p>

<p><img src="https://lyxf2000-1259802619.cos.ap-beijing.myqcloud.com/20200210124522.png" alt="" /></p>

<p><strong>5、Bne</strong></p>

<p>同理，取反就行</p>

<p><img src="/assets/blog_image/2020-11-13-hust-cpu-study_4/image-20201116170235192.png" alt="image-20201116170235192" /></p>

<h4 id="3syscall">3、Syscall</h4>

<ul>
  <li><strong>无间址周期</strong></li>
</ul>

<p><img src="https://lyxf2000-1259802619.cos.ap-beijing.myqcloud.com/20200210124633.png" alt="" /></p>

<p>由于此处作用为 <strong>停机信号</strong>，且 <strong>单周期布线控制器</strong> 专门有一个引脚为 Halt，因此直接调用即可，连接至 PC 的使能信号处。</p>

<p><img src="/assets/blog_image/2020-11-13-hust-cpu-study_4/image-20201116170819620.png" alt="image-20201116170819620" /></p>

<p>补充一点，这里的停机是靠位于左上方的计数器，计算周期数。在计数器中设置最大值为224，当周期达到224时即可停机。</p>

<p>电路实现如下</p>

<p><img src="/assets/blog_image/2020-11-13-hust-cpu-study_4/image-20201116183929700.png" alt="image-20201116183929700" /></p>

<p>一定要记住！！！！</p>

<ul>
  <li>16-&gt;32 扩展选择符号扩展</li>
  <li>将上面的 PC、IR…啥的进行连接，方便检测。</li>
</ul>

<h3 id="二单周期硬布线控制器">二、单周期硬布线控制器</h3>

<p><img src="/assets/blog_image/2020-11-13-hust-cpu-study_4/image-20201116162940783.png" alt="image-20201116162940783" /></p>

<p>该实验只涉及 8 条核心的 MIPS 指令。而这 8 条MIPS指令的指令字段已经在附件中给出（关于MIPS指令字段可参考我另一篇关于单总线定长&amp;变长的博客   <a href="http://husharp.today/2020/10/19/hust-cpu-study_3/#2mips-ram%E8%AE%BE%E8%AE%A1">biubiu传送门</a>  ），并且电路底部文字也给出了关于<em>SYSCALL</em>的提示，因此，这部分只需根据相应的<em>OP</em>和<em>FUNC</em>字段进行简单地逻辑比较就可实现。</p>

<p>电路实现如下</p>

<p><img src="/assets/blog_image/2020-11-13-hust-cpu-study_4/image-20201116174057681.png" alt="image-20201116174057681" /></p>

<p>且打开存储器，发现完成排序</p>

<p><img src="/assets/blog_image/2020-11-13-hust-cpu-study_4/image-20201116232156005.png" alt="image-20201116232156005" /></p>

<p>MIPS 寄存器文件中 0 号寄存器的值恒零</p>

<p><a href="http://husharp.today/2020/10/19/hust-cpu-study_3/#2mips-ram%E8%AE%BE%E8%AE%A1">寄存器看这篇文章</a></p>

<h3 id="三mips-微程序-cpu-设计">三、MIPS 微程序 CPU 设计</h3>

<p><img src="/assets/blog_image/2020-11-13-hust-cpu-study_4/image-20201118195644099.png" alt="image-20201118195644099" />
<img src="/assets/blog_image/2020-11-13-hust-cpu-study_4/image-20201118195630789.png" alt="image-20201118195630789" />
<img src="/assets/blog_image/2020-11-13-hust-cpu-study_4/image-20201118200536417.png" alt="image-20201118200536417" />
<img src="/assets/blog_image/2020-11-13-hust-cpu-study_4/image-20201118200046464.png" alt="image-20201118200046464" /></p>]]></content><author><name></name></author><category term="cpu" /></entry><entry><title type="html">自己动手画 CPU《计算机组织与结构实验》（三）</title><link href="/cpu/2020/10/19/hust-cpu-study_3.html" rel="alternate" type="text/html" title="自己动手画 CPU《计算机组织与结构实验》（三）" /><published>2020-10-19T02:58:32+00:00</published><updated>2020-10-19T02:58:32+00:00</updated><id>/cpu/2020/10/19/hust-cpu-study_3</id><content type="html" xml:base="/cpu/2020/10/19/hust-cpu-study_3.html"><![CDATA[<ul id="markdown-toc">
  <li><a href="#三存储系统设计" id="markdown-toc-三存储系统设计">三、存储系统设计</a>    <ul>
      <li><a href="#1汉字字库存储芯片扩展实验" id="markdown-toc-1汉字字库存储芯片扩展实验">1、汉字字库存储芯片扩展实验</a>        <ul>
          <li><a href="#综合举例" id="markdown-toc-综合举例">综合举例</a></li>
        </ul>
      </li>
      <li><a href="#2mips-ram-设计" id="markdown-toc-2mips-ram-设计">2、MIPS RAM 设计</a>        <ul>
          <li><a href="#1load" id="markdown-toc-1load">1、load</a></li>
          <li><a href="#2写入-store" id="markdown-toc-2写入-store">2、写入 store</a>            <ul>
              <li><a href="#1wi-是否选择该组件" id="markdown-toc-1wi-是否选择该组件">1、wi 是否选择该组件</a></li>
              <li><a href="#2di-表示此时选择该组件输入时写入的数据" id="markdown-toc-2di-表示此时选择该组件输入时写入的数据">2、di 表示此时选择该组件输入时写入的数据</a></li>
            </ul>
          </li>
        </ul>
      </li>
      <li><a href="#3mips-寄存器文件设计" id="markdown-toc-3mips-寄存器文件设计">3、MIPS 寄存器文件设计</a></li>
      <li><a href="#4直接相联-cache-设计" id="markdown-toc-4直接相联-cache-设计">4、直接相联 Cache 设计</a>        <ul>
          <li><a href="#1直接相联介绍" id="markdown-toc-1直接相联介绍">1.直接相联介绍</a></li>
          <li><a href="#2实验步骤" id="markdown-toc-2实验步骤">2.实验步骤</a></li>
          <li><a href="#3直接相联特点" id="markdown-toc-3直接相联特点">3.直接相联特点</a></li>
        </ul>
      </li>
      <li><a href="#5全相联-cache-设计" id="markdown-toc-5全相联-cache-设计">5、全相联 Cache 设计</a>        <ul>
          <li><a href="#1全相联介绍" id="markdown-toc-1全相联介绍">1.全相联介绍</a></li>
          <li><a href="#2实验步骤-1" id="markdown-toc-2实验步骤-1">2.实验步骤</a></li>
          <li><a href="#3全相联特点" id="markdown-toc-3全相联特点">3.全相联特点</a></li>
        </ul>
      </li>
      <li><a href="#64-路组相联-cache-设计" id="markdown-toc-64-路组相联-cache-设计">6、4 路组相联 Cache 设计</a>        <ul>
          <li><a href="#1组相联介绍" id="markdown-toc-1组相联介绍">1.组相联介绍</a></li>
          <li><a href="#2实验步骤-2" id="markdown-toc-2实验步骤-2">2.实验步骤</a></li>
        </ul>
      </li>
      <li><a href="#72-路组相联-cache-设计" id="markdown-toc-72-路组相联-cache-设计">7、2 路组相联 Cache 设计</a>        <ul>
          <li><a href="#2实验步骤-3" id="markdown-toc-2实验步骤-3">2.实验步骤</a></li>
          <li><a href="#3组相联特点" id="markdown-toc-3组相联特点">3.组相联特点</a></li>
        </ul>
      </li>
    </ul>
  </li>
</ul>

<p><a href="https://www.icourse163.org/course/HUST-1205809816">配套慕课</a></p>

<h2 id="三存储系统设计">三、存储系统设计</h2>

<h3 id="1汉字字库存储芯片扩展实验">1、汉字字库存储芯片扩展实验</h3>

<p><strong>实验目的</strong></p>

<p>理解存储系统进行位扩展、字扩展的基本原理，能利用相关原理解决实验中汉字字库的存储扩展问题，并能够使用正确的字库数据填充。</p>

<p><strong>电路引脚</strong></p>

<table>
  <thead>
    <tr>
      <th>信号</th>
      <th>输入/输出</th>
      <th>位宽</th>
      <th>说明</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td>区号Qu</td>
      <td>输入</td>
      <td>7 位</td>
      <td>汉字区位码的区号</td>
    </tr>
    <tr>
      <td>位号Wei</td>
      <td>输入</td>
      <td>7 位</td>
      <td>汉字区位码的位号</td>
    </tr>
    <tr>
      <td>Di</td>
      <td>输出</td>
      <td>32 位</td>
      <td>汉字点阵信息</td>
    </tr>
  </tbody>
</table>

<p>汉字点阵为16*16位。需要8片16K32位ROM来存储点阵信息。</p>

<p>我们需要用 4 片 4 K 32 位 ROM代替其中一片 16 K 32 位ROM。</p>

<p>4K需要12根地址线，16K需要14根地址线。所以高位多余的两位作为片选信号。</p>

<p>我们需要一个数据选择器，来进行选择输出那一片ROM中的数据。</p>

<p>再根据数据进行分析，数据的最后两位是选片区的。所以将最后两位直接输入到选择器选择短。</p>

<p>最后将数据对应连接，及可得到电路。</p>

<p>参考字库采用 8 片 16 K 32 位 ROM 来存储点阵信息。</p>

<p><img src="/assets/blog_image/2020-10-19-hust-cpu-study_3/image-20201025214905314.png" alt="image-20201025214905314" /></p>

<p>主要扩展方法：<strong>字扩展、位扩展、字位扩展</strong></p>

<p>设存储空间为 M <strong>*** N 位，M 表示 M 根地址线，N 表示 N 根数据线。现有存储芯片是 m **</strong>* n 位。</p>

<p>若 M=m ，N&gt;n，需要对芯片进行 位扩展。（数据线扩展，字长扩展）</p>

<p>若 M&gt;m，N=n，需要对芯片进行 字扩展。 （地址线扩展， 字数扩展)</p>

<p>若 M&gt;m，N&gt;n，需要对芯片进行 字位扩展。</p>

<p>1、位扩展时：当 CPU 给出一个地址访问存储系统时，该地址被送入到所有的存储芯片中，所有芯片并发的工作，并提供各自的 2 位信息。</p>

<p>2、字扩展时：当 CPU 给出一个地址访问存储系统时，只有一个存储芯片工作，具体哪个芯片工作由存储系统地址高 2 位来决定。</p>

<p><img src="/assets/blog_image/2020-10-19-hust-cpu-study_3/image-20201026000344201.png" alt="image-20201026000344201" /></p>

<p>由于此处是 4 片 4 K 32 位 ROM 代替其中 1 片 16 K 32 位ROM，因此需要采用字扩展。</p>

<p><img src="/assets/blog_image/2020-10-19-hust-cpu-study_3/image-20201025215007703.png" alt="image-20201025215007703" /></p>

<p>4 个 4K 变为 1 个 16K，需要的是串行输出某个指定的 ROM，因此通过一个多路选择器，来进行选择输出那一片ROM中的数据。</p>

<p><img src="/assets/blog_image/2020-10-19-hust-cpu-study_3/image-20201026000446620.png" alt="字扩展图示" /></p>

<p>下图易发现，片选选择相应的 ROM。其余 12 位都输入一样的结果。在 7 片位扩展的 ROM 组中，并行计算，各自给出自身 ROM 中的相应数值，再拼凑起来。</p>

<p><img src="/assets/blog_image/2020-10-19-hust-cpu-study_3/image-20201025223205311.png" alt="image-20201025223205311" /></p>

<p>组合好电路之后，将示例中的 ROM 中的数据分别放到指定位置。值得注意的是：</p>

<p>0000-0ff0</p>

<p>1000-1ff0</p>

<p>2000-2ff0</p>

<p>3000-3ff0</p>

<p>分别为第一片 ROM 到 第四片的数据，依次复制到对应ROM中，即可展开测试。</p>

<h4 id="综合举例">综合举例</h4>

<p><img src="/assets/blog_image/2020-10-19-hust-cpu-study_3/image-20201026001646966.png" alt="image-20201026001646966" /></p>

<p>因此由主存地址可知：</p>

<p><img src="/assets/blog_image/2020-10-19-hust-cpu-study_3/image-20201026001706790.png" alt="image-20201026001706790" /></p>

<p>下面对几个情况进行图示：</p>

<p><img src="/assets/blog_image/2020-10-19-hust-cpu-study_3/image-20201026002044431.png" alt="image-20201026002044431" /></p>

<p><img src="/assets/blog_image/2020-10-19-hust-cpu-study_3/image-20201026002057406.png" alt="image-20201026002057406" /></p>

<p><img src="/assets/blog_image/2020-10-19-hust-cpu-study_3/image-20201026002105891.png" alt="image-20201026002105891" /></p>

<h3 id="2mips-ram-设计">2、MIPS RAM 设计</h3>

<p><strong>实验内容</strong></p>

<p>Logisim 中 RAM 组件只能提供固定的地址位宽，数据输出也只能提供固定的数据位宽，访问时无法同时支持字节/半字/字三种访问模式，实验要求利用4个8位的 RAM 组件进行扩展，设计完成既能按照8位、也能按16位、也能按照32位进行读写访问的32位存储器，最终存储器引脚定义如下表。</p>

<p><img src="/assets/blog_image/2020-10-19-hust-cpu-study_3/image-20201114103508715.png" alt="image-20201114103508715" /></p>

<p><strong>电路引脚</strong></p>

<table>
  <thead>
    <tr>
      <th>信号</th>
      <th>输入/输出</th>
      <th>位宽</th>
      <th>功能描述</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td>Addr</td>
      <td>输入</td>
      <td>12</td>
      <td>字节地址输入（字访问时忽略最低两位，半字访问时忽略最低位，倒数第二位片选，字节访问时，低两位进行片选）</td>
    </tr>
    <tr>
      <td>Din</td>
      <td>输入</td>
      <td>32</td>
      <td>写入数据 （不同访问模式有效数据均存放在最低位，高位忽略</td>
    </tr>
    <tr>
      <td>Mode</td>
      <td>输入</td>
      <td>2</td>
      <td>访问模式控制位（00 表示字访问，01 表示 1 字节访问，10 表示 2 字节访问）</td>
    </tr>
    <tr>
      <td>WE</td>
      <td>输入</td>
      <td>1</td>
      <td>写使能，1 表示写入，0 表示读出</td>
    </tr>
    <tr>
      <td>Dout</td>
      <td>输出</td>
      <td>32</td>
      <td>读出数据 （不同访问模式有效数据均存放在最低位，高位补零）；</td>
    </tr>
  </tbody>
</table>

<p>该实验需要完成既能按照8位、也能按16位、也能按照32位进行读写访问的32位存储器。如下图在不同要求时进行不同 byte 的选择。</p>

<p><img src="/assets/blog_image/2020-10-19-hust-cpu-study_3/image-20201025233636222.png" alt="image-20201025233636222" /></p>

<p>现在开始实验的分析</p>

<ul>
  <li>字地址，也就是 32 位地址，由 4 个字节组成，因此按字节编址的话，地址末尾一定是00。而半字地址，末尾一定是0。本实验的输入没有做严格限定，要求我们相应MODE下对地址进行对齐。</li>
  <li>load 信号一直有效，而写信号只有当 WE=1时才有效。</li>
  <li>32位数据由 四片 RAM 并行工作给出，16位选高两片或低两片，8位则只需1片 RAM 工作。</li>
  <li>给出的地址是字节地址，因此为了选中相应的 RAM ，需要取出后两位判断；为了取出相应的半字，需要对第二低位进行判断。</li>
  <li>送入写入端的数据，根据 MODE 和 Din 的相关位生成</li>
</ul>

<p>首先实现大框架展示</p>

<p><img src="/assets/blog_image/2020-10-19-hust-cpu-study_3/image-20201027160104632.png" alt="image-20201027160104632" /></p>

<p>str信号由各 RAM 的 WE 信号 和 wi 信号 相与给出，表示仅当写模式下，且该 RAM 需要参与写时才有效。输入数据和输出数据分别由相应的通道给出，方便后续控制。</p>

<p>wi 表示此时是否选择该组件写入。di 表示此时选择该组件输入时写入的数据。</p>

<p>sel 为0 禁用组件，因此置为 1 或者 悬空都可。</p>

<p><img src="/assets/blog_image/2020-10-19-hust-cpu-study_3/image-20201026163742613.png" alt="image-20201026163742613" /></p>

<h4 id="1load">1、load</h4>

<p>首先说明当为 load 时，如何读出。</p>

<p>最简单的就是字读出，当模式为字读出时，直接输出全部数据即可。</p>

<p>半字读出时，我们由<strong>字节地址第二低位</strong>来决定输出哪个半字。</p>

<p>字节读出时，我们由<strong>字节地址低两位</strong>来决定输出哪个字节。0 表示 01 位、1 表示 23 位。</p>

<p><img src="/assets/blog_image/2020-10-19-hust-cpu-study_3/image-20201027155851848.png" alt="image-20201027155851848" /></p>

<h4 id="2写入-store">2、写入 store</h4>

<p>由之前的框架图</p>

<p><img src="/assets/blog_image/2020-10-19-hust-cpu-study_3/image-20201027160104632.png" alt="image-20201027160104632" /></p>

<p>可知：</p>

<ul>
  <li>str 信号由各 RAM 的 WE 信号 和 wi 信号 相与给出，表示仅当写模式下，且该 RAM 需要参与写时才有效。输入数据和输出数据分别由相应的通道给出，方便后续控制。</li>
  <li>wi 表示此时是否选择该组件写入。di 表示此时选择该组件输入时写入的数据。</li>
</ul>

<h5 id="1wi-是否选择该组件">1、wi 是否选择该组件</h5>

<p>考虑一下什么情况下这个 RAM 需要写入数据。</p>

<ul>
  <li>字 00 写入时肯定所有 RAM  都要写入；</li>
  <li>半字 10 写入时，只有当前片被选中才需要写入；</li>
  <li>单字节 01 写入时，只有指定了当前片才需要写入。</li>
  <li>现在通过 mode 的译码器，作为 模式 的选择
<img src="/assets/blog_image/2020-10-19-hust-cpu-study_3/image-20201027163328146.png" alt="image-20201027163328146" /></li>
</ul>

<p>于是可以构造以下的电路：</p>

<p>当 mode = 00 时，<strong>所有片选信号都要为真</strong>，进行写入</p>

<p>当 mode = 01 时，字节地址最低两位 和 所选择的 RAM 编号相一致时，进行写入。</p>

<p>当 mode = 10 时，字节地址的倒数第二低的一位来决定选择哪两片。<strong>当这一位等于0，应该选择01号组合，否则选择23号组合。</strong></p>

<ul>
  <li>因此值得注意的是，在mode 为 10 时，在 RAM 编号为 0、1时需要取反。（理由如上）</li>
</ul>

<p><img src="/assets/blog_image/2020-10-19-hust-cpu-study_3/image-20201027162434784.png" alt="image-20201027162434784" /></p>

<h5 id="2di-表示此时选择该组件输入时写入的数据">2、di 表示此时选择该组件输入时写入的数据</h5>

<p>di 的输入取决于 mode 的输入，然后对 Din 值进行选择。</p>

<p>如果 mode 为 字 写入（00），从 d0-d3 分别输入 0-7,8-15,16-23,24-31 位数据。</p>

<p>如果 mode 为 字节 写入（01），会写入 Din 的 0-7 位数据，所以我们将 d0-d3 都输入 0-7 位数据。至于选哪片RAM 写入，由写的片选信号决定。</p>

<p>如果 mode 位 半字 写入（10），会写入 Din 的 0-15 位数据，<strong>因为我们必须实现对齐，所以无论是01号组合，还是23号组合，较低编号一定存放低位数据，反之存放高位数据，所以d0，d2输入0-7位数据，d1，d3输入8-15位数据。</strong></p>

<p><img src="/assets/blog_image/2020-10-19-hust-cpu-study_3/image-20201027141838567.png" alt="image-20201027141838567" /></p>

<p>注意 可结合大端小端进行深入思考</p>

<p><img src="/assets/blog_image/2020-10-19-hust-cpu-study_3/image-20201026164004881.png" alt="image-20201026164004881" /></p>

<p>但是无论大端小端，每个系统的内部是一致的，但在系统间进行通信时，会发生问题。因此需要进行顺序的转换。</p>

<p><img src="/assets/blog_image/2020-10-19-hust-cpu-study_3/image-20201027163740120.png" alt="image-20201027163740120" /></p>

<p>最终电路实现如下</p>

<p><img src="/assets/blog_image/2020-10-19-hust-cpu-study_3/image-20201027163433379.png" alt="image-20201027163433379" /></p>

<h3 id="3mips-寄存器文件设计">3、MIPS 寄存器文件设计</h3>

<p><strong>实验目的</strong></p>

<p>利用 Logisim 平台构建一个简化的 MIPS 寄存器文件，内部包含4个32位寄存器，其具体引脚与功能描述如下表。</p>

<p><strong>引脚介绍</strong></p>

<p><img src="/assets/blog_image/2020-10-19-hust-cpu-study_3/image-20201027164339797.png" alt="image-20201027164339797" /></p>

<table>
  <thead>
    <tr>
      <th>信号</th>
      <th>输入/输出</th>
      <th>位宽</th>
      <th>功能描述</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td>R1#</td>
      <td>输入</td>
      <td>5</td>
      <td>第 1 个读寄存器的编号</td>
    </tr>
    <tr>
      <td>R2#</td>
      <td>输入</td>
      <td>5</td>
      <td>第 2 个读寄存器的编号</td>
    </tr>
    <tr>
      <td>W#</td>
      <td>输入</td>
      <td>5</td>
      <td>写入寄存器编号</td>
    </tr>
    <tr>
      <td>Din</td>
      <td>输入</td>
      <td>32</td>
      <td>写入数据</td>
    </tr>
    <tr>
      <td>WE</td>
      <td>输入</td>
      <td>1</td>
      <td>写使能信号，为 1 时在 CLK 上跳沿将 Din 数据写入W#寄存器</td>
    </tr>
    <tr>
      <td>CLK</td>
      <td>输入</td>
      <td>1</td>
      <td>时钟信号，上跳沿有效</td>
    </tr>
    <tr>
      <td>RD1</td>
      <td>输出</td>
      <td>32</td>
      <td>R1# 寄存器的值，MIPS 寄存器文件中 0 号寄存器的值恒零</td>
    </tr>
    <tr>
      <td>RD2</td>
      <td>输出</td>
      <td>32</td>
      <td>R2# 寄存器的值，MIPS 寄存器文件中 0 号寄存器的值恒零</td>
    </tr>
  </tbody>
</table>

<p>注意R1#R2#W#，为了简化，只有 2 位位宽，这样便可以在 0-3 号寄存器中选择。其中 0 号寄存器的值恒零。</p>

<p>首先实现读逻辑。</p>

<p>R1# 和 R2# 为两位位宽，设置数据选择器的位宽为两位。这样就可以通过 R1# 和 R2# 决定 RD1 和 RD2 取指定编号寄存器中的值。</p>

<p>如：R1#：10 表示 2 号寄存器</p>

<p>每个寄存器连接上对应输出，把输出接到上面的两个数据选择器的数据输入端即可。</p>

<p><img src="/assets/blog_image/2020-10-19-hust-cpu-study_3/image-20201027171000230.png" alt="image-20201027171000230" /></p>

<p>接下来实现写逻辑。</p>

<p>一共有 4 个寄存器，所以通过译码器，将 W# 转换为4个片选信号。分别表示 0-3 号寄存器。</p>

<p>当 WE 为1时，表示可以写入数据。所以将片选信号和 WE 用与门连接。</p>

<p>最后将数据输入对应，即可得到电路。</p>

<p>另外，要注意0号寄存器要保持恒零，所以数据输入也要为零。</p>

<p><img src="/assets/blog_image/2020-10-19-hust-cpu-study_3/image-20201027171429856.png" alt="image-20201027171429856" /></p>

<p><strong>直接相联、组相联、全相联直观区别：</strong></p>

<p><img src="/assets/blog_image/2020-10-19-hust-cpu-study_3/image-20201030200000923.png" alt="image-20201030200000923" /></p>

<h3 id="4直接相联-cache-设计">4、直接相联 Cache 设计</h3>

<p><img src="/assets/blog_image/2020-10-19-hust-cpu-study_3/image-20201028193911150.png" alt="image-20201028193911150" /></p>

<p>上图给出了一个在 Logisim 中设计完成的 cache 系统自动测试电路，为简化实验设计，这里所有 cache 模块均为只读  cache（类似指令 cache），无写入机制。电路左侧计数器与存储器部分会在时钟驱动下逐一生成地址访问序列给 cache  模块。计数器模块的使能端受命中信号驱动，缺失时使能端无效，计数器不计数，等待系统将待请求数据所在块从二级存储器中调度到 cache  后才能继续计数。cache 与二级存储器之间通过块交换逻辑实现数据块交换，由于二级存储器相比 cache  慢很多，所以一次块交换需要多个时钟周期才能完成，cache 模块判断数据块准备好的逻辑是 blkready  信号有效，该信号有效且时钟到来时，cache 将块数据从 BlkDin 端口一次性载入到对应 cache 行缓冲区中，此时 cache  数据命中，直接输出请求数据，解锁计数器使能端，继续访问下一个地址。</p>

<p>电路引脚</p>

<table>
  <thead>
    <tr>
      <th>信号</th>
      <th>输入/输出</th>
      <th>位宽</th>
      <th>功能描述</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td>Addr</td>
      <td>输入</td>
      <td>16</td>
      <td>主存地址</td>
    </tr>
    <tr>
      <td>BlkDataIn</td>
      <td>输入</td>
      <td>32</td>
      <td>块数据输入</td>
    </tr>
    <tr>
      <td>BlkDataReady</td>
      <td>输入</td>
      <td>1</td>
      <td>块数据准备就绪</td>
    </tr>
    <tr>
      <td>CLK</td>
      <td>输入</td>
      <td>1</td>
      <td>时钟输入</td>
    </tr>
    <tr>
      <td>Miss</td>
      <td>输出</td>
      <td>1</td>
      <td>1：数据缺失；0：数据命中</td>
    </tr>
    <tr>
      <td>DataOut</td>
      <td>输出</td>
      <td>8</td>
      <td>数据输出</td>
    </tr>
  </tbody>
</table>

<h4 id="1直接相联介绍">1.直接相联介绍</h4>

<p>块映射速度快 ，一对映射 一对映射 ，无须查表 无须查表</p>

<ul>
  <li>利用索引字段直接对比相应标记位即可</li>
  <li>查找表可以和副本一起存放 ，无需相联存储器</li>
</ul>

<p><img src="/assets/blog_image/2020-10-19-hust-cpu-study_3/image-20201029200915836.png" alt="image-20201029200915836" /></p>

<p>如下图所示：</p>

<p>直接相联只用设计：字节地址和cache槽的设计、写入和写出设计、比较设计。</p>

<p><img src="/assets/blog_image/2020-10-19-hust-cpu-study_3/image-20201029200933511.png" alt="image-20201029200933511" /></p>

<h4 id="2实验步骤">2.实验步骤</h4>

<p><strong>1、字节地址设计</strong></p>

<p>由下图可知，输入到 直接相联映射的 Cache 槽前半部分（主存地址）为 16 位，直接映射分为 块 + 行 + 块内字节偏移</p>

<p>而 共要设计 8 块 Cache 槽，2^3 = 8，即  行占 3 位</p>

<p>又因为块数据输入为 32 位 即 4 字节，而由于输出 Dataout 为 8 位，即按照 字节 进行输出，因此 行内字节偏移 在 Cache  槽中占 2 位。</p>

<p>其余 11 位全部作为区号 tag</p>

<p><img src="/assets/blog_image/2020-10-19-hust-cpu-study_3/image-20201029203316538.png" alt="image-20201029203316538" /></p>

<p>先将主存地址进行分割，作为 Cache 槽的前半部分。</p>

<p><strong>2、Cache槽的设计</strong></p>

<p>现在开始设计 Cache 槽。<em>cache</em>  主要包含四部分：Valid标志、主存 Tag 标记位、淘汰计数标记、数据副本。而我们需要考虑的是前三部分（直接相联没有淘汰计数，直接覆盖之前的 mod 数据），并且这三部分和之后的设计息息相关。</p>

<ul>
  <li>当中 valid 位有效位，判断该 cache 槽是否被命中过，存入了数据；</li>
  <li>Tag 位是存入的主存标记位；</li>
</ul>

<blockquote>
  <p>注意：三态门</p>

  <p><img src="/assets/blog_image/2020-10-19-hust-cpu-study_3/image-20201029210052306.png" alt="image-20201029210052306" /><img src="/assets/blog_image/2020-10-19-hust-cpu-study_3/image-20201029210032827.png" alt="image-20201029205946214" /><img src="/assets/blog_image/2020-10-19-hust-cpu-study_3/image-20201029205954527.png" alt="image-20201029205954527" /><img src="/assets/blog_image/2020-10-19-hust-cpu-study_3/image-20201029210008479.png" alt="image-20201029210008479" /></p>
</blockquote>

<p><strong>3、Cache 槽号译码器选择相应行</strong></p>

<p><img src="/assets/blog_image/2020-10-19-hust-cpu-study_3/image-20201029212251678.png" alt="image-20201029212251678" /></p>

<p><strong>4、首先完成判断是否命中</strong></p>

<p>通过有效位的判断 和 标志位（即此处的区号）判断，来进行 HIT 和 MISS 的判断。也就是说，只有当前组（块映射的Cache槽组） 和 当前行 同时被选中时，才能判断 HIT。</p>

<p>值得注意的是，<strong>此处三态门全部由 行选信号进行判断。</strong></p>

<p><img src="/assets/blog_image/2020-10-19-hust-cpu-study_3/image-20201029212547531.png" alt="image-20201029212547531" /></p>

<p><strong>5、若未命中，需要进行读入数据</strong></p>

<p>写入设计则要当 <em>BlkReady</em> 数据准备完成时（测试电路中的数据准备）选择具体的 cache 行进行写入，而写入的前提是该行为空，即 <em>Miss</em> 信号有效，才能写入数据。</p>

<p><img src="/assets/blog_image/2020-10-19-hust-cpu-study_3/image-20201029215138264.png" alt="image-20201029215138264" /></p>

<p><strong>6、选择 Cache 槽中数据行对应字节</strong></p>

<p>最后选择 SlotData 的 数据行中，根据行中偏移地址 offset 选出4 个字节中所需的一个。</p>

<p><img src="/assets/blog_image/2020-10-19-hust-cpu-study_3/image-20201029220202056.png" alt="image-20201029220202056" /></p>

<p>HIT 作为 命中判断，若没有命中，就不会选出。</p>

<p><strong>遇到问题</strong></p>

<p><img src="/assets/blog_image/2020-10-19-hust-cpu-study_3/image-20201029232824036.png" alt="image-20201029232824036" />
预期和我的实际输出不同在于，缺失后，从二级存储器载入数据后，本来此时 blkok 信号应该为0，但是现在为什么还是显示 块数据 blkok为 1啊？</p>

<p><strong>经过 8 小时的探寻，终于找到问题!!!</strong></p>

<p>寄存器的触发方式分为上升沿、下降沿、高电平、低电平。</p>

<ul>
  <li>上升沿 ： 当时钟信号从 0 到 1 变化时，寄存器更新其值</li>
  <li>下降沿 ： 当时钟信号从 1 到 0 变化时，寄存器更新其值</li>
  <li>高电平：当时钟信号为 1 时，寄存器不断更新其值</li>
  <li>低电平：当时钟信号为 0 时，寄存器不断更新其值</li>
</ul>

<p><img src="/assets/blog_image/2020-10-19-hust-cpu-study_3/image-20201030194518157-1604071290959.png" alt="image-20201030194518157" /></p>

<p>而由于此处的自动测试电路中，所有的计数器、寄存器全为 上升沿，因此应当将 直接相联 中的 寄存器也改为 上升沿！</p>

<p><strong>最终完成电路</strong></p>

<p><img src="/assets/blog_image/2020-10-19-hust-cpu-study_3/image-20201030205604127.png" alt="image-20201030205604127" /></p>

<p>最终成果展示</p>

<p><img src="/assets/blog_image/2020-10-19-hust-cpu-study_3/image-20201031130225746.png" alt="image-20201031130225746" /></p>

<h4 id="3直接相联特点">3.直接相联特点</h4>

<ul>
  <li>块映射速度快 ，一对一映射， 无须查表
    <ul>
      <li>利用索引字段直接对比相应标记位即可</li>
      <li>查找表可以和副本一起存放 ，无需相联存储器</li>
    </ul>
  </li>
  <li>cache 容易冲突 ，cache利用率低</li>
  <li>淘汰算法简单</li>
  <li>命中率低 ，适合大容量 cache</li>
</ul>

<h3 id="5全相联-cache-设计">5、全相联 Cache 设计</h3>

<h4 id="1全相联介绍">1.全相联介绍</h4>

<p>全相联映射是主存地址随机存储在<strong>任意的<em>cache</em>行</strong>，也就是只要是空行就可以进行存储，没有选择。然后通过标记位地址与8个<em>cache</em>槽中的标记位进行比较，判断是否命中，选择具体的1个<em>cache</em>槽；再通字内偏移地址，选择该<em>cache</em>槽中的单个字节来进行写入和写出的操作。</p>

<p>全相联映射需要做好淘汰算法。此处采用 LRU ：数据淘汰时，应采用 LRU 计数器值最大的 Cache 行 进行淘汰。为提升速度，需要若干个比较器并发比较。</p>

<p>Cache 分为 CAM 和 SRAM 两部分。</p>

<p><img src="/assets/blog_image/2020-10-19-hust-cpu-study_3/image-20201030195520348.png" alt="image-20201030195520348" /></p>

<p>字节地址和cache槽的设计、写入和写出设计、比较设计、淘汰算法设计。</p>

<p><img src="/assets/blog_image/2020-10-19-hust-cpu-study_3/image-20201030200919012.png" alt="image-20201030200919012" /></p>

<h4 id="2实验步骤-1">2.实验步骤</h4>

<p><strong>1、字节地址设计</strong></p>

<p>由下图可知，输入到 全相联映射的 Cache 槽前半部分（主存地址）为 16 位，直接映射分为 标志位 + 块内字节偏移</p>

<p>因为块数据输入为 32 位 即 4 字节，而由于输出 Dataout 为 8 位，即按照 字节 进行输出，因此 行内字节偏移 在 Cache  槽中占 2 位。</p>

<p>其余 14 位全部作为区号 tag</p>

<p><img src="/assets/blog_image/2020-10-19-hust-cpu-study_3/image-20201030202249341.png" alt="image-20201030202249341" /></p>

<p>先将主存地址进行分割，作为 Cache 槽的前半部分。</p>

<p><strong>2、Cache槽的设计</strong></p>

<p>现在开始设计 Cache 槽。<em>cache</em>  主要包含四部分：Valid标志、主存 Tag 标记位、淘汰计数标记、数据副本。而我们需要考虑的主要是前三部分，并且这三部分和之后的设计息息相关。</p>

<ul>
  <li>当中 valid 位有效位，判断该 cache 槽是否被命中过，存入了数据；</li>
  <li>Tag 位是存入的主存标记位；</li>
  <li><strong>淘汰计数是一个计数器</strong>，初值为0，若行命中标志 Li 有效时，读入数据 0，达到清零的效果，若Li无效，则随着时钟频率一直进行计数。（与后面的淘汰算法密切相关）。而数据副本通过三态门缓冲器连接到总结上，这里三态门缓冲器的作用是当Li行有效时，将数据副本中输出的数据进行缓存，也就是使8个chche槽中的数据都可以缓存到1个Solt，这里就实现了总线的作用，十分优化。 这里给出了一个cache槽，其余的进行类似的复制。</li>
</ul>

<p><img src="/assets/blog_image/2020-10-19-hust-cpu-study_3/image-20201031124014056.png" alt="image-20201031124014056" /></p>

<p><strong>值得注意的是：</strong></p>

<ol>
  <li>
    <p>为什么直接相联映射采用 L0 控制 V0、T0 的三态门，全相联直接输出？</p>

    <p>因为此时 L0 由 V0 和 T0 决定 ，而之前采用的是 Cache 选择控制（直接相联由 字节地址中的 第 2-4 位直接选择 Lx，而全相联需要并发比较各个标志位进行选择），此处为避免死循环，就不采用三态门。</p>
  </li>
  <li>
    <p>计数器的清空设置：</p>

    <p>如下图，当选择该行时，需要将计数器重置。</p>

    <p><img src="/assets/blog_image/2020-10-19-hust-cpu-study_3/image-20201031124750585.png" alt="image-20201031124750585" /></p>
  </li>
</ol>

<p><strong>3、写入和写出设计</strong></p>

<ol>
  <li>
    <p>写出设计即通过字内偏移地址 <em>Offset</em> 进行选择总线 <em>Slot</em> 上的某一字节进行输出。</p>

    <p><img src="/assets/blog_image/2020-10-19-hust-cpu-study_3/image-20201031124922703.png" alt="image-20201031124922703" /></p>
  </li>
  <li>
    <p>写入设计则要当 <em>BlkReady</em> 数据准备完成时（测试电路中的数据准备）选择具体的cache行进行写入，而写入的前提是<strong>该行为空，</strong>即 <em>Miss</em> 信号有效，才能写入数据。</p>

    <p><img src="/assets/blog_image/2020-10-19-hust-cpu-study_3/image-20201031124953354.png" alt="image-20201031124953354" /></p>
  </li>
  <li>
    <p>写入行的判断</p>
    <ul>
      <li>若存在空行，即 <em>FULL</em> 信号无效，则选择相应的空行进行写入；</li>
      <li>若<em>FULL</em>信号有效，则<strong>选择淘汰的行</strong>进行写入。两种情况都为之后的淘汰算法中选出的行号。</li>
    </ul>
  </li>
</ol>

<p><strong>4、判断是否命中。————即比较设计</strong></p>

<p>对于第 3 点的写入写出需要进行判断，即比较设计来判断是否命中。</p>

<p>不同的映射模式最大的区别就在于比较设计上。全相联因为是随机选取的 <em>cache</em> 行进行写入，因此没有行地址（索引），因此直接进行 8 个 <em>cache</em> 槽的<strong>并发比较</strong>，得到命中的<em>cache</em>行<em>Li</em>，并给出<em>Miss</em>和<em>Hit</em>信号。比较方法如图所示。</p>

<p><img src="/assets/blog_image/2020-10-19-hust-cpu-study_3/image-20201031125151050.png" alt="image-20201031125151050" /></p>

<p><strong>若命中，那么 HIT 信号为 1 ，则开始上文提到的 SlotData 输出显示。</strong></p>

<p><strong>若没有命中，那么 Miss 变为 1 ，开始进行淘汰算法，来选出相应的行。</strong></p>

<p><img src="/assets/blog_image/2020-10-19-hust-cpu-study_3/image-20201031124922703.png" alt="image-20201031124922703" /></p>

<p><strong>5、淘汰算法</strong></p>

<p>淘汰算法分为两个部分，</p>

<ul>
  <li>一个是当存在 cache 槽为空，空行的选择；</li>
  <li>一个是当 cache 槽满时，淘汰行的选择</li>
</ul>

<ol>
  <li>
    <p><strong>槽存在空</strong></p>

    <p>在空行的选择中，通过优先比较器来实现，优先比较器通过比较，<strong>输出的是索引较大的非 0 行</strong>，因此先对所有行的标志位取反，取反后，若为1，则表示该行为空；若为0，则表示该行已经存在数据。若所有行都存在数据则 <em>FULL</em> 行满信号有效。</p>
  </li>
</ol>

<blockquote>
  <p>优先编码器</p>

  <ul>
    <li>当多个引脚同时为 1 时，输出最大的那个编号</li>
    <li>当使能端为</li>
  </ul>

  <p><img src="/assets/blog_image/2020-10-19-hust-cpu-study_3/image-20201030232110636.png" alt="image-20201030232110636" /></p>

  <p>优先编码器组件还包含一个 使能输入端 和 使能输出端 。</p>

  <ul>
    <li>只要 使能输入端 为 0 ,则该组件处于关闭状态,输出为不确定值。</li>
    <li>当使能输入端为1,且输入引脚都不是1,则使能输出为 1 。
      <ul>
        <li>因此，可以串联两个优先编码器，使第一个编码器的使能输出端连接到第二个编码器的使能输入端。</li>
        <li>如果第一个编码器有任意一个输入引脚值为1,则第二个优先编码器将会被关闭，输出为不确定值。</li>
        <li>当第一个编码器没有引脚输入为1时，其输出为不确定值，此时第二个编
码器将会被开启，并输出最高优先级请求(输入为1)的编号。</li>
        <li>优先编码器的这种设计，可以方便地将多个优先编码器串联起来使用以达到扩充输入的目的。</li>
        <li><img src="/assets/blog_image/2020-10-19-hust-cpu-study_3/image-20201030233136105.png" alt="image-20201030233136105" /></li>
      </ul>
    </li>
    <li>优先级编码器的另外一个输出（右下角）表示优先编码器有输入请求，当优先编码器使能输入为 1 ，且输入引脚中有 1 时，其输出为1。当多个优先编码器串联在一起使用时，这个输出可以用于判断哪个优先编码器被触发。</li>
    <li><img src="/assets/blog_image/2020-10-19-hust-cpu-study_3/image-20201030233127124.png" alt="image-20201030233127124" /></li>
  </ul>
</blockquote>

<p>通过优先编码器选出索引值最大空Cache槽，或者输出 FULL</p>

<p><img src="/assets/blog_image/2020-10-19-hust-cpu-study_3/image-20201031123143625.png" alt="image-20201031123143625" /></p>

<ol>
  <li>
    <p><strong>槽满时</strong></p>

    <p>​在淘汰行的选择中，主要运用到LRU淘汰算法（即最近最少使用淘汰算法），由于我们在 cache 槽设计中的计数器是当行选中时清零，行为选中时随时钟频率进行计数，因此这里计数的最大值即为最少使用的cache槽。 而我们用文件中附带的归并算法，这里的归并算法是输出两个值中较大的一位的数据和索引，最后得到相应的淘汰行。</p>

    <p>​由于是要输出 三位编码，因此选择 MAX3，其内部电路如图所示</p>

    <p>​其中 Y# 是指明 三位长度（12字节）的编号。只是为了后面的译码器根据选出的 三位长度 地址进行位号选择。</p>

    <p><img src="/assets/blog_image/2020-10-19-hust-cpu-study_3/image-20201030234059000.png" alt="image-20201030234059000" /></p>

    <p>且由于此处提供的 MAX3 进行比较的数值（ cnt 时钟计数）为 16 字节长度。因此计时器记录为 16位长度。</p>

    <p><img src="/assets/blog_image/2020-10-19-hust-cpu-study_3/image-20201031123709802.png" alt="image-20201031123709802" /></p>

    <p><strong>并发淘汰比较如下</strong></p>

    <p><img src="/assets/blog_image/2020-10-19-hust-cpu-study_3/image-20201031123157656.png" alt="image-20201031123157656" /></p>
  </li>
</ol>

<p>最终电路实现如下</p>

<p><img src="/assets/blog_image/2020-10-19-hust-cpu-study_3/image-20201031125848931.png" alt="image-20201031125848931" /></p>

<p>最终成果展示</p>

<p><img src="/assets/blog_image/2020-10-19-hust-cpu-study_3/image-20201031130154424.png" alt="image-20201031130154424" /></p>

<h4 id="3全相联特点">3.全相联特点</h4>

<ul>
  <li>块映射灵活 ，一对多映射</li>
  <li>cache全部装满后才会出现块冲突</li>
  <li>块冲突的概率低 ，cache 利用率高</li>
  <li>淘汰算法复杂</li>
  <li>命中率高。</li>
</ul>

<h3 id="64-路组相联-cache-设计">6、4 路组相联 Cache 设计</h3>

<h4 id="1组相联介绍">1.组相联介绍</h4>

<p>​组相联映射是直接相联映射和全相联映射的折中，或者说后两者是前者的特例。Cache 仍然分为 相联存储器CAM 和 SRAM两部分，其中 CAM 用于存放标记信息， SRAM 存放数据副本。 Cache 划分成若干组，每组若干 Cache 行。
   ​主存地址被划分为Tag、index、offset 三部分，由索引字段 index 经过组索引译码器产生组选中译码信号（选组是采用直接映射），CAM 中对应组有效位 和 标记信息 传输到多路并发比较器，每组多少行就需要设置多少个比较器（即组内可以全选）。例如，当前组某行的标记位与主存地址中的标记位相同且有效位为 1 时，则Cache命中。</p>

<p><img src="/assets/blog_image/2020-10-19-hust-cpu-study_3/image-20201101211653700.png" alt="image-20201101211653700" /></p>

<p>选组是直接映射，选组内的行是全映射。</p>

<p><img src="/assets/blog_image/2020-10-19-hust-cpu-study_3/image-20201101205708957.png" alt="image-20201101205708957" /></p>

<p>将多路并发比较结果信号与组索引译码输出信号分别进行逻辑与后得到 Cache 行选择信号（如下图） 2 路并发比较信号与 4 根组索引译码输出信号分别进行逻辑与后得到 8 根行选择信号。Cache 行选中后,读写逻辑和其他映射方式基本一致。数据淘汰时,应该在指定的组内寻找 LRU 计数器值最大的 Cache 行进行淘汰。组相联映射与全相联映射相比，其多路比较器的复杂度更低。</p>

<p>当每组只有一个Cache行时,只需要一个比较器,电路演变成直接相联映射。当整个Cache只有二组时,无须组索引译码器,电路演变成全相联映射。</p>

<p><img src="/assets/blog_image/2020-10-19-hust-cpu-study_3/image-20201101205807648.png" alt="image-20201101205807648" /></p>

<p>现在来说说 4 路组相联。k 路取决于每一组中有多少行。此处便是一组中有四行。</p>

<h4 id="2实验步骤-2">2.实验步骤</h4>

<p><strong>1、字节地址设计</strong></p>

<p>由下图可知，输入到 4 路组相联映射的 Cache 槽前半部分（主存地址）为 16 位，主存地址被划分为Tag、index、offset 三部分。</p>

<p>因为块数据输入为 32 位 即 4 字节，而由于输出 Dataout 为 8 位，即按照 字节 进行输出，因此 行内字节偏移即 offset 在 Cache  槽中占 2 位。</p>

<p>index 指示直接映射的组号，一组中有 4 行，共有 2 组，因此为 1 位。</p>

<p>其余 13 位全部作为区号 tag</p>

<p><img src="/assets/blog_image/2020-10-19-hust-cpu-study_3/image-20201101233859611.png" alt="image-20201101233859611" /></p>

<p>先将主存地址进行分割，作为 Cache 槽的前半部分。</p>

<p><strong>2、Cache槽的设计</strong></p>

<p>现在开始设计 Cache 槽。<em>cache</em>  主要包含四部分：Valid标志、主存 Tag 标记位、淘汰计数标记、数据副本。而我们需要考虑的主要是前三部分，并且这三部分和之后的设计息息相关。</p>

<ul>
  <li>当中 valid 位有效位，判断该 cache 槽是否被命中过，存入了数据；</li>
  <li>Tag 位是存入的主存标记位；</li>
  <li><strong>淘汰计数是一个计数器</strong>，初值为0，若行命中标志 Li 有效时，读入数据 0，达到清零的效果，若Li无效，则随着时钟频率一直进行计数。（与后面的淘汰算法密切相关）。而数据副本通过三态门缓冲器连接到总结上，这里三态门缓冲器的作用是当Li行有效时，将数据副本中输出的数据进行缓存，也就是使 8 个chche槽中的数据都可以缓存到1个Solt，这里就实现了总线的作用，十分优化。 这里给出了一个cache槽，其余的进行类似的复制。</li>
</ul>

<p><img src="/assets/blog_image/2020-10-19-hust-cpu-study_3/image-20201031124014056.png" alt="image-20201031124014056" /></p>

<p><strong>值得注意的是：</strong></p>

<ol>
  <li>
    <p>为什么直接相联映射采用 L0 控制 V0、T0 的三态门，全相联直接输出？</p>

    <p>因为此时 L0 由 V0 和 T0 决定 ，而之前采用的是 Cache 选择控制（直接相联由 字节地址中的 第 2-4 位直接选择 Lx，而全相联需要并发比较各个标志位进行选择），此处为避免死循环，就不采用三态门。</p>
  </li>
  <li>
    <p>计数器的清空设置：</p>

    <p>如下图，当选择该行时，需要将计数器重置。</p>

    <p><img src="/assets/blog_image/2020-10-19-hust-cpu-study_3/image-20201031124750585.png" alt="image-20201031124750585" /></p>
  </li>
</ol>

<p><strong>3、写入和写出设计</strong></p>

<ol>
  <li>
    <p>写出设计即通过字内偏移地址 <em>Offset</em> 进行选择总线 <em>Slot</em> 上的某一字节进行输出。</p>

    <p><img src="/assets/blog_image/2020-10-19-hust-cpu-study_3/image-20201031124922703.png" alt="image-20201031124922703" /></p>
  </li>
  <li>
    <p>写入设计则要当 <em>BlkReady</em> 数据准备完成时（测试电路中的数据准备）选择具体的cache行进行写入，而写入的前提是<strong>该行为空，</strong>即 <em>Miss</em> 信号有效，才能写入数据。</p>

    <p><img src="/assets/blog_image/2020-10-19-hust-cpu-study_3/image-20201101230536977.png" alt="image-20201101230536977" /></p>
  </li>
  <li>
    <p>写入行的判断：</p>

    <ul>
      <li>若存在空行，即 <em>FULL</em> 信号无效，则选择相应的空行进行写入；</li>
      <li>若<em>FULL</em>信号有效，则<strong>选择淘汰的行</strong>进行写入。两种情况都为之后的淘汰算法中选出的行号。</li>
    </ul>
  </li>
</ol>

<p><strong>4、判断是否命中。————即比较设计</strong></p>

<p>​  对于第 3 点的写入写出需要进行判断，即比较设计来判断是否命中。</p>

<p>​  不同的映射模式最大的区别就在于比较设计上。4 路组相联因为是随机选取的 <em>cache</em> 行进行写入，因此没有行地址（索引），因此直接进行 4 个 <em>cache</em> 槽的<strong>并发比较</strong>，得到命中的 <em>Cache</em> 行<em>Li</em>，并给出 <em>Miss</em> 和 <em>Hit</em> 信号。</p>

<p>​  4 行进行比较，通过 index 进行选择哪一组进行并行输出。两组中，只要有一组成功，那么 HIT。</p>

<p>比较方法如图所示。</p>

<p><img src="/assets/blog_image/2020-10-19-hust-cpu-study_3/image-20201101230941941.png" alt="image-20201101230941941" /></p>

<p><strong>若命中，那么 HIT 信号为 1 ，则开始上文提到的 SlotData 输出显示。</strong></p>

<p><strong>若没有命中，那么 Miss 变为 1 ，开始进行淘汰算法，来选出相应的行。</strong></p>

<p><img src="/assets/blog_image/2020-10-19-hust-cpu-study_3/image-20201031124922703.png" alt="image-20201031124922703" /></p>

<p><strong>5、淘汰算法</strong></p>

<p>淘汰算法分为两个部分，</p>

<ul>
  <li>一个是当存在 cache 槽为空，空行的选择</li>
  <li>一个是当 cache 槽满时，淘汰行的选择</li>
</ul>

<ol>
  <li>
    <p><strong>槽存在空</strong></p>

    <p>在空行的选择中，通过优先比较器来实现，优先比较器通过比较，<strong>输出的是索引较大的非 0 行</strong>，因此先对所有行的标志位取反，取反后，若为1，则表示该行为空；若为0，则表示该行已经存在数据。若所有行都存在数据则 <em>FULL</em> 行满信号有效。</p>
  </li>
</ol>

<p>通过优先编码器选出索引值最大空 Cache 槽，或者输出 FULL</p>

<p><img src="/assets/blog_image/2020-10-19-hust-cpu-study_3/image-20201101230926431.png" alt="image-20201101230926431" /></p>

<ol>
  <li>
    <p><strong>槽满时</strong></p>

    <p>在淘汰行的选择中，主要运用到LRU淘汰算法（即最近最少使用淘汰算法），由于我们在 cache 槽设计中的计数器是当行选中时清零，行为选中时随时钟频率进行计数，因此这里计数的最大值即为最少使用的cache槽。 而我们用文件中附带的归并算法，这里的归并算法是输出两个值中较大的一位的数据和索引，最后得到相应的淘汰行。</p>

    <p>由于是要输出 二位编码，因此选择 MAX2，其内部电路如图所示</p>

    <p>其中 Y# 是指明 二位长度（ 表示 4 个）的编号。只是为了后面的译码器根据选出的 二位长度 地址进行位号选择。</p>

    <p><img src="/assets/blog_image/2020-10-19-hust-cpu-study_3/image-20201101230739467.png" alt="image-20201101230739467" /></p>

    <p>且由于此处提供的 MAX2 进行比较的数值（ cnt 时钟计数）为 16 字节长度。因此计时器记录为 16位长度。</p>

    <p><img src="/assets/blog_image/2020-10-19-hust-cpu-study_3/image-20201031123709802.png" alt="image-20201031123709802" /></p>

    <p><strong>并发淘汰比较如下</strong></p>

    <p><img src="/assets/blog_image/2020-10-19-hust-cpu-study_3/image-20201101230638298.png" alt="image-20201101230638298" /></p>
  </li>
</ol>

<p>最终电路实现如下</p>

<p><img src="/assets/blog_image/2020-10-19-hust-cpu-study_3/image-20201101231426289.png" alt="image-20201101231426289" /></p>

<p>最终成果展示</p>

<p><img src="/assets/blog_image/2020-10-19-hust-cpu-study_3/image-20201101231441398.png" alt="image-20201101231441398" /></p>

<h3 id="72-路组相联-cache-设计">7、2 路组相联 Cache 设计</h3>

<p>现在来说说 2 路组相联。k 路取决于每一组中有多少行。此处便是一组中有二行。</p>

<h4 id="2实验步骤-3">2.实验步骤</h4>

<p><strong>1、字节地址设计</strong></p>

<p>由下图可知，输入到 4 路组相联映射的 Cache 槽前半部分（主存地址）为 16 位，主存地址被划分为Tag、index、offset 三部分。</p>

<p>因为块数据输入为 32 位 即 4 字节，而由于输出 Dataout 为 8 位，即按照 字节 进行输出，因此 行内字节偏移即 offset 在 Cache  槽中占 2 位。</p>

<p>index 指示直接映射的组号，一组中有 4 行，共有 2 组，因此为 1 位。</p>

<p>其余 13 位全部作为区号 tag</p>

<p><img src="/assets/blog_image/2020-10-19-hust-cpu-study_3/image-20201101233846009.png" alt="image-20201101233846009" /></p>

<p>先将主存地址进行分割，作为 Cache 槽的前半部分。</p>

<p><strong>2、Cache槽的设计</strong></p>

<p>现在开始设计 Cache 槽。<em>cache</em>  主要包含四部分：Valid标志、主存 Tag 标记位、淘汰计数标记、数据副本。而我们需要考虑的主要是前三部分，并且这三部分和之后的设计息息相关。</p>

<ul>
  <li>当中 valid 位有效位，判断该 cache 槽是否被命中过，存入了数据；</li>
  <li>Tag 位是存入的主存标记位；</li>
  <li><strong>淘汰计数是一个计数器</strong>，初值为0，若行命中标志 Li 有效时，读入数据 0，达到清零的效果，若Li无效，则随着时钟频率一直进行计数。（与后面的淘汰算法密切相关）。而数据副本通过三态门缓冲器连接到总结上，这里三态门缓冲器的作用是当Li行有效时，将数据副本中输出的数据进行缓存，也就是使 8 个chche槽中的数据都可以缓存到1个Solt，这里就实现了总线的作用，十分优化。 这里给出了一个cache槽，其余的进行类似的复制。</li>
</ul>

<p><img src="/assets/blog_image/2020-10-19-hust-cpu-study_3/image-20201102003247656.png" alt="image-20201102003247656" /></p>

<p><strong>值得注意的是：</strong></p>

<ol>
  <li>
    <p>为什么直接相联映射采用 L0 控制 V0、T0 的三态门，全相联直接输出？</p>

    <p>因为此时 L0 由 V0 和 T0 决定 ，而之前采用的是 Cache 选择控制（直接相联由 字节地址中的 第 2-4 位直接选择 Lx，而全相联需要并发比较各个标志位进行选择），此处为避免死循环，就不采用三态门。</p>
  </li>
  <li>
    <p>计数器的清空设置：</p>

    <p>如下图，当选择该行时，需要将计数器重置。</p>

    <p><img src="/assets/blog_image/2020-10-19-hust-cpu-study_3/image-20201031124750585.png" alt="image-20201031124750585" /></p>
  </li>
  <li>
    <p>此处<strong>清零中的毛刺问题解决：</strong> 清零动作改成同步清零，具体可以增加一个D触发器，将清零信号接输入，输出接异步清零，另外D触发器时钟触发方式请修改为上跳沿。</p>
  </li>
</ol>

<p><strong>3、写入和写出设计</strong></p>

<ol>
  <li>
    <p>写出设计即通过字内偏移地址 <em>Offset</em> 进行选择总线 <em>Slot</em> 上的某一字节进行输出。</p>

    <p><img src="/assets/blog_image/2020-10-19-hust-cpu-study_3/image-20201031124922703.png" alt="image-20201031124922703" /></p>
  </li>
  <li>
    <p>写入设计则要当 <em>BlkReady</em> 数据准备完成时（测试电路中的数据准备）选择具体的cache行进行写入，而写入的前提是<strong>该行为空，</strong>即 <em>Miss</em> 信号有效，才能写入数据。</p>
  </li>
  <li>
    <p>写入行的判断：</p>

    <ul>
      <li>
        <p>若存在空行，即 <em>FULL</em> 信号无效，则选择相应的空行进行写入；</p>
      </li>
      <li>
        <p>若<em>FULL</em>信号有效，则<strong>选择淘汰的行</strong>进行写入。两种情况都为之后的淘汰算法中选出的行号。</p>
      </li>
    </ul>
  </li>
</ol>

<p><strong>4、判断是否命中。————即比较设计</strong></p>

<p>​  对于第 3 点的写入写出需要进行判断，即比较设计来判断是否命中。</p>

<p>​  不同的映射模式最大的区别就在于比较设计上。2 路组相联因为是随机选取的 <em>cache</em> 行进行写入，因此没有行地址（索引），因此直接进行 2 个 <em>cache</em> 槽的<strong>并发比较</strong>，得到命中的 <em>Cache</em> 行<em>Li</em>，并给出 <em>Miss</em> 和 <em>Hit</em> 信号。</p>

<p>​  4 行进行比较，通过 index 进行选择哪一组进行并行输出。两组中，只要有一组成功，那么 HIT。</p>

<p>比较方法如图所示。</p>

<p><img src="/assets/blog_image/2020-10-19-hust-cpu-study_3/image-20201102004314424.png" alt="image-20201102004314424" /></p>

<p><strong>若命中，那么 HIT 信号为 1 ，则开始上文提到的 SlotData 输出显示。</strong></p>

<p><strong>若没有命中，那么 Miss 变为 1 ，开始进行淘汰算法，来选出相应的行。</strong></p>

<p><img src="/assets/blog_image/2020-10-19-hust-cpu-study_3/image-20201031124922703.png" alt="image-20201031124922703" /></p>

<p><strong>5、淘汰算法</strong></p>

<p>淘汰算法分为两个部分，</p>

<ul>
  <li>一个是当存在 cache 槽为空，空行的选择</li>
  <li>一个是当 cache 槽满时，淘汰行的选择</li>
</ul>

<ol>
  <li>
    <p><strong>槽存在空</strong></p>

    <p>在空行的选择中，通过优先比较器来实现，优先比较器通过比较，<strong>输出的是索引较大的非 0 行</strong>，因此先对所有行的标志位取反，取反后，若为1，则表示该行为空；若为0，则表示该行已经存在数据。若所有行都存在数据则 <em>FULL</em> 行满信号有效。</p>
  </li>
</ol>

<p>通过优先编码器选出索引值最大空 Cache 槽，或者输出 FULL</p>

<p><img src="/assets/blog_image/2020-10-19-hust-cpu-study_3/image-20201102004250871.png" alt="image-20201102004250871" /></p>

<ol>
  <li>
    <p><strong>槽满时</strong></p>

    <p>在淘汰行的选择中，主要运用到LRU淘汰算法（即最近最少使用淘汰算法），由于我们在 cache 槽设计中的计数器是当行选中时清零，行为选中时随时钟频率进行计数，因此这里计数的最大值即为最少使用的cache槽。 而我们用文件中附带的归并算法，这里的归并算法是输出两个值中较大的一位的数据和索引，最后得到相应的淘汰行。</p>

    <p>由于是要输出 二位编码，因此选择 MAX2，其内部电路如图所示</p>

    <p>其中 Y# 是指明 二位长度（ 表示 4 个）的编号。只是为了后面的译码器根据选出的 二位长度 地址进行位号选择。</p>

    <p>MAX1 实则是对 MAX2 进行 X#、Y# 字节的更改。</p>

    <p><img src="/assets/blog_image/2020-10-19-hust-cpu-study_3/image-20201102004207591.png" alt="image-20201102004207591" /></p>

    <p>且由于此处提供的 MAX2 进行比较的数值（ cnt 时钟计数）为 16 字节长度。因此计时器记录为 16位长度。</p>

    <p><img src="/assets/blog_image/2020-10-19-hust-cpu-study_3/image-20201031123709802.png" alt="image-20201031123709802" /></p>

    <p><strong>并发淘汰比较如下</strong></p>

    <p><img src="/assets/blog_image/2020-10-19-hust-cpu-study_3/image-20201102004226750.png" alt="image-20201102004226750" /></p>
  </li>
</ol>

<p>最终电路实现</p>

<p><img src="/assets/blog_image/2020-10-19-hust-cpu-study_3/image-20201102004513904.png" alt="image-20201102004513904" /></p>

<p>测试电路</p>

<p><img src="/assets/blog_image/2020-10-19-hust-cpu-study_3/image-20201102004536562.png" alt="image-20201102004536562" /></p>

<h4 id="3组相联特点">3.组相联特点</h4>

<p>组相联应用场合</p>

<ul>
  <li>容量小的 cache 可采用全相联映射 或组相联映射
    <ul>
      <li>Pentium CPU L1 L2 cache</li>
    </ul>
  </li>
  <li>容量大的可采用直接映射方式
    <ul>
      <li>查找速度快 ，命中率相对低</li>
      <li>但cache 容量大可提高命中率</li>
      <li>块设备缓存</li>
    </ul>
  </li>
</ul>]]></content><author><name></name></author><category term="cpu" /></entry><entry><title type="html">自己动手画 CPU《计算机组织与结构实验》（二）</title><link href="/cpu/2020/10/04/hust-cpu-study_2.html" rel="alternate" type="text/html" title="自己动手画 CPU《计算机组织与结构实验》（二）" /><published>2020-10-04T23:16:34+00:00</published><updated>2020-10-04T23:16:34+00:00</updated><id>/cpu/2020/10/04/hust-cpu-study_2</id><content type="html" xml:base="/cpu/2020/10/04/hust-cpu-study_2.html"><![CDATA[<ul id="markdown-toc">
  <li><a href="#二运算器组成实验" id="markdown-toc-二运算器组成实验">二、运算器组成实验</a>    <ul>
      <li><a href="#1-可控加减法电路设计实验" id="markdown-toc-1-可控加减法电路设计实验">1. 可控加减法电路设计实验</a></li>
      <li><a href="#2-4-位先行进位74182" id="markdown-toc-2-4-位先行进位74182">2. 4 位先行进位74182</a></li>
      <li><a href="#3-4-位快速加法器设计" id="markdown-toc-3-4-位快速加法器设计">3. 4 位快速加法器设计</a></li>
      <li><a href="#4-16-位快速加法器设计" id="markdown-toc-4-16-位快速加法器设计">4. 16 位快速加法器设计</a></li>
      <li><a href="#5--32-位快速加法器设计" id="markdown-toc-5--32-位快速加法器设计">5.  32 位快速加法器设计</a></li>
      <li><a href="#6-32-位-alu设计实验" id="markdown-toc-6-32-位-alu设计实验">6. 32 位 ALU设计实验</a></li>
      <li><a href="#7-5-位阵列乘法器" id="markdown-toc-7-5-位阵列乘法器">7. 5 位阵列乘法器</a>        <ul>
          <li><a href="#1前置背景" id="markdown-toc-1前置背景">1）前置背景</a></li>
          <li><a href="#2横向进位阵列乘法器" id="markdown-toc-2横向进位阵列乘法器">2）横向进位阵列乘法器</a></li>
          <li><a href="#3斜向进位阵列乘法器" id="markdown-toc-3斜向进位阵列乘法器">3）斜向进位阵列乘法器</a></li>
        </ul>
      </li>
      <li><a href="#8-6-位补码阵列乘法器" id="markdown-toc-8-6-位补码阵列乘法器">8. 6 位补码阵列乘法器</a></li>
      <li><a href="#9-5-位无符号乘法流水线" id="markdown-toc-9-5-位无符号乘法流水线">9. 5 位无符号乘法流水线</a></li>
      <li><a href="#10原码-1-位乘法器设计实验" id="markdown-toc-10原码-1-位乘法器设计实验">10.原码 1 位乘法器设计实验</a></li>
      <li><a href="#11补码-1-位乘法器设计实验" id="markdown-toc-11补码-1-位乘法器设计实验">11.补码 1 位乘法器设计实验</a></li>
    </ul>
  </li>
</ul>

<p><a href="https://www.icourse163.org/course/HUST-1205809816">配套慕课</a></p>

<h2 id="二运算器组成实验">二、运算器组成实验</h2>

<h3 id="1-可控加减法电路设计实验">1. 可控加减法电路设计实验</h3>

<p>1、背景知识</p>

<p>0）一位加法逻辑电路实现</p>

<ul>
  <li>0＋1=1  1＋0=1</li>
  <li>1＋1=0  0＋0=0</li>
  <li>因此：一个异或门即可实现 <strong>自动</strong> 一位加法</li>
</ul>

<p><strong>1）一位全加器的实现。</strong></p>

<p>一位全加器的表达式如下：</p>

<ol>
  <li>
    <p>Si = Xi ⊕ Yi ⊕ Cin</p>
  </li>
  <li>
    <p>Cout = XiYi + （Xi ⊕ Yi）Cin</p>
  </li>
</ol>

<p><img src="/assets/blog_image/2020-10-05-hust-cpu-study_2/20200501112325459.png" alt="20200501112325459" /></p>

<p><img src="/assets/blog_image/2020-10-05-hust-cpu-study_2/image-20201012162421462.png" alt="image-20201012162421462" style="zoom:67%;" /></p>

<p><strong>2）多位串行加法器</strong></p>

<p>判断溢出方式为：</p>

<ol>
  <li>
    <p>无符号数溢出判断：其实很简单，就一句话：</p>

    <p><em>当最高为向更高位有进位（或借位）时产生溢出</em></p>
  </li>
</ol>

<p>由于无符号数通常代表内存地址，这种情况下的溢出可以忽略。</p>

<ol>
  <li>
    <p>溢出只可能符号数溢出的情况，包括[X]补与[Y]补，[X]补与[-Y]补同号。</p>

    <p><strong>方法一</strong>：对操作数和运算结果的符号位进行检测，如果不相同则发生了溢出。</p>

    <p>设X0，Y0为运算数的符号位，S0为运算结果的符号位。</p>

    <p>逻辑表达式为：<strong>OF = X0Y0~S0 + ~X0~Y0S0</strong></p>

    <p>当OF = 1时发生溢出。</p>

    <p><strong>方法二</strong>：对<strong>最高数据位进位</strong>和<strong>符号位进位</strong>进行检测。</p>

    <p>设最高数据位产生的进位为C1，符号位产生的进位为C0.</p>

    <p>两个正数相加，此时C0 = 0，若C1 = 1，则改变了结果符号位。发生溢出。</p>

    <p>两个负数相加，此时C0 = 1， 若C1 = 0，则改变了结果符号位。发生溢出。</p>

    <p>逻辑表达式为：<strong>OF = C0⊕C1</strong></p>

    <p><strong>方法三</strong>：使用变形补码，给数据加上两位符号位，正常情况，符号位应该相同，如果运算后的结果两位符号位不同，则发生溢出。</p>
  </li>
</ol>

<p>电路图中的<strong>第一位全加器的低位进位</strong>默认是<strong>没有进位</strong>的，只有输入位。</p>

<p>本实验采用方法二，对于 <strong>最高数据位进位</strong> 和 <strong>符号位进位</strong> 两个位数进行异或检测</p>

<p><img src="/assets/blog_image/2020-10-05-hust-cpu-study_2/image-20201012162856622.png" alt="image-20201012162856622" /></p>

<p>3）8位可控加减法器</p>

<p>原理：</p>

<p>[X]补 - [Y]补 = [X - Y]补 = [X]补 + [-Y]补</p>

<p>[-Y]补 = [[Y]补]补</p>

<p>进行减法时，根据减法运算，需要把  [Y]补  转换为  [-Y]补 。转换规则与原码转补码相同，所以直接取反加一即可。</p>

<p>eg：[Y]补 = 10011    [-Y]补 = 01101</p>

<p>设计思路：加上一个 Sub 控制信号输入，输入数 Y 的所有位 Yi 均与 Sub 位进行<strong>异或</strong>后送入 全加器 中。</p>

<ul>
  <li>当 Sub = 0 时，送入为 Y 本身；</li>
  <li>当 Sub = 1 时，送入为 Y 的反码；且 Sub 位也连在加法器上，因此 Sub 为 1 时，直接取反码后再加上 1，而 Sub 为 0 时，进位 0 不影响加法结果</li>
</ul>

<p>最终实现如下</p>

<p>此时 Sub 位 为 0 ，表示加法（下侧运算指示由 LED 点阵表示）</p>

<p><img src="/assets/blog_image/2020-10-05-hust-cpu-study_2/image-20201012182232160.png" alt="image-20201012182232160" /></p>

<p>此时 Sub 位 为 1 ，表示减法</p>

<p><img src="/assets/blog_image/2020-10-05-hust-cpu-study_2/image-20201012182207063.png" alt="image-20201012182207063" /></p>

<h3 id="2-4-位先行进位74182">2. 4 位先行进位74182</h3>

<p>由于全加器公式如下，即高位运算取决于低位运算的输入 Ci-1。因此不能进行并行运算</p>

<ol>
  <li>Si = Xi ⊕ Yi ⊕ Cin</li>
  <li>Cout = XiYi + （Xi ⊕ Yi）Cin     /    Cout = XiYi + （Xi + Yi）Cin</li>
</ol>

<p><img src="/assets/blog_image/2020-10-05-hust-cpu-study_2/image-20201012233340803.png" alt="image-20201012233340803" /></p>

<p>即如上图可知，一般采用 4 位一组的先行进位方法。</p>

<p><img src="/assets/blog_image/2020-10-05-hust-cpu-study_2/v2-8a9142067020bc11d7a679b03c323b70_b.jpg" alt="v2-8a9142067020bc11d7a679b03c323b70_b" /></p>

<p>设 进位生成函数 Gi = XiYi， Pi = Xi  ⊕  Yi</p>

<p>由上图我们可以提取出以下公式</p>

<p>Ci = Gi + Pi*Ci-1</p>

<p>则</p>

<p><strong>C1 = G1 + P1*C0</strong></p>

<p>C2 = G2 + P2*C1</p>

<p>C3 = G3 + P3*C2</p>

<p>C4 = G4 + P4*C3</p>

<p>逐步带入可得</p>

<p><strong>C2 =</strong> G2 + P2*（ G1 + P1 * C0）</p>

<p>= <strong>G2 + P2G1 + P2P1C0</strong></p>

<p><strong>C3 =</strong> G3 + P3 *（G2 + P2G1 + P2P1C0）</p>

<p>= <strong>G3 + P3G2 + P3P2G1 + P3P2P1C0</strong></p>

<p><strong>C4 =</strong> G4 + P4*（G3 + P3G2 + P3P2G1 + P3P2P1C0）</p>

<p>= <strong>G4 + P4G3 + P4P3G2 + P4P3P2G1 + P4P3P2P1C0</strong></p>

<p><strong>这里可以发现各级的进位与其他进位无关</strong></p>

<p>而 所有的 P、G输入后需要 2T 的时间延迟；</p>

<p>又因为P、G输入需要一级门电路延迟，因此总输入为 3T 延迟。</p>

<p><img src="/assets/blog_image/2020-10-05-hust-cpu-study_2/image-20201013164402039.png" alt="image-20201013164402039" /></p>

<p>构造电路图如下</p>

<p><img src="/assets/blog_image/2020-10-05-hust-cpu-study_2/image-20201013163358078.png" alt="image-20201013163358078" /></p>

<p>现在已经得到 4 位的加速加法器，若想得到更多位宽电路，如 16 位加法器，最简单的方法便是将 4 个<strong>加法器进位链</strong> 进行串联，但是这样的话只能实现 4 位组内并行计算，组间还是串行。</p>

<p><img src="/assets/blog_image/2020-10-05-hust-cpu-study_2/image-20201013164415683.png" alt="image-20201013164415683" /></p>

<p>因此现在希望提高性能：</p>

<p>成组进位生成函数：<strong>G* = G4 + P4G3 + P4P3G2 + P4P3P2G1</strong></p>

<p>成组进位传递函数：<strong>P* = P4P3P2P1</strong></p>

<p>我们发现：<strong>C4 =</strong> <strong>G4 + P4G3 + P4P3G2 + P4P3P2G1 + P4P3P2P1C0</strong> <strong>= G* + P* C0</strong></p>

<p>即与之前提到的先行进位中的 <strong>C1 = G1 + P1*C0</strong> 形式完全一样！即只要提前得到  <strong>成组进位生成函数</strong>  和  <strong>成组进位传递函数</strong>，再复用 4 位先行进位电路即可。</p>

<p><img src="/assets/blog_image/2020-10-05-hust-cpu-study_2/image-20201013164443705.png" alt="image-20201013164443705" /></p>

<p>生成电路如下：</p>

<p><img src="/assets/blog_image/2020-10-05-hust-cpu-study_2/image-20201013163050767.png" alt="image-20201013163050767" /></p>

<h3 id="3-4-位快速加法器设计">3. 4 位快速加法器设计</h3>

<p>按照下图 74182 4 位加法器</p>

<p><img src="/assets/blog_image/2020-10-05-hust-cpu-study_2/image-20201013164443705.png" alt="image-20201013164443705" /></p>

<p>通过此处的与门异或门电路得到相应输入值，再输入即可</p>

<p><img src="/assets/blog_image/2020-10-05-hust-cpu-study_2/image-20201013184220192.png" alt="image-20201013184220192" /></p>

<p>实现电路如下</p>

<p>注意 ：C3 只是一个输出位。</p>

<p><img src="/assets/blog_image/2020-10-05-hust-cpu-study_2/image-20201013184345847.png" alt="image-20201013184345847" /></p>

<h3 id="4-16-位快速加法器设计">4. 16 位快速加法器设计</h3>

<p>主要思想便为：组内并行，组间并行。</p>

<p>设计思路较为简单，由上层 CLA74182 产生下层所需要的 C4、C8、C12，再并行运算得到各个进位，再输回4位快速加法器,得到 Cout 。</p>

<p>具体步骤是：底层加速加法器首先生成所有 P，G（时间延迟为 1T），接着产生 P*、G*（即输入进CLA的电路端，时间延迟为 2T），上层先行电路 CLA 通过 P、G、C0得到 C4、C8、C12 信号（时间延迟为 2T），此时下层加法器的所有输入信号都已经待续，经过内部的 C0 与其他信号的与门异或门（2T) 以及 S 的求和运算（P 与 C的异或，时间延迟为 1T），因此最终延迟为 8T。</p>

<p><img src="/assets/blog_image/2020-10-05-hust-cpu-study_2/image-20201013234414926.png" alt="image-20201013234414926" /></p>

<h3 id="5--32-位快速加法器设计">5.  32 位快速加法器设计</h3>

<p>思路与上面大致一样，不再赘述。</p>

<p><img src="/assets/blog_image/2020-10-05-hust-cpu-study_2/image-20201013235344233.png" alt="image-20201013235344233" /></p>

<h3 id="6-32-位-alu设计实验">6. 32 位 ALU设计实验</h3>

<p>【目标】</p>

<p>​利用前面实验封装好的32位加法器以及 Logisim 平台中现有运算部件，构建一个32位算术逻辑运算单元（禁用 Logisim  系统自带的加法器，减法器），可支持算术加、减、乘、除，逻辑与、或、非、异或运算、逻辑左移、逻辑右移、算术右移运算，支持常用程序状态标志（有符号溢出 OF 、无符号溢出 UOF ，结果相等 Equal ），ALU 功能以及输入输出引脚见下图。</p>

<p><img src="/assets/blog_image/2020-10-05-hust-cpu-study_2/image-20201014223905904.png" alt="image-20201014223905904" /></p>

<p>ALU 功能</p>

<p><img src="/assets/blog_image/2020-10-05-hust-cpu-study_2/v2-801bb6008e475f4e2a7fd3280c0e04a9_720w.jpg" alt="v2-801bb6008e475f4e2a7fd3280c0e04a9_720w" /></p>

<p>实现电路如下：</p>

<p>主要注意以下几处：</p>

<ol>
  <li>移位器采用分线器来得到 Y 的低五位</li>
  <li>减法的运用 32 位加法器时，需直接判断 X 是否 无符号大于 Y 即可。</li>
  <li>再就是 <strong>比较器</strong> 的设置！！！</li>
</ol>

<p><img src="/assets/blog_image/2020-10-05-hust-cpu-study_2/image-20201016202114284.png" alt="image-20201016202114284" /></p>

<p>选择器的运用</p>

<p><img src="/assets/blog_image/2020-10-05-hust-cpu-study_2/image-20201016195044233.png" alt="image-20201016195044233" /></p>

<p>折磨我一个小时的问题！！！！</p>

<p>比较器无符号的比较！！！</p>

<p><img src="/assets/blog_image/2020-10-05-hust-cpu-study_2/image-20201016194805245.png" alt="image-20201016194805245" /></p>

<p>最终测试结果</p>

<p><img src="/assets/blog_image/2020-10-05-hust-cpu-study_2/image-20201016193638163.png" alt="image-20201016193638163" /></p>

<h3 id="7-5-位阵列乘法器">7. 5 位阵列乘法器</h3>

<h4 id="1前置背景">1）前置背景</h4>

<p><strong>乘法实现</strong>类似于现实生活中的乘法方法(如下图)</p>

<p><img src="/assets/blog_image/2020-10-05-hust-cpu-study_2/image-20201018192345643.png" alt="image-20201018192345643" /></p>

<p>而相加数的得到需要考虑一位乘法的实现：</p>

<pre><code class="language-assembly">1×1=1
1×0=0
0×1=0
0x0=0
</code></pre>

<p>即类似与门</p>

<p><img src="/assets/blog_image/2020-10-05-hust-cpu-study_2/image-20201018192949489.png" alt="image-20201018192949489" /></p>

<p>由上图与门得到相加数，采用 25 个与门并发产生。————一级门延迟</p>

<h4 id="2横向进位阵列乘法器">2）横向进位阵列乘法器</h4>

<p><img src="/assets/blog_image/2020-10-05-hust-cpu-study_2/image-20201018192840020.png" alt="image-20201018192840020" /></p>

<p>易知延迟如上图（+T 表示与门的延迟时间）</p>

<p>实现电路如下</p>

<p><img src="/assets/blog_image/2020-10-05-hust-cpu-study_2/image-20201018193105942.png" alt="image-20201018193105942" /></p>

<p>其中加法器的各个接口如下：</p>

<p><img src="/assets/blog_image/2020-10-05-hust-cpu-study_2/image-20201018173828600.png" alt="image-20201018173828600" /></p>

<h4 id="3斜向进位阵列乘法器">3）斜向进位阵列乘法器</h4>

<p>我们发现横向进位加法器过于依赖进位，若改为斜向进位，那么只有最后一行需要依赖横向进位，能较好的提升乘法器性能。</p>

<p><img src="/assets/blog_image/2020-10-05-hust-cpu-study_2/image-20201018193220982.png" alt="image-20201018193220982" /></p>

<p>易知延迟如上图（+T 表示与门的延迟时间）</p>

<p>最终电路实现如下：</p>

<p><img src="/assets/blog_image/2020-10-05-hust-cpu-study_2/image-20201018193706273.png" alt="image-20201018193706273" /></p>

<p><code class="language-plaintext highlighter-rouge">注：目前主流CPU 采用更多硬件：利用 Booth 两位乘法 + 华莱士树 的方式构建乘法器</code></p>

<h3 id="8-6-位补码阵列乘法器">8. 6 位补码阵列乘法器</h3>

<p>补码想法便是利用之前的 5 位阵列乘法器。先对 乘数 进行补码（利用求补器和多路选择器），最后对结果进行再次求补后，再加上符号。</p>

<p><img src="/assets/blog_image/2020-10-05-hust-cpu-study_2/image-20201018200138792.png" alt="image-20201018200138792" /></p>

<p>至于图中的 -32 * 1 不能得出正确结果。由探针很容易明白原因。</p>

<h3 id="9-5-位无符号乘法流水线">9. 5 位无符号乘法流水线</h3>

<p>1.首先回忆之前的 <strong>五段流水线模拟</strong></p>

<p>同步清零，气泡，高电平有效</p>

<p>使能端，低电平有效，stall，高电平有效</p>

<p><img src="/assets/blog_image/2020-10-05-hust-cpu-study_2/image-20201005162854350.png" alt="image-20201005162854350" /></p>

<p>观察乘法线流水接口</p>

<p><img src="/assets/blog_image/2020-10-05-hust-cpu-study_2/image-20201018205020703.png" alt="image-20201018205020703" /></p>

<p>阵列乘法器流水线优化</p>

<p><img src="/assets/blog_image/2020-10-05-hust-cpu-study_2/image-20201018212238547.png" alt="image-20201018212238547" /></p>

<p>放大来看其中一个公式的实现，采用扩展器+加法器+移位器</p>

<p><img src="/assets/blog_image/2020-10-05-hust-cpu-study_2/image-20201018212150048.png" alt="image-20201018212150048" /></p>

<p>实现电路如下</p>

<p><img src="/assets/blog_image/2020-10-05-hust-cpu-study_2/image-20201018212034287.png" alt="image-20201018212034287" /></p>

<h3 id="10原码-1-位乘法器设计实验">10.原码 1 位乘法器设计实验</h3>

<p>原理</p>

<p><img src="/assets/blog_image/2020-10-05-hust-cpu-study_2/image-20201020223010992.png" alt="image-20201020223010992" /></p>

<p>提示：无符号1位乘法自动运算可分解为如下步骤。</p>

<ol>
  <li>
    <p>初始化时寄存器、X、Y值全为0，电路默认状态就是0；</p>
  </li>
  <li>
    <p>将引脚中的两个乘数X、Y分别载入对应的寄存器，X、Y的值应送到对应寄存器的数据输入端Xa、Ya，由于寄存器的数据载入需要时钟驱动，所以在第一个时钟到来时应该将X、Y的值分别载入对应的寄存器中，此部分逻辑属于时序逻辑。</p>
  </li>
  <li>
    <p>计算部分积<img src="/assets/blog_image/2020-10-05-hust-cpu-study_2/image-20201018230520622.png" alt="image-20201018230520622" style="zoom:67%;" />其中，是寄存器乏的输出，Adder.
Result 为加法器的运算结果输出，此部分核心电路是加法器，属于组合逻辑。</p>
  </li>
  <li>
    <p>加法器运算结果Adder.Result 逻辑右移1位送za，同时Adder.Result的最后1位加上寄存器Y的输出Yo.逻辑右移1位送 Yin，由于固定1位移位操作，所以不需要使用移位器，可直接使用Logisim平合中的分线器将对应数据分出，并且在高位补零即可实现逻辑右移，此部分逻辑属于组合逻辑。</p>

    <p>​需要注意的是（即如下图），Yin 在步骤（2）中接入的是Y引脚的值，所以Ya应该增加一个多路选择器进行数据输入选择，同时引入选择控制信号，具体实现时可利用计数器的值生成该选择控制信号，当计数器初始值为0时则多路选择器选择引脚Y的值送入Yin，不为0时则选择移位数据输入。</p>

    <p>​即需要注意 X Y 是分情况载入的。</p>

    <p><img src="/assets/blog_image/2020-10-05-hust-cpu-study_2/image-20201018230358332.png" alt="image-20201018230358332" /></p>
  </li>
  <li>
    <p>将移位后的数据载入 E、Y寄存器以便进行下一次运算，载入过程受时钟控制，属时序逻辑。</p>
  </li>
  <li>
    <p>根据时钟计数器的值判断运算是否结束，并生成停机信号（低电平有效），停机信号应用于控制所有寄存器的使能端，使得寄存器忽略时钟输入，保持结果值不变。需要注意的是，切勿采用将时钟信号与停机信号进行逻辑与的方式控制系统停机，对时钟进行任何门级操作都会带来意想不到的潜在错误，这是后续所有实验必须遵守的原则。</p>
  </li>
</ol>

<p><img src="/assets/blog_image/2020-10-05-hust-cpu-study_2/image-20201018225523447.png" alt="image-20201018225523447" /></p>

<p>移位可采用下面这种方式</p>

<p><img src="/assets/blog_image/2020-10-05-hust-cpu-study_2/image-20201018230724413.png" alt="image-20201018230724413" /></p>

<p>需要注意的是！！！</p>

<p>1、下图将 E 的最后一位移入到 Y’ 中。是有下列两个原因：</p>

<ol>
  <li>最后是两个寄存器保存最终 2n 长的值（类比 axdx）</li>
  <li>Y’ 的移位之后，高位不影响结果，因此可以放在高部。</li>
</ol>

<p><img src="/assets/blog_image/2020-10-05-hust-cpu-study_2/image-20201018230744726.png" alt="image-20201018230744726" /></p>

<p>2、Y的最后一位采用分线器读入。</p>

<p>3、引入一个计数器，ct 连接点与寄存器大致相同。</p>

<p>4、停机信号应用于控制所有寄存器的使能端，使得寄存器忽略时钟输入，保持结果值不变。切勿采用将时钟信号与停机信号进行逻辑与的方式控制系统停机，对时钟进行任何门级操作都会带来意想不到的潜在错误，这是后续所有实验必须遵守的原则。</p>

<p><img src="/assets/blog_image/2020-10-05-hust-cpu-study_2/image-20201019180227668.png" alt="image-20201019180227668" /></p>

<p>最终电路实现如下。</p>

<p><img src="/assets/blog_image/2020-10-05-hust-cpu-study_2/image-20201018224932971.png" alt="image-20201018224932971" /></p>

<h3 id="11补码-1-位乘法器设计实验">11.补码 1 位乘法器设计实验</h3>

<p>原理的推导</p>

<p>首先探讨补码的一位乘</p>

<p><img src="/assets/blog_image/2020-10-05-hust-cpu-study_2/image-20201020223010992.png" alt="image-20201020223010992" /></p>

<p>1、X 乘上 正数</p>

<p><img src="/assets/blog_image/2020-10-05-hust-cpu-study_2/image-20201019174715802.png" alt="image-20201019174715802" /></p>

<p>由于 Y 为正，所以 [Y]补 = Y</p>

<p>2、X 乘上 负数</p>

<p><img src="/assets/blog_image/2020-10-05-hust-cpu-study_2/image-20201020221531307.png" alt="image-20201020221531307" /></p>

<p><img src="/assets/blog_image/2020-10-05-hust-cpu-study_2/image-20201020221751091.png" alt="image-20201020221751091" /></p>

<p>现在思考这样一个定理： 一个数向左移动一位后（2倍）  –  自身  =  自身</p>

<p>引入一位 Yn+1，<strong>那么 Yn+1 初始值设为 0</strong>。可以得到下面式子转换。</p>

<p><img src="/assets/blog_image/2020-10-05-hust-cpu-study_2/image-20201020222123786.png" alt="image-20201020222123786" /></p>

<p><img src="/assets/blog_image/2020-10-05-hust-cpu-study_2/image-20201020221736106.png" alt="image-20201020221736106" style="zoom:80%;" /></p>

<p>现在将  2位  看作一个整体，即 YnYn+1、Yn-1Yn、… 1 2。</p>

<p>即   Yn+1-Yn –&gt;  Yn  、Yn-Yn-1 –&gt; Yn-1 …… 那么可以得到以下式子：</p>

<p><img src="/assets/blog_image/2020-10-05-hust-cpu-study_2/image-20201020222333818.png" alt="image-20201020222333818" style="zoom:80%;" /></p>

<p>再由于 当 Y 为 正数 时，符号位则为 0，即可以代入下图 Y0，然后将两个情况统一。</p>

<p><img src="/assets/blog_image/2020-10-05-hust-cpu-study_2/image-20201020223924682.png" alt="image-20201020223924682" /></p>

<p><strong>因此 这也可以解释为什么Booth里末两位为 10 时，要加[-X]补。 为什么 Y(n+1) - Yn = 1 (末两位01)的时候 要加[X]补。</strong></p>

<p>易知以下推导公式（ booth 一位乘法）</p>

<p><img src="/assets/blog_image/2020-10-05-hust-cpu-study_2/image-20201019174838295.png" alt="image-20201019174838295" /></p>

<p>与原码1位乘法不同，booth1位乘法中乘数采用<strong>双符号位</strong>参加运算，符号位也参与运算。利用 ∑ 存放部分积，i 为循环计数器，初始值为零，部分积累加公式为 ∑ =  ∑ +（Yn+1 - Yn ）[x]补，<strong>根据 Yn+1 与 Yn 的差值</strong>决定累加运算的参数是 0 还是 [X]补 或者是 [-X]补，<strong>注意最开始 Yn+1=0</strong>。运算完毕后，先判断循环次数是否达到，如未达到则部分积 ∑ 右移1位，Y 右移 1 位，然后继续循环累加，当乘数符号位参与运算后，运算结束，得到的乘积存放在 ∑ 和 Y 中，<strong>无须单独计算符号位</strong>。如果数值部分为 n 位，需要进行 n+1 次加法运算 和 n 次移位操作。</p>

<p><img src="/assets/blog_image/2020-10-05-hust-cpu-study_2/image-20201019175729836.png" alt="image-20201019175729836" /></p>

<p>​补码1位乘法的硬件逻辑结构如上图所示，图中寄存器 R0 存放部分积 ∑ ，寄存器 R1 存放乘数 Yn 以及扩展位 Yn+1（初始值为零），YnYn+1 为判断位(<strong>最低两位</strong>)；寄存器R2：存放被乘数X的补码；加法器实现部分积的累加，运算逻辑为</p>

<p><img src="/assets/blog_image/2020-10-05-hust-cpu-study_2/image-20201019175758692.png" alt="image-20201019175758692" style="zoom: 80%;" /></p>

<p>其中，一个操作数为  ∑ ，另一个操作数由判断位 YnYn+1 对多路选择器进行选择控制； 控制电路负责移位控制和循环计数。受时钟驱动，每运算一次，加法器运算结果与寄存器 R1 的值一起算术右移 1 位后产生的新值载入 R0 和 R1 寄存器中，当运算结束时，乘积的高 n 位数据在 R0 中，低 n 位在 R1 中， R1 中原来的乘数在右移过程中逐位移出寄存器。</p>

<ul>
  <li>乘数 x 取双符号位参与运算，部分积的初始值为0；</li>
  <li>乘数 y 取单符号位参与运算。</li>
</ul>

<p><img src="/assets/blog_image/2020-10-05-hust-cpu-study_2/image-20201019180208264.png" alt="image-20201019180208264" /></p>

<p>注意事项如下：</p>

<p>1、Yn+1 初始值为 0 。</p>

<p><img src="/assets/blog_image/2020-10-05-hust-cpu-study_2/image-20201019225303449.png" alt="image-20201019225303449" /></p>

<p>2、最高位与次高位一致</p>

<p><img src="/assets/blog_image/2020-10-05-hust-cpu-study_2/image-20201019225506071.png" alt="image-20201019225506071" /></p>

<p>3、负数取补 = 取反 + 1</p>

<p><img src="/assets/blog_image/2020-10-05-hust-cpu-study_2/image-20201019225543626.png" alt="image-20201019225543626" /></p>

<p>最终电路实现如下：（思路大致与原码 1 位一样）</p>

<p><img src="/assets/blog_image/2020-10-05-hust-cpu-study_2/image-20201019224823463.png" alt="image-20201019224823463" /></p>]]></content><author><name></name></author><category term="cpu" /></entry><entry><title type="html">自己动手画 CPU《计算机组织与结构实验》（一）</title><link href="/cpu/2020/09/28/hust-cpu-study.html" rel="alternate" type="text/html" title="自己动手画 CPU《计算机组织与结构实验》（一）" /><published>2020-09-28T05:56:10+00:00</published><updated>2020-09-28T05:56:10+00:00</updated><id>/cpu/2020/09/28/hust-cpu-study</id><content type="html" xml:base="/cpu/2020/09/28/hust-cpu-study.html"><![CDATA[<ul id="markdown-toc">
  <li><a href="#一计算机数据表示" id="markdown-toc-一计算机数据表示">一、计算机数据表示</a>    <ul>
      <li><a href="#1汉字国标码转区位码实验" id="markdown-toc-1汉字国标码转区位码实验">1、汉字国标码转区位码实验</a></li>
      <li><a href="#2汉字机内码获取实验" id="markdown-toc-2汉字机内码获取实验">2、汉字机内码获取实验</a></li>
      <li><a href="#3偶校验编码设计" id="markdown-toc-3偶校验编码设计">3、偶校验编码设计</a></li>
      <li><a href="#4偶校验检错电路设计" id="markdown-toc-4偶校验检错电路设计">4、偶校验检错电路设计</a></li>
      <li><a href="#516位海明编码电路设计" id="markdown-toc-516位海明编码电路设计">5、16位海明编码电路设计</a></li>
      <li><a href="#616位海明解码电路设计" id="markdown-toc-616位海明解码电路设计">6、16位海明解码电路设计</a></li>
      <li><a href="#716位crc并行编解码电路设计" id="markdown-toc-716位crc并行编解码电路设计">7、16位CRC并行编解码电路设计</a>        <ul>
          <li><a href="#1crc串行编码电路" id="markdown-toc-1crc串行编码电路">1.CRC串行编码电路</a></li>
          <li><a href="#2crc并行编码电路" id="markdown-toc-2crc并行编码电路">2.CRC并行编码电路</a></li>
          <li><a href="#3crc并行解码电路" id="markdown-toc-3crc并行解码电路">3.CRC并行解码电路</a></li>
        </ul>
      </li>
      <li><a href="#8流水传输实验海明码与crc思路一致" id="markdown-toc-8流水传输实验海明码与crc思路一致">8、流水传输实验（海明码与CRC思路一致）</a></li>
    </ul>
  </li>
</ul>

<p><a href="https://www.icourse163.org/course/HUST-1205809816">配套慕课</a></p>

<h2 id="一计算机数据表示">一、计算机数据表示</h2>

<h3 id="1汉字国标码转区位码实验">1、汉字国标码转区位码实验</h3>

<p>【实验要求】</p>

<p>理解汉字机内码、区位码，最终能利用相关工具批量获取一段文字的 GB2312 机内码，并利用简单电路实现 GB2312 编码与区位码的转换；</p>

<p>输入引脚为16位的 GB2312 双字节国标码；输出为区号和位号（<strong>区号位号均从1开始计数</strong>），请在电路中复制对应隧道标签信号使用，注意不要增改引脚，不要修改子电路封装，以免影响子电路在其它电路模块中的正常调用。</p>

<p><img src="/assets/blog_image/2020-09-28-hust-cpu-study/image-20200928154753459.png" alt="image-20200928154753459" /></p>

<p>原理：</p>

<p><strong>区位码 = GB2312 汉字机内码 - 0xA0A0</strong></p>

<table>
  <thead>
    <tr>
      <th>信号</th>
      <th>输入/输出</th>
      <th>位宽</th>
      <th>说明</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td>GB2312</td>
      <td>输入</td>
      <td>16 位</td>
      <td>汉字机内码</td>
    </tr>
    <tr>
      <td>区号</td>
      <td>输出</td>
      <td>7 位</td>
      <td>汉字区位码中的区号—行号 ROW</td>
    </tr>
    <tr>
      <td>位号</td>
      <td>输出</td>
      <td>7 位</td>
      <td>汉字区位码中的位号—列号 COL</td>
    </tr>
  </tbody>
</table>

<p>用到求补器，或者手算[0xA0A0]补。</p>

<p>注意：5f60 即为 A0A0 的补码，至于 dfe0 也能通过，是由于第 8 位 和第 16 位 不用考虑</p>

<h3 id="2汉字机内码获取实验">2、汉字机内码获取实验</h3>

<p>【实验要求】</p>

<p>​完成国标码到区位码的转换电路后，可以在汉字显示电路中进行测试，尝试在下图所示电路中的 ROM 存储器中存入下面给出的指定句子，注意这里不允许使用逐字查码表的方式获得编码，应掌握批量转换的方法和原理。</p>

<p>​指定句子如下：请思考数字，英文字符怎么输入和显示的。
​ １２３４５ＡＢＣＤＥＦＧａｂｃｄｅｆｇ轻轻的我走了，正如我轻轻的来；我轻轻的招手，作别西天的云彩。那河畔的金柳，是夕阳中的新娘；波光里的艳影，在我的心头荡漾。</p>

<p>【思路】</p>

<p>可通过编写程序方法从计算机中得到汉字的机内码，
 C语言规定符%x显示<strong>无符号</strong>以十六进制表示的整数。</p>

<div class="language-c highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="cp">#include</span><span class="cpf">&lt;stdio.h&gt;</span><span class="cp">
</span><span class="kt">int</span> <span class="nf">main</span><span class="p">(</span><span class="kt">void</span><span class="p">)</span>
<span class="p">{</span>
  <span class="kt">unsigned</span> <span class="kt">char</span> <span class="n">temp</span><span class="p">[</span><span class="mi">1000</span><span class="p">];</span>
  <span class="n">printf</span><span class="p">(</span><span class="s">"请输入汉字：</span><span class="se">\n</span><span class="s">"</span><span class="p">);</span>
  <span class="n">scanf</span><span class="p">(</span><span class="s">"%s"</span><span class="p">,</span><span class="n">temp</span><span class="p">);</span>
  <span class="n">printf</span><span class="p">(</span><span class="s">"</span><span class="se">\n</span><span class="s">其区位码为：</span><span class="se">\n</span><span class="s">"</span><span class="p">);</span>
  <span class="kt">int</span> <span class="n">i</span><span class="p">;</span>
  <span class="k">for</span><span class="p">(</span><span class="n">i</span><span class="o">=</span><span class="mi">0</span><span class="p">;</span> <span class="n">temp</span><span class="p">[</span><span class="n">i</span><span class="p">]</span><span class="o">!=</span><span class="sc">'\0'</span><span class="p">;</span> <span class="n">i</span><span class="o">++</span><span class="p">)</span> 
  <span class="p">{</span>
    <span class="n">printf</span><span class="p">(</span><span class="s">"%.2x"</span><span class="p">,</span><span class="n">temp</span><span class="p">[</span><span class="n">i</span><span class="p">]);</span>
    <span class="k">if</span><span class="p">((</span><span class="n">i</span><span class="o">+</span><span class="mi">1</span><span class="p">)</span><span class="o">%</span><span class="mi">16</span><span class="o">==</span><span class="mi">0</span><span class="p">)</span> <span class="n">printf</span><span class="p">(</span><span class="s">"</span><span class="se">\n</span><span class="s">"</span><span class="p">);</span>
    <span class="k">else</span> <span class="k">if</span><span class="p">((</span><span class="n">i</span><span class="o">+</span><span class="mi">1</span><span class="p">)</span><span class="o">%</span><span class="mi">8</span><span class="o">==</span><span class="mi">0</span><span class="p">)</span> <span class="n">printf</span><span class="p">(</span><span class="s">"  "</span><span class="p">);</span>
    <span class="k">else</span> <span class="k">if</span><span class="p">((</span><span class="n">i</span><span class="o">+</span><span class="mi">1</span><span class="p">)</span><span class="o">%</span><span class="mi">2</span><span class="o">==</span><span class="mi">0</span><span class="p">)</span> <span class="n">printf</span><span class="p">(</span><span class="s">" "</span><span class="p">);</span>
    <span class="k">else</span> <span class="k">continue</span><span class="p">;</span>
  <span class="p">}</span>
  <span class="k">return</span> <span class="mi">0</span><span class="p">;</span>
<span class="p">}</span>
</code></pre></div></div>

<p><img src="/assets/blog_image/2020-09-28-hust-cpu-study/image-20200928155921478.png" alt="image-20200928155921478" /></p>

<p>将区位码复制到保存ROM数据的txt文本</p>

<p>标注开头为 v2.0 raw</p>

<p><img src="/assets/blog_image/2020-09-28-hust-cpu-study/image-20200928160011121.png" alt="image-20200928160011121" /></p>

<p>导入 txt 文件数据到 ROM</p>

<p><img src="/assets/blog_image/2020-09-28-hust-cpu-study/image-20200928160102594.png" alt="image-20200928160102594" /></p>

<p>最终完成电路</p>

<p><img src="/assets/blog_image/2020-09-28-hust-cpu-study/image-20200928155358761.png" alt="image-20200928155358761" /></p>

<h3 id="3偶校验编码设计">3、偶校验编码设计</h3>

<p>【实验要求】</p>

<p>掌握奇偶校验基本原理和特性，能在 Logisim 中实现偶校验编码电路，检错电路,理解校验码传输的原理。</p>

<p>【思路】</p>

<p>偶校验，即加上校验位，一共有偶数个1；而校验位由原始数据的 1 的个数异或决定——当实际数据中“1”的个数为偶数的时候，这个校验位就是“0”，否则这个校验位就是“1”。</p>

<p>0100101 偶校验码就是 01001011</p>

<p>可用异或门求校验位。</p>

<p><img src="/assets/blog_image/2020-09-28-hust-cpu-study/image-20200928160753056.png" alt="image-20200928160753056" /></p>

<h3 id="4偶校验检错电路设计">4、偶校验检错电路设计</h3>

<p>【实验目的】</p>

<p>检错码为将原始 数据位+校验位 异或后构成 17 位的校验码进行异或，得到检错位。1 表示有错，0 表示无错。</p>

<p>原理是：校验码是 1 的个数为 偶数就为 0，因此，若</p>

<table>
  <thead>
    <tr>
      <th>信号</th>
      <th>输入/输出</th>
      <th>位宽</th>
      <th>说明</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td>校验码</td>
      <td>输入</td>
      <td>17 位</td>
      <td>最高位为偶校验位的偶校验数据</td>
    </tr>
    <tr>
      <td>检错位</td>
      <td>输出</td>
      <td>1 位</td>
      <td>1 表示有错，0 表示无错</td>
    </tr>
    <tr>
      <td>数据位</td>
      <td>输出</td>
      <td>16 位</td>
      <td>无冗余信息的原始数据</td>
    </tr>
  </tbody>
</table>

<p>没有干扰时，显示字体一致。</p>

<p><img src="/assets/blog_image/2020-09-28-hust-cpu-study/image-20200928162400494.png" alt="image-20200928162400494" /></p>

<p>由于发生两位错，因此无法检验出错误，显示误报</p>

<p><img src="/assets/blog_image/2020-09-28-hust-cpu-study/image-20200928162521383.png" alt="image-20200928162521383" /></p>

<p>发生三位错（奇数位），检测出错误。</p>

<p><img src="/assets/blog_image/2020-09-28-hust-cpu-study/image-20200928162712934.png" alt="image-20200928162712934" /></p>

<p>当干扰码是让第 8 位 和第 16 位变化时，不会变化（取决于A0A0的补码取得是值是否考虑了第 8 位 和 第 16 位。</p>

<p>现在情况为：</p>

<p>1.dfe0 即 8 位 和 16 位 始终为 1，随机干扰为 8080 时不会变化</p>

<p><img src="/assets/blog_image/2020-09-28-hust-cpu-study/image-20200928170332374.png" alt="image-20200928170332374" /></p>

<p>2.5f60 即 8 位 和 16 位 始终为 0，随机干扰为 8080 时会变化</p>

<p><img src="/assets/blog_image/2020-09-28-hust-cpu-study/image-20200928170452176.png" alt="image-20200928170452176" /></p>

<p>另外两种情况就不贴出来了，通过一小时思考（555），终于明白一个问题：</p>

<p>即要想明白补码加法和异或运算发生时刻。以及进位的发生。</p>

<p><strong>先说明一开始困扰我半小时的错误思路：</strong></p>

<pre><code class="language-assembly">一开始认为：
发现规律为：当为0x80时，df60 5f60 会变化，dfe0 5fe0 不会变化。即 —— 第 8 位的变化改变字符。
这是由于补码去参与加法运算，若补码为 1 ，那么会发生进位（dfe0 5fe0），区号 +1；若补码为 0，不发生进位（df60 5f60）。
而随机干扰是异或运算（改变数据），当为0x80的干扰码时，区位码为 0 会变为 1 后，再发生进位。

但是在验证这个规律时：突然发现没有考虑除了 第 8 位 以外的 其他位进位情况：（以下是没考虑时错误思路）
若此时为 dfe0 5fe0，由于区位码第 8 位为 1，0x80异或之前会发生进位，0x80异或之后变为 0 ，不会发生进位。
若此时为 df60 5f60，由于区位码第 8 位为 1，0x80异或之前不会发生进位，0x80异或之后变为 1 ，不会发生进位。

</code></pre>

<p><strong>现在便明白了：第 8 位是否发生进位才是最终问题所在。（进位取决于A0A0补码的取值）</strong></p>

<p>比如此时 a393: 100 0110 1001 0110，与 第 5-8位：0110必然不会发生进位</p>

<p>而上图 bfc6:1011 1111 1100 0110  与第 5-8位 0110 发生进位，因此会变化。</p>

<p><img src="/assets/blog_image/2020-09-28-hust-cpu-study/image-20200928180931268.png" alt="image-20200928180931268" /></p>

<h3 id="516位海明编码电路设计">5、16位海明编码电路设计</h3>

<p>【实验目的】</p>

<p>掌握海明码设计原理与检错纠错性能，能独立设计实现汉字 GB2312 编码的海明校验编码体系，并最终在实验环境中利用硬件电路实现对应的编解码电路。</p>

<p>原理是：</p>

<p>​	k+n&lt;=2^r-1,此时k=16，r=5（有5位的校验位），因此总的数据位数有16+5+1（总的奇偶校验位）=22位。设校验位为Pi（i=1，2，3，4，5）,分别位于22位数据的<strong>第2的i-1次方</strong>的位置上，故分别位于第1，2，4，8，16位上。</p>

<p><img src="/assets/blog_image/2020-09-28-hust-cpu-study/image-20201003153924941.png" alt="image-20201003153924941" /></p>

<p>​	为区分一位错和两位错，需要额外引入总偶校验位P——在海明码检错码报错时，如果总检错码为 0 ，则表示 2 位错；如果总检错码为  1，则表示出现 1 位错。（这是在假定没有出现 3 位以上错的情况）</p>

<p>思路很简单，就是对于</p>

<p>类似<img src="/assets/blog_image/2020-09-28-hust-cpu-study/image-20201003162846379.png" alt="image-20201003162846379" /></p>

<p>进行异或处理</p>

<p>总检测位则是对全部进行检测</p>

<p><img src="/assets/blog_image/2020-09-28-hust-cpu-study/image-20201003162821169.png" alt="image-20201003162821169" /></p>

<h3 id="616位海明解码电路设计">6、16位海明解码电路设计</h3>

<p>引入 G6 进行错误位数判断。是由于当发生 2 位错时：假设 H3 （0011）、H5（0101） 同时发生错误，由于 H3 参与 G1G2，H5参与G1G3，G1发生两位错因此无法检错，G3、G5发生一位错，因此构成纠错码为 0110，与 发生一位错 H6 的检错码一致，因此产生矛盾。</p>

<p>至于 G6 为何选择全部数据的异或，是为区分是 1 位错，还是 2 位错，当 发生 1 位错时，那么G6则为 1，发生 2 位错时，G6 为 0。</p>

<p><img src="/assets/blog_image/2020-09-28-hust-cpu-study/image-20201003232234022.png" alt="image-20201003232234022" /></p>

<ul>
  <li>当G5G4G3G2G1=0,G6=0,表示数据无出错；</li>
  <li>G5G4G3G2G1 !=0,G6=1,表示发生一位数据出错；</li>
  <li>G5G4G3G2GG1=0,G6=1,表示该奇偶校验位出错，即发生一位出错；</li>
  <li>G5G4G3G2G1 !=0,G6=0,表示发生两位数据出错。</li>
</ul>

<p>首先介绍解码器</p>

<p>当为 全 0 时， 0 位输出 1.</p>

<p><img src="/assets/blog_image/2020-09-28-hust-cpu-study/image-20201003223817970.png" alt="image-20201003223817970" /></p>

<p>当选择位为 1000 即表示 8 时，那么第 8 位便会置为 1。</p>

<p><img src="/assets/blog_image/2020-09-28-hust-cpu-study/image-20201003223925770.png" alt="image-20201003223925770" /></p>

<p>因此现在  G5G4G3G2G1 就表示是第 x 位错误。</p>

<p>且 G5G4G3G2G1 的电路图就是 P1 异或上 得到 P1 的电路。</p>

<p>eg G5：</p>

<p><img src="/assets/blog_image/2020-09-28-hust-cpu-study/image-20201003231945406.png" alt="image-20201003231945406" /></p>

<ul>
  <li>当G5G4G3G2G1=0,G6=0,表示数据无出错；此时 0 位为 1，G6由于全部为 0 则为 0。</li>
  <li>G5G4G3G2G1 !=0,G6=1,表示发生一位数据出错；此时 0 位为 0，G6 由于有 1 位错误则为 1。</li>
  <li>G5G4G3G2GG1=0,G6=1,表示该奇偶校验位出错，即发生一位出错；此时 0 位为 1，G6 由于有 1 位错误则为 1。</li>
  <li>G5G4G3G2G1 !=0,G6=0,表示发生两位数据出错。此时 0 位 为 0，G6 由于两位错误则为 1。</li>
</ul>

<p>采取与门进行错误位数选择。</p>

<p>完成核心电路如图。</p>

<p><strong>纠正数据功能</strong>：将输入数据换成G5G4G3G2G1，将该解码器的第1位至23位用分离器连接起来，如下图所示（此时，如果G5G4G3G2G1等于某个不为0的数据时，该数据对应数位将会输出为1）。将该22位数据与原来的海明码进行按位异或，则可得到原来无出错的数据，即进行纠正。也因此错 1 位可以纠正，错 2 位不能纠正。因为错 1 位可以指示出那一位，而错 2 位会指示两位的和。
（提示：x异或0=x，x异或1=x的非）</p>

<p><strong>注意</strong>：由于要获得纠正后的数据，即16位数据，由于该数据是从0开始的，故其检验位分别位于0，1，3，7，15，21上，因此要去掉这些位置的数据，即可得到原来的16位数据。因此采用分离器输出的时候，位宽仍然是22位，但是位0，位1，位3，位7，位15，位21，是无的。</p>

<p><img src="/assets/blog_image/2020-09-28-hust-cpu-study/image-20201003231503413.png" alt="image-20201003231503413" /></p>

<h3 id="716位crc并行编解码电路设计">7、16位CRC并行编解码电路设计</h3>

<p>首先，了解实验的大体要求，该实验要求我们对16位数据进行CRC编码，生成22位数据；再将22位CRC编码进行解码成16位数据，且判断数据是否在传输过程中发生一位错，两位错的情况，若出错，则必须对数据进行纠正。因此该实验要进行两个的电路图的设计。</p>

<p><strong>任务</strong>：实现16位原始数据的CRC编码，假定没有三位错，能纠正一位错</p>

<ul>
  <li>步骤1：选择生成多项式
    <ul>
      <li>不是任意的表达式都可以做生成多项式，见教材中表格</li>
      <li>构成的编码体系能否区分一位错，两位错，如不能，如何解决？</li>
    </ul>
  </li>
  <li>步骤2：利用余数循环特点求解16个特殊常量的CRC余数
    <ul>
      <li>0000000000000001 00000的CRC余数R1</li>
      <li>0000000000000010 00000的CRC余数R2，R1左移一位除生成多项式得到R2</li>
      <li>0000000000000100 00000的CRC余数R3，R2左移一位除生成多项式得到R3</li>
      <li>以此类推直至R1~R16全部求解完毕</li>
    </ul>
  </li>
  <li>步骤3：根据R1~R16构建并行编解码电路
    <ul>
      <li>纯组合逻辑，根据待编码每一位的值决定选择是否选择对应的余数是否参与运算</li>
    </ul>
  </li>
</ul>

<p><strong>1.解题思路</strong></p>

<p>① 已知该实验输入的是16位数据，输出22位CRC编码数据，其中包括16位原始数据，6位校验位，其中一位为总的奇偶校验位（校验位的位数也可由k+r&lt;=2^r-1得到）。因此此时的 r=5（不包含奇偶校验位），选择的多项式G(x)位数则为 r+1=6位，此时我选择的多项式是 G(x)=100101（该多项式不固定，选择其它六位的多项式也可以）。</p>

<p>② CRC编码原理：原始16位数据Q(X),<strong>左移</strong> r=5 位成<strong>21位Q’(x)</strong>（即后面补r个0），再与多项式 100101 做模 2 运算，得到的 r 位的余数，将该余数替换掉 Q’(X) 后面的 r 位，即将它后面的 r 个 0 替换成该余数。如图所示 r5r4r3r2r1 便是得到的余数，而r6是总的奇偶校验位，<strong>对所有数据进行异或便可得到该偶校验位 r6。</strong></p>

<p><img src="/assets/blog_image/2020-09-28-hust-cpu-study/image-20201004195840800.png" alt="image-20201004195840800" /></p>

<p><strong>首先进行串行编码电路的介绍：</strong></p>

<h4 id="1crc串行编码电路">1.CRC串行编码电路</h4>

<p>D触发器作用为 锁存。即保存输入值。</p>

<p>serial_in 慢慢进入触发器，位数向左移动，与模 2 的除法步骤一致。最终当serial_in 全部输入完成时，D4D3D2D1 即为所求余数。</p>

<p><img src="/assets/blog_image/2020-09-28-hust-cpu-study/image-20201004170716133.png" alt="image-20201004170716133" /></p>

<p>时间复杂度较高，需要 n-1 个时钟周期才能完成。因此运算速度慢，高速设备普遍采用并行CRC编解码</p>

<h4 id="2crc并行编码电路">2.CRC并行编码电路</h4>

<p><img src="/assets/blog_image/2020-09-28-hust-cpu-study/image-20201004194501717.png" alt="image-20201004194501717" /></p>

<p>因此可先对该 <strong>16 位数据</strong>按位与<strong>该多项式 （此处为 100101）</strong>进行模 2 除运算，再根据其实际数据进行异或操作。</p>

<p><img src="/assets/blog_image/2020-09-28-hust-cpu-study/image-20201004194524455.png" alt="image-20201004194524455" /></p>

<p><strong>因此</strong>根据该思路，先将 16 位原始数据所对应位置上取 1 时，与G(x)进行模2除运算<strong>得到各自的5位余数</strong>，再用<strong>选择器</strong>根据每一位数据选择输入的是余数还是0，最后将16个输入数据进行异或，即可得到5位最终的余数。</p>

<p>③选择器的使用原理：</p>

<p><img src="/assets/blog_image/2020-09-28-hust-cpu-study/image-20201004200933116.png" alt="image-20201004200933116" /></p>

<p>因此各位取 1 时与多项式模2除运算后的余数如下所示：</p>

<p><img src="/assets/blog_image/2020-09-28-hust-cpu-study/image-20201004220650902.png" alt="image-20201004220650902" /></p>

<p><strong>编码电路总览</strong></p>

<p><img src="/assets/blog_image/2020-09-28-hust-cpu-study/image-20201004220603149.png" alt="image-20201004220603149" /></p>

<h4 id="3crc并行解码电路">3.CRC并行解码电路</h4>

<p>该电路会比较难理解，要进行检错以及数据纠正得到原始的16位数据。</p>

<p>1.检错原理</p>

<p><img src="/assets/blog_image/2020-09-28-hust-cpu-study/image-20201004205823945.png" alt="image-20201004205823945" /></p>

<p>1、接收方在接受到 CRC 编码后，将该编码与多项式进行模2除运算，得到余数r’，再根据 r6（ r6 为总的奇偶检验位,将所有数据进行异或可得）的值进行判断数据是否产生错误，及产生错误后是一位错还是两位错。其检查原理同海明码的检错原理相同。
<strong>有以下情况：</strong></p>
<ul>
  <li>r5r4r3r2r1 = 0,r6 = 0,表示数据无出错；此时 0 位为 1，r6由于全部为 0 则为 0。</li>
  <li>r5r4r3r2r1 ! = 0,r6 = 1,表示发生一位数据出错；此时 0 位为 0，r6 由于有 1 位错误则为 1。</li>
  <li>r5r4r3r2rr1 = 0,r6 = 1,表示该奇偶校验位出错，即发生一位出错；此时 0 位为 1，r6 由于有 1 位错误则为 1。</li>
  <li>r5r4r3r2r1 ! = 0,r6 = 0,表示发生两位数据出错。此时 0 位 为 0，r6 由于两位错误则为 1。</li>
</ul>

<p>由上图可知，CRC 编码最后的 r 位少于多项式位数，因此可将最后 r 位看作一个整体，让它与多项式进行模 2 除运算后，得到的余数显然是它本身，因此让它与其它16位数据与G(x)模2除后所得的余数进行异或，即可得最后接收方检验的余数。</p>

<p>下图箭头所指位置得到的便是最终 5 位余数。</p>

<p><img src="/assets/blog_image/2020-09-28-hust-cpu-study/image-20201004210942193.png" alt="image-20201004210942193" /></p>

<p>2.纠错，得原始16位数据</p>

<p>① 若CRC编码发生出错，而它的出错位可能为第 7，8，9…22位（不考虑第1到6位，因为我们要得的原始16位数据处于第7…22位上，因此只需要判断这些位是否出错，若出错对它们进行纠正，再输出即可）。</p>

<p>​因此将CRC编码按照每一位取反后再与G(x)进行模2除运算（如下图），若余数为0，则说明该位出错，因此将余数取反为1，再与该位数据进行异或从而纠正该位的数据；若余数不为0，则说明该数据位并未发生传输错误，因此对该余数取反为0，再与该位的数据进行异或得到的数据仍为该数据位。（<strong>x 异或 0 = x，x 异或 1 = x 反</strong>）</p>

<p>​若采用或门，那么：若余数为 1 则为 1，而余数为 0 则说明该位错误，需要取反，为 1 则不变</p>

<p>​因此需要采用或非门 + 异或门进行判断</p>

<p><img src="/assets/blog_image/2020-09-28-hust-cpu-study/image-20201004213813453.png" alt="image-20201004213813453" /></p>

<p>② CRC编码按位取反（即按位异或1）后再与G(x)进行模2除运算，根据公式可化成
 CRC编码%G(x) <strong>异或</strong> 该数据位取1%G(x)。</p>

<p>例如：假设第 7 位出错
 （CRC%100101）异或（100 0000%100101） = （CRC%100101）异或 0a。</p>

<p><strong>最终电路总览</strong></p>

<p><img src="/assets/blog_image/2020-09-28-hust-cpu-study/image-20201005150355384.png" alt="image-20201005150355384" /></p>

<h3 id="8流水传输实验海明码与crc思路一致">8、流水传输实验（海明码与CRC思路一致）</h3>

<p>1.五段流水线模拟</p>

<p>同步清零，气泡，高电平有效</p>

<p>使能端，低电平有效，stall，高电平有效</p>

<p><img src="/assets/blog_image/2020-09-28-hust-cpu-study/image-20201005162854350.png" alt="image-20201005162854350" /></p>

<p>流水线演示：分为多个阶段</p>

<p><img src="/assets/blog_image/2020-09-28-hust-cpu-study/image-20201005162958819.png" alt="image-20201005162958819" /></p>

<p>主要目的是：增加 两位错重传机制。类似指令流水线中的分支指令
作用：保证接收端接收顺序和ROM中一致</p>

<p><strong>实现：</strong></p>

<ol>
  <li>让发送端地址回滚。（类似指令流水线分支处理的分支跳转）</li>
  <li>清空除最后一个外流水接口中的所有数据。（类似指令流水线分支处理的清空误取指令）</li>
  <li>最后一个流水接口停止接受数据。（类似指令流水线数据处理的流水线暂停）</li>
</ol>

<p><strong>解题思路：</strong></p>

<ol>
  <li>
    <p>发送端地址回滚，类似指令流水线分支处理的分支跳转</p>

    <p><img src="/assets/blog_image/2020-09-28-hust-cpu-study/image-20201005170649250.png" alt="image-20201005170649250" /></p>

    <p>​	在这里选用<strong>选择器</strong>，当无发生两位错误时，此时箭头所指的输入端为 0 ，此时选择器选择第 0 位的数据输入即将01输入，常量和加法器，寄存器够成的电路实现的是 x=x+01 的功能，即类似于计数器。因此无发生两位错时，不需要进行地址回滚。
​	当发生两位数据的出错时，此时输入的是 fd ，即-3（8位二进制）的补码表示，因为此时是加法器，因此减3，要用补码进行表示成 fd ，从而实现地址回滚。</p>

    <p><strong>为什么是减3，这里解释一下：</strong>
	假设华字发生两位错，且其他数据的传送都如下图所示</p>

    <p><img src="/assets/blog_image/2020-09-28-hust-cpu-study/image-20201005171046679.png" alt="image-20201005171046679" /></p>

    <p>​	此时，要将华字回滚到取数阶段，然而此时的取数阶段的对应序号为 4 ，而华字的对应序号为1，因此 4-3=1，故此时的加法器的输入端应该为 -3（八位二进制），则其对应补码为fd。</p>
  </li>
  <li>
    <p>清空前段数据(气泡逻辑)            类似指令流水线分支处理的清空误取指令</p>

    <p>由于流水线存在：同步清零，气泡，高电平有效</p>

    <p>因此对全部步骤采用清零即可</p>

    <p><img src="/assets/blog_image/2020-09-28-hust-cpu-study/image-20201005171416289.png" alt="image-20201005171416289" /></p>

    <p>进行同步清0，必须在两种状态都满足的条件下进行，该两种状态是：</p>

    <ul>
      <li>发生两位错</li>
      <li>
        <p>传送数据有效。</p>

        <p>发生两位错再进行同步清0是不言而喻的；数据有效，表明当前传送的数据是有效的。如果数据无效的话，数据都无效了，有无发生两位错和是否重传都是没有必要的。</p>
      </li>
    </ul>
  </li>
  <li>
    <p>暂停显示阶段的动作( Stall 信号控制)                 类似指令流水线数据相关处理的流水线暂停</p>

    <p>此时数据发生两位错误时，该数据不应该传入显示阶段中，显示阶段应该继续显示上个数据，即暂停显示阶段的动作。</p>

    <p><img src="/assets/blog_image/2020-09-28-hust-cpu-study/image-20201005171603991.png" alt="image-20201005171603991" /></p>

    <p>至于标签 en5 所连接的便是该 16 位流水接口的使能端（高电平有效），当使能端为 1 时，忽略时钟的输入，即错误数据不会传入该阶段，仍然继续显示上个数据。
 有两种情况应该暂停显示阶段的动作：
 ①发生两位的错误时
 ②数据无效时
 这两种情况，若其中有一种情况发生，都应该暂停显示阶段的动作。</p>
  </li>
</ol>

<p><strong>最终电路展示</strong></p>

<p><img src="/assets/blog_image/2020-09-28-hust-cpu-study/image-20201005171743029.png" alt="image-20201005171743029" /></p>]]></content><author><name></name></author><category term="cpu" /></entry><entry><title type="html">Implementing a Mini OS(Notes)</title><link href="/linux/2020/07/24/Os-MakeByBook.html" rel="alternate" type="text/html" title="Implementing a Mini OS(Notes)" /><published>2020-07-24T14:15:02+00:00</published><updated>2020-07-24T14:15:02+00:00</updated><id>/linux/2020/07/24/Os-MakeByBook</id><content type="html" xml:base="/linux/2020/07/24/Os-MakeByBook.html"><![CDATA[<ul id="markdown-toc">
  <li><a href="#内核体系结构图" id="markdown-toc-内核体系结构图">内核体系结构图</a></li>
  <li><a href="#bochs-的硬盘分布图" id="markdown-toc-bochs-的硬盘分布图">bochs 的：硬盘分布图</a>    <ul>
      <li><a href="#空间布局大致介绍" id="markdown-toc-空间布局大致介绍">空间布局大致介绍</a></li>
    </ul>
  </li>
  <li><a href="#1实模式" id="markdown-toc-1实模式">1、实模式</a>    <ul>
      <li><a href="#1bios--mbr" id="markdown-toc-1bios--mbr">1、BIOS &amp; MBR</a></li>
      <li><a href="#2boot-loader" id="markdown-toc-2boot-loader">2、boot loader</a>        <ul>
          <li><a href="#1调用bios中断获取内存大小" id="markdown-toc-1调用bios中断获取内存大小">1）调用BIOS中断获取内存大小</a></li>
          <li><a href="#2构建-gdt开启保护模式" id="markdown-toc-2构建-gdt开启保护模式">2）构建 GDT，开启保护模式</a></li>
          <li><a href="#3加载-kernel" id="markdown-toc-3加载-kernel">3）加载 kernel</a></li>
          <li><a href="#4构建页目录表和页表开启分页机制" id="markdown-toc-4构建页目录表和页表开启分页机制">4）构建页目录表和页表，开启分页机制</a></li>
          <li><a href="#5解析kernel的elf" id="markdown-toc-5解析kernel的elf">5）解析kernel的ELF</a></li>
          <li><a href="#目前所用空间" id="markdown-toc-目前所用空间">目前所用空间</a></li>
          <li><a href="#6跳转" id="markdown-toc-6跳转">6）跳转</a></li>
        </ul>
      </li>
    </ul>
  </li>
  <li><a href="#附linux-初始化过程" id="markdown-toc-附linux-初始化过程">附：Linux 初始化过程</a></li>
  <li><a href="#2husharp_os-----内核线程用户进程" id="markdown-toc-2husharp_os-----内核线程用户进程">2、HuSharp_OS     内核线程/用户进程</a>    <ul>
      <li><a href="#init-进程" id="markdown-toc-init-进程">init 进程</a></li>
      <li><a href="#main-线程" id="markdown-toc-main-线程">main 线程</a></li>
      <li><a href="#idle-进程" id="markdown-toc-idle-进程">idle 进程</a></li>
    </ul>
  </li>
  <li><a href="#3中断和系统调用" id="markdown-toc-3中断和系统调用">3、中断和系统调用</a></li>
  <li><a href="#4内存管理" id="markdown-toc-4内存管理">4、内存管理</a></li>
  <li><a href="#5任务调度" id="markdown-toc-5任务调度">5、任务调度</a></li>
  <li><a href="#6文件系统" id="markdown-toc-6文件系统">6、文件系统</a></li>
  <li><a href="#7shell" id="markdown-toc-7shell">7、Shell</a></li>
  <li><a href="#8锁" id="markdown-toc-8锁">8、锁</a></li>
  <li><a href="#9环形队列" id="markdown-toc-9环形队列">9、环形队列</a>    <ul>
      <li><a href="#名词解释" id="markdown-toc-名词解释">名词解释</a></li>
    </ul>
  </li>
  <li><a href="#define-k_heap_start-0xc0100000" id="markdown-toc-define-k_heap_start-0xc0100000">define K_HEAP_START 0xc0100000</a>    <ul>
      <li><a href="#实现的系统调用" id="markdown-toc-实现的系统调用">实现的系统调用</a></li>
      <li><a href="#实现函数" id="markdown-toc-实现函数">实现函数</a></li>
    </ul>
  </li>
</ul>

<p><a href="https://github.com/HuSharp/HuSharp_Os">源码</a>，本项目基于<a href="https://book.douban.com/subject/26745156/">《操作系统真象还原》</a>一书，实现了一个 mini 操作系统，包含：</p>

<p>1）内核线程、用户进程、fork和execv、任务调度；</p>

<p>2）中断(时钟，键盘，硬盘，系统调用等)、内存管理、文件系统、shell、管道；</p>

<p>3）基于二元信号量的锁、环形队列。</p>

<h2 id="内核体系结构图">内核体系结构图</h2>

<p><img src="/assets/blog_image/2020-07-24-Os-MakeByBook/image-20201125105953674.png" alt="image-20201125105953674" /></p>

<h2 id="bochs-的硬盘分布图">bochs 的：硬盘分布图</h2>

<p><img src="/assets/blog_image/2020-07-24-Os-MakeByBook/image-20201118103520098.png" alt="image-20201118103520098" /></p>

<p>魔数
栈边界 20000611
文件系统 20000712</p>

<h3 id="空间布局大致介绍">空间布局大致介绍</h3>

<pre><code class="language-assembly">   ...
可用空间    &lt;--- 0x9fc00
栈          &lt;--- 0x9f000
   ...
内核文件 kernel.bin     &lt;--- 0x70000
   ...
MBR               &lt;--- 0x7c00
   ...
内核映像 kernel      &lt;--- 0x1500
   ...
loader.bin(GDT所在处)   &lt;--- 0x900

可用空间   &lt;--- 0x500
BIOS数据区 &lt;---0x400-0x500
中断向量表 &lt;---0~0x3ff
</code></pre>

<hr />

<p><a href="http://www.ruanyifeng.com/blog/2013/02/booting.html">计算机是如何启动的？</a></p>

<h2 id="1实模式">1、实模式</h2>

<p><strong>BIOS-&gt;MBR-&gt;loader-&gt;加载内核</strong></p>

<p>BIOS -&gt;1.1 硬件自检-&gt;1.2 启动顺序(有一个外部储存设备的排序，排在前面的设备就是优先转交控制权的设备)-&gt;主引导记录</p>

<p><img src="/assets/blog_image/2020-07-24-Os-MakeByBook/image-20201206101520087.png" alt="image-20201206101520087" /></p>

<h3 id="1bios--mbr">1、BIOS &amp; MBR</h3>

<blockquote>
  <p>ROM 中写入”基本输入输出系统”（Basic Input/Output System），简称为<a href="https://en.wikipedia.org/wiki/BIOS">BIOS</a>。</p>
</blockquote>

<p>首先在开机的一瞬间，CS：IP 强制初始化为 0xF000:0xFFF0即为BIOS入口地址
BIOS: 0xF0000-0xFFFFF 64KB都为系统 BIOS 范围，被写入ROM中</p>

<ol>
  <li>
    <p>FFFF0-FFFFF BIOS的入口地址，16B大小中只有这么一条语句：<code class="language-plaintext highlighter-rouge"> jmp f000:e05b </code>，剩下的作为保留；</p>
  </li>
  <li>
    <p>1）检测、初始化硬件，硬件自己提供了一些初始化的功能调用，BIOS直接调用；</p>

    <p>2）在内存 0x000 - 0x3FF 建立中断向量表 IVT，这样就可以通过”int 中断号”来实现相关的硬件调用。这些功能的实现也是基于对硬件的 IO 操作。不过在保护模式下，中断向量表已经不存在了，取而代之的是中断描述符表IDT(Interrupt Descriptor Table)。</p>

    <p>（因为现在还要用键盘和鼠标，这些都要通过中断进行的。——————此时需要也要给客户输出一些结果，因为需要你自己(os)来，所以你还要充当客户对接人。你做了什么工作，做到了什么程度，都要主动显示给客户，也就是在内存空间映射显存的空间，在显示器上显示一些字符。）</p>
  </li>
  <li>
    <p><strong>检测0盘0道1扇区的内容</strong>（MBR所在处）</p>
  </li>
</ol>

<blockquote>
  <p><a href="https://en.wikipedia.org/wiki/Master_boot_record">“主引导记录”</a>（Master boot record，缩写为MBR）</p>
</blockquote>

<p>MBR：位于0盘0道1扇区（由于是 CHS扇区表示方法，即为最开始扇区），末尾为 0x55aa，被识别末尾魔数后，被加载到 0x7c00</p>

<p>对于 Linux 而言   MBR 相当于由 grub2 第一个要安装的 boot.img</p>

<ul>
  <li>大小为 512 字节</li>
  <li>27c00：历史原因——尽可能留足够的空间给操作系统在 32K 内加载自己
` 0x7FFF - 512 - 512 + 1 ` // 开机扇区512字节，再留出512字节</li>
  <li>引导记录由三个部分组成：
    <ul>
      <li>第1-446字节：调用操作系统的机器码。</li>
      <li>第447-510字节：分区表（Partition table）。</li>
      <li>第511-512字节：主引导记录签名（0x55和0xAA）。</li>
    </ul>
  </li>
</ul>

<p><img src="/assets/blog_image/2020-07-24-Os-MakeByBook/image-20201118105235835-1630980761455.png" alt="image-20201118105235835" /></p>

<h3 id="2boot-loader">2、boot loader</h3>

<blockquote>
  <p>小知识</p>

  <p><strong>boot的含义</strong></p>

  <p>先问一个问题，”启动”用英语怎么说？</p>

  <p>回答是boot。可是，boot原来的意思是靴子，”启动”与靴子有什么关系呢？ 原来，这里的boot是bootstrap（鞋带）的缩写，它来自一句谚语：</p>

  <blockquote>
    <p>　　”pull oneself up by one’s bootstraps”</p>
  </blockquote>

  <p>字面意思是”拽着鞋带把自己拉起来”，这当然是不可能的事情。最早的时候，工程师们用它来比喻，计算机启动是一个很矛盾的过程：必须先运行程序，然后计算机才能启动，但是计算机不启动就无法运行程序！</p>

  <p>早期真的是这样，必须想尽各种办法，把一小段程序装进内存，然后计算机才能正常运行。所以，工程师们把这个过程叫做”拉鞋带”，久而久之就简称为boot了。</p>
</blockquote>

<p><strong>载入 LOADER 进入实模式环境</strong></p>

<p>(Linux环境中，目前最流行的启动管理器是<a href="http://en.wikipedia.org/wiki/GNU_GRUB">Grub</a>。相当于 Linux 中加载 grub2 的另一个镜像 core.img。)</p>

<p><img src="/assets/blog_image/2020-07-24-Os-MakeByBook/image-20201118110012840.png" alt="image-20201118110012840" /></p>

<p>在loader.S 加载内核时，主要完成以下任务：</p>

<ol>
  <li>
    <p>调用 BIOS 中断获取内存大小；</p>
  </li>
  <li>
    <p>构建 GDT，开启保护模式；</p>
  </li>
  <li>
    <p>加载 kernel : 将内核文件先放到内存缓冲区</p>
  </li>
  <li>
    <p>构建页目录表和页表，开启分页机制；</p>
  </li>
  <li>
    <p>初始化内核：解析kernel的ELF，将ELF文件中的段segment拷贝到各段自己被编译的虚拟地址处，再跳去执行</p>

    <p>loader.bin 的加载地址为 0x900，放在第 2 块扇区( <strong>boot.inc</strong>)</p>

    <p>loder.bin 占用 3 个扇区，即使用第 2~4</p>

    <p>至于为啥是 0x900，是由于实模式的内存空间布局下0x500 - 0x7BFF 为可用区域，而为啥不是 0x500 ，是完全个人喜好，隔远点</p>
  </li>
</ol>

<h4 id="1调用bios中断获取内存大小">1）调用BIOS中断获取内存大小</h4>

<p>调用 BIOS 中断 0x15 获取内存大小，并将其值存放在 loader.bin头部（地址0x900），内核将会从该位置读取内存大小（kernel/memory.c mem_init()）。</p>

<h4 id="2构建-gdt开启保护模式">2）构建 GDT，开启保护模式</h4>

<p>2.1 构建GDT（全局描述符表）。</p>

<pre><code class="language-assembly">FILE: boot/loader.S
;构建gdt及其内部的描述符
   GDT_BASE:   dd    0x00000000 
            dd    0x00000000

   CODE_DESC:  dd    0x0000FFFF 
            dd    DESC_CODE_HIGH4

   DATA_STACK_DESC:  dd    0x0000FFFF
            dd    DESC_DATA_HIGH4

   VIDEO_DESC: dd    0x80000007        ; limit=(0xbffff-0xb8000)/4k=0x7
            dd    DESC_VIDEO_HIGH4  ; 此时dpl为0
</code></pre>

<p>2.2 加载GDT。lgdt指令，将 GDT 的基地址、界限值载入至 GDTR 寄存器。</p>

<p>2.3 打开地址线 A20。</p>

<p>第 21 条地址线 A20 ：实模式下，处理器访问内存的方式是将段寄存器的内容左移4位，再加上偏移地址，以形成 20 位的物理地址。实模式下，32位处理器的段寄存器的内容仅低 20 位有效，高  20 位全部为0（即，只能使用 20 根地址线）。故，处理器只能访问1MB内存。（回绕）</p>

<p>2.4 禁止中断。</p>

<p>在设置好保护模式下的中断环境之前，必须关中断(指令cli)。保护模式下的中断机制和实模式不同，原有的中断向量表 IVT 不再适用。而且，保护模式下，BIOS 中断也不能再用，因为它们是实模式下的代码。</p>

<p>2.5 将 CR0 的 PE 位置 1，开启保护模式。</p>

<p><strong>控制实模式/保护模式切换的开关是CR0寄存器。</strong>CR0是处理器内部的控制寄存器(Control  Register)，是 32 位的寄存器，包含了一系列用于控制处理器操作模式和运行状态的标志位。 CR0 的第 1 位(位 0 )是保护模式允许位(Protection Enable, PE)，该位置 1 ，则处理器进入保护模式，按保护模式的规则开始运行。</p>

<pre><code class="language-assembly">   ;-----------------  打开A20  ----------------
   in al，0x92
   or al，0000_0010B
   out 0x92，al

   ;-----------------  加载GDT  ----------------
   lgdt [gdt_ptr]

   ;-----------------  cr0第0位置1  ----------------
   mov eax, cr0
   or eax, 0x00000001
   mov cr0, eax
</code></pre>

<h4 id="3加载-kernel">3）加载 kernel</h4>

<p>将内核文件先放到内存缓冲区</p>

<pre><code class="language-assembly">KERNEL_BIN_BASE_ADDR equ 0x70000 ; 自定义kernel被加载到物理内存位置
KERNEL_START_SECTOR  equ 0x09    ; 自定义kernel位于硬盘的扇区号
; -------------------------   加载kernel  ----------------------
   mov eax, KERNEL_START_SECTOR        ; kernel.bin所在的扇区号
   mov ebx, KERNEL_BIN_BASE_ADDR       ; 从磁盘读出后，写入到ebx指定的地址
   mov ecx, 200                        ; 读入的扇区数
   
   call rd_disk_m_32 ;功能:读取硬盘n个扇区
</code></pre>

<h4 id="4构建页目录表和页表开启分页机制">4）构建页目录表和页表，开启分页机制</h4>

<p><a href="http://husharp.today/2020/12/01/HuSharp-Memory-01/">详情见作者的此 Blog</a></p>

<blockquote>
  <p>地址转换，是由处理器和操作系统共同协作完成的，处理器在硬件上提供地址转换部件，操作系统提供转换过程中所需要的页表。</p>
</blockquote>

<p><img src="/assets/blog_image/2020-07-24-Os-MakeByBook/image-20201206171520147.png" alt="image-20201206171520147" /></p>

<p>开启分页机制之前，加载到 cr3 寄存器中的页目录表基地址是物理地址，页表中页表项的地址自然也是物理地址了。虽然内存分页机制的作用是将虚拟地址转换成物理地址，但其转换过程相当于是在关闭分页机制下进行的，过程中所涉及到的地址都被 CPU 当作物理地址直接送上地址总线，不会被分页机制再次转换(否则会递归转换下去)。</p>

<p><img src="/assets/blog_image/2020-07-24-Os-MakeByBook/image-20201206171732588.png" alt="image-20201206171732588" /></p>

<p>明显 4 K 大小的页表代表 (4K/4)*4K=4M 大小的物理内存</p>

<p><strong>4.1 物理内存 1MB 之上：</strong></p>

<p>第 1 个4KB， 为页目录表PDT</p>

<p>第 2 个4KB， 为创建的第一个页表（第0和第768(0xc00/4= 768)个页目录项都指向它）</p>

<blockquote>
  <p>这是由于，操作系统的内核位于物理地址的 1MB 以下，但是 OS 的虚拟地址位于 0xc0000000 以上的 1MB 该地址对应的页目录项取决于前 10 位，即 0xc00，为第 768 个目录项。</p>
</blockquote>

<p>第769~1022个页目录项一共指向254个页表（即内核空间）</p>

<p>最后一个页目录项(第1023个)指向页目录表PDT本身</p>

<blockquote>
  <p>为了确保各个用户进程都共享内核，那么需要各个进程第 768~1022 个页目录项均相同，因此在为用户进程创办页表时，应将内核页表中第 768~1022 个页目录项复制到用户进程页目录表相同位置。</p>
</blockquote>

<p>因此，共 256 个页，正好 1M 。即，物理内存 1MB 之上的 1MB 已用于页目录表和页表。</p>

<p><strong>4.2 控制寄存器 CR3 指向页目录表基地址</strong></p>

<p><strong>4.3 将 CR0 的 PG 位置1，开启分页机制</strong></p>

<h4 id="5解析kernel的elf">5）解析kernel的ELF</h4>

<p>将ELF文件中的段 segment 拷贝到各段自己被编译的虚拟地址处，将这些段单独提取到内存中，这就是所谓的内存中的程序映像。分析程序中的每个段 segment ，如果段类型不是PT_NULL(空程序类型)，就将该段拷贝到编译的地址中</p>

<p>这里将kernel的入口定义为 0xc0001500，对应的在编译内核kernel.bin时需要指定该地址。</p>

<p>0x1500（这是由于 loder.bin +2000=0x10d0 凑个整，到0x1500【2000是由于估摸 loder 不会大于 2000 字节】）</p>

<div class="language-shell highlighter-rouge"><div class="highlight"><pre class="highlight"><code>ld <span class="nt">-m</span> elf_i386 <span class="nt">-Ttext</span> 0xc0001500 <span class="nt">-e</span> main <span class="nt">-o</span> kernel.bin %.o
</code></pre></div></div>

<p><img src="/assets/blog_image/2020-07-24-Os-MakeByBook/image-20201206175250174.png" alt="image-20201206175250174" /></p>

<p>至于栈选用 0x9f000 是由于首先 0x9fc00 以下为可用区域，但是为了之后放 PCB 取整，因此放在此处。</p>

<p><img src="/assets/blog_image/2020-07-24-Os-MakeByBook/image-20201206175124408.png" alt="image-20201206175124408" /></p>

<h4 id="目前所用空间">目前所用空间</h4>

<div class="language-bash highlighter-rouge"><div class="highlight"><pre class="highlight"><code>   ...
可用空间       &lt;<span class="nt">---</span> 0x9fc00
栈            &lt;<span class="nt">---</span> 0x9f000
   ...
内核文件 kernel.bin     &lt;<span class="nt">---</span> 0x70000（随便选的
   ...
MBR                    &lt;<span class="nt">---</span> 0x7c00
   ...
内核映像 kernel         &lt;<span class="nt">---</span> 0x1500（这是由于 loder.bin +2000<span class="o">=</span>0x10d0 凑个整，到0x1500（2000是由于估摸 loder 不会大于 2000 字节））
   ...
loader.bin<span class="o">(</span>GDT所在处<span class="o">)</span>   &lt;<span class="nt">---</span> 0x900

可用空间                &lt;<span class="nt">---</span> 0x500
BIOS数据区              &lt;<span class="nt">---0x400-0x500</span>
中断向量表              &lt;<span class="nt">---0</span>~0x3ff
</code></pre></div></div>

<p><img src="/assets/blog_image/2020-07-24-Os-MakeByBook/image-20201206175331991.png" alt="image-20201206175331991" /></p>

<h4 id="6跳转">6）跳转</h4>

<div class="language-shell highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="p">;</span> FILE: boot/loader.asm
<span class="p">;</span> 截取部分代码
 
KERNEL_ENTRY_POINT equ 0xc0001500
 
mov esp, 0xc009f000     <span class="p">;</span> 自定义内核主线程PCB中的栈顶
jmp KERNEL_ENTRY_POINT
</code></pre></div></div>

<p>至此，进入 kernel 即 main。</p>

<h2 id="附linux-初始化过程">附：Linux 初始化过程</h2>

<p><a href="http://www.ruanyifeng.com/blog/2013/08/linux_boot_process.html">Linux 的启动流程</a></p>

<p>我们知道系统是从BIOS加电自检，载入MBR中的引导程序(LILO/GRUB)，再载入linux内核開始执行的，一直到指定shell開始执行告一段落，这时用户開始操作Linux。</p>

<p>首先介绍 Linux 的初始化</p>

<p><img src="/assets/blog_image/2020-07-24-Os-MakeByBook/image-20201125123403817-1631024252865.png" alt="image-20201125123403817" /></p>

<p>start_kernel  –&gt;rest_init –&gt; init –&gt; kthreadd –&gt; cpu_idle_loop</p>

<p>在操作系统里面，先要有个创始进程，有一行指令 set_task_stack_end_magic(&amp;init_task)。这里面有一个参数 init_task，它的定义是 struct task_struct init_task =  INIT_TASK(init_task)。它是系统创建的第一个进程，我们称为 <strong>0 号进程</strong>。这是唯一一个没有通过 fork 或者 kernel_thread 产生的进程，是进程列表的第一个。即 <strong>idle 进程</strong>。</p>

<p>该进程是内核的一部分，所有进程的根进程，它并不执行任何磁盘上的程序，因此也被称为系统进程。</p>

<p><strong>说明一下 rest_init（）</strong></p>

<ol>
  <li>
    <p>**init **</p>

    <p>在 rest_init 的第一大工作是，用 kernel_thread(kernel_init, NULL， CLONE_FS) 创建第二个进程，这个是<strong>1 号进程</strong>。1 号进程的目的是为了作为用户态的总管。系统中所有其它用户进程的祖先进程。<strong>init 进程决不会终止</strong>。它是一个普通的用户进程（与交换进程不同，它不是内核中的系统进程），但是它<strong>以超级用户特权运行</strong>。</p>

    <p>当前执行 kernel_thread 这个函数的时候，我们还在内核态，现在我们就来跨越这道屏障，到用户态去运行一个程序。1 号进程 调用  do_execve  ，访问内核中保存用户态运行上下文的寄存器们，将用户态的代码段 CS 设置为 USER_CS，将用户态的数据段 DS 设置为 USER_DS，以及指令指针寄存器 IP、栈指针寄存器 SP。再通过 iret 返回 pop 出更改的寄存器， 进入用户态。以进行各种系统的初始化。启动系统的服务，启动控制台，用户就可以登录进来了。</p>

    <p>1号进程从0号进程fork出来，然后又切换到用户态，完成控制权从核心态到用户态的转换， 因此<strong>用户交互才能开始</strong>。</p>

    <p>至于 init 为何是 systemd  <a href="http://www.ruanyifeng.com/blog/2016/03/systemd-tutorial-commands.html">Systemd 入门教程：命令篇</a>见此博客</p>

    <p>systemctl</p>

    <p><img src="/assets/blog_image/2020-07-24-Os-MakeByBook/image-20201125150031326-1631025271495.png" alt="image-20201125150031326" /></p>
  </li>
  <li>
    <p><strong>kthreadd</strong> 页守护进程</p>

    <p>rest_init 第二大事情就是第三个进程，就是 2 号进程。这里的函数 kthreadd，负责所有内核态的线程的调度和管理，是内核态所有线程运行的祖先。负责虚拟内存系统的分页操作。</p>

    <p>通过 以下命令进行查看，发现 PID 为 1 是 /sbin/init， 2 为 kthreadd</p>

    <pre><code class="language-assembly">ps -ef
</code></pre>

    <p>其中用户态的不带中括号，内核态的带中括号。</p>

    <p>进程号依次增大，但是你会看所有带中括号的内核态的进程，祖先都是 2 号进程。而用户态的进程，祖先都是 1 号进程。tty 那一列，是问号的，说明不是前台启动的，一般都是后台的服务。</p>

    <p><img src="/assets/blog_image/2020-07-24-Os-MakeByBook/image-20201125141119291-1631025199027.png" alt="image-20201125141119291" /></p>

    <blockquote>
      <p>ps -ef 这个命令的父进程是 bash。这样整个链条都比较清晰了。</p>

      <p><code class="language-plaintext highlighter-rouge">husharp  26859  8355  0 14:10 pts/1    00:00:00 ps -ef</code></p>

      <p><code class="language-plaintext highlighter-rouge">husharp   8355  6773  0 10:42 pts/1    00:00:00 bash</code></p>

      <p><code class="language-plaintext highlighter-rouge">husharp   6773  2294  0 10:17 ?        00:00:01 /usr/lib/gnome-terminal/gnome-te</code></p>

      <p><code class="language-plaintext highlighter-rouge">husharp   2294     1  0 09:45 ?        00:00:00 /lib/systemd/systemd --user</code></p>

      <p>从下向上进行索引，发现最后父节点是 init，说明是用户态</p>
    </blockquote>
  </li>
</ol>

<p>因此， idle 实则就是 while ，当没有线程调度时，便运行 idle，在 init 开始后才运行，因此 init 的 pid 为 1 ，而 idle 并非为 1.</p>

<p><img src="/assets/blog_image/2020-07-24-Os-MakeByBook/image-20201125131132709-1631025411555.png" alt="image-20201125131132709" /></p>

<p>某 ucore 群友做的图</p>

<p><img src="/assets/blog_image/2020-07-24-Os-MakeByBook/image-20201125134734671-1631025437942.png" alt="image-20201125134734671" /></p>

<p><strong>Linux 相关补充阅读</strong></p>

<p><a href="https://www.cnblogs.com/cynchanpin/p/7323299.html">Linux内核的idle进程分析</a></p>

<p><a href="https://blog.csdn.net/titer1/article/details/44464647">动静结合学内核：linux idle进程和init进程浅析</a></p>

<p><a href="https://www.cnblogs.com/harlanc/p/7774882.html">Linux中main是如何执行的</a></p>

<h2 id="2husharp_os-----内核线程用户进程">2、HuSharp_OS     内核线程/用户进程</h2>

<p>而对于 HuSharp_OS 而言，首先通过 init_all 进行各个初始化 (init.c)</p>

<div class="language-c highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="kt">void</span> <span class="nf">init_all</span><span class="p">()</span> <span class="p">{</span>
    <span class="n">put_str</span><span class="p">(</span><span class="s">"init_all start!</span><span class="se">\n</span><span class="s">"</span><span class="p">);</span>
    <span class="n">idt_init</span><span class="p">();</span><span class="c1">// 初始化中断</span>
    
    <span class="n">mem_init</span><span class="p">();</span><span class="c1">//初始化内存管理系统</span>
    <span class="n">thread_environment_init</span><span class="p">();</span><span class="c1">// 初始化线程相关环境</span>
    <span class="n">timer_init</span><span class="p">();</span>   <span class="c1">// 初始化 PIT</span>
    <span class="n">console_init</span><span class="p">();</span> <span class="c1">// 初始化 console </span>
    <span class="n">keyboard_init</span><span class="p">();</span>
    <span class="n">tss_init</span><span class="p">();</span>
    <span class="n">syscall_init</span><span class="p">();</span>   <span class="c1">// 初始化系统调用</span>
    <span class="n">intr_enable</span><span class="p">();</span>      <span class="c1">// 后面的 ide_init 需要打开中断</span>
    <span class="n">ide_init</span><span class="p">();</span>     <span class="c1">//初始化硬盘</span>
    <span class="n">filesys_init</span><span class="p">();</span> <span class="c1">// 初始化文件系统</span>
<span class="p">}</span>
</code></pre></div></div>

<p>在 thread_environment_init (thread.c)中进行相关进程的初始化</p>

<div class="language-c highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="kt">void</span> <span class="nf">thread_environment_init</span><span class="p">(</span><span class="kt">void</span><span class="p">)</span> <span class="p">{</span>
    <span class="n">put_str</span><span class="p">(</span><span class="s">"thread_init start!</span><span class="se">\n</span><span class="s">"</span><span class="p">);</span>
    <span class="n">list_init</span><span class="p">(</span><span class="o">&amp;</span><span class="n">thread_ready_list</span><span class="p">);</span>
    <span class="n">list_init</span><span class="p">(</span><span class="o">&amp;</span><span class="n">thread_all_list</span><span class="p">);</span>
    <span class="n">lock_init</span><span class="p">(</span><span class="o">&amp;</span><span class="n">pid_lock</span><span class="p">);</span>

    <span class="c1">// 创建第一个用户进程 init</span>
    <span class="c1">// 放在第一个初始化， pid 为 1</span>
    <span class="n">process_execute</span><span class="p">(</span><span class="n">init</span><span class="p">,</span> <span class="s">"init"</span><span class="p">);</span>

    <span class="c1">// 将 main 函数创建为 线程</span>
    <span class="n">make_main_thread</span><span class="p">();</span>
    <span class="c1">// 创建 idle 线程</span>
    <span class="n">idle_thread</span> <span class="o">=</span> <span class="n">thread_start</span><span class="p">(</span><span class="s">"idle"</span><span class="p">,</span> <span class="mi">10</span><span class="p">,</span> <span class="n">idle</span><span class="p">,</span> <span class="nb">NULL</span><span class="p">);</span>
    <span class="n">put_str</span><span class="p">(</span><span class="s">"thread_init done!</span><span class="se">\n</span><span class="s">"</span><span class="p">);</span>
<span class="p">}</span>
</code></pre></div></div>

<h3 id="init-进程">init 进程</h3>

<p>init 是用户级进程，是第一个启动的程序，其 pid 为1。init 是所有进程的父进程。为了抢夺 pid 1，因此我们在 创建主线程的函数 make_main_thread 之前，进行 init 的创建。</p>

<p>init fork 出 shell 程序，以方便用户交互</p>

<div class="language-c highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="c1">// init 进程</span>
<span class="kt">void</span> <span class="nf">init</span><span class="p">(</span><span class="kt">void</span><span class="p">)</span>
<span class="p">{</span>
    <span class="kt">unsigned</span> <span class="kt">int</span> <span class="n">ret_pid</span> <span class="o">=</span> <span class="n">fork</span><span class="p">();</span>
    <span class="k">if</span><span class="p">(</span><span class="n">ret_pid</span><span class="p">)</span>     <span class="c1">// 父进程</span>
    <span class="p">{</span>
        <span class="kt">int</span> <span class="n">status</span><span class="p">,</span> <span class="n">child_pid</span><span class="p">;</span>
        <span class="k">while</span><span class="p">(</span><span class="mi">1</span><span class="p">)</span> <span class="c1">// init在此处不停地回收过继给它的子进程</span>
        <span class="p">{</span>
            <span class="n">child_pid</span> <span class="o">=</span> <span class="n">wait</span><span class="p">(</span><span class="o">&amp;</span><span class="n">status</span><span class="p">);</span>
            <span class="n">printf</span><span class="p">(</span><span class="s">"i am init, my pid is %d, i recieve a child, it's pid is %d, status is %d</span><span class="se">\n</span><span class="s">"</span><span class="p">,</span> <span class="n">child_pid</span><span class="p">,</span> <span class="n">status</span><span class="p">);</span>
        <span class="p">}</span>
    <span class="p">}</span>
    <span class="k">else</span>        <span class="c1">// 子进程</span>
    <span class="p">{</span>
        <span class="n">my_shell</span><span class="p">();</span>
    <span class="p">}</span>
    <span class="n">panic</span><span class="p">(</span><span class="s">"ERROR: during init, should not be here"</span><span class="p">);</span>
<span class="p">}</span>
</code></pre></div></div>

<h3 id="main-线程">main 线程</h3>

<p><img src="/assets/blog_image/2020-07-24-Os-MakeByBook/image-20201206183533818.png" alt="image-20201206183533818" /></p>

<p>由于在开机到创建第一个线程前，程序都是有个执行流的，这个执行流从 BIOS 到 mbr 到 loader 到 kernel，他是主线程 main   。因为 main 线程早已运行，咱们在loader.S中进入内核时的mov esp，0xc009f000，就是为其预留了tcb，地址为 0xc009e000。</p>

<div class="language-c highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="kt">int</span> <span class="nf">main</span><span class="p">(</span><span class="kt">void</span><span class="p">)</span>
<span class="p">{</span>
    <span class="n">init_all</span><span class="p">();</span>     <span class="c1">// kernel/init.c 初始化所有模块</span>
 
    <span class="n">cls_screen</span><span class="p">();</span>
    <span class="n">console_put_str</span><span class="p">(</span><span class="s">"[husharp@HuSharp_OS /]$ "</span><span class="p">);</span>
 
    <span class="c1">// 主线程完成使命后退出</span>
    <span class="n">thread_exit</span><span class="p">(</span><span class="n">running_thread</span><span class="p">(),</span> <span class="nb">true</span><span class="p">);</span>
    <span class="k">return</span> <span class="mi">0</span><span class="p">;</span>
<span class="p">}</span>
</code></pre></div></div>

<p>内核的 main_thread 完成系统的初始化工作，然后 thread_exit。</p>

<h3 id="idle-进程">idle 进程</h3>

<p>为何会有 idle 进程（<strong>0 号进程</strong>）？</p>

<p>当就绪队列中没有任务时，调度器没有任务可调时，会报错 thread_ready_list is empty!</p>

<div class="language-c highlighter-rouge"><div class="highlight"><pre class="highlight"><code>   <span class="c1">// 实现就绪队列为空时，唤醒 idle</span>
   <span class="k">if</span> <span class="p">(</span><span class="n">list_empty</span><span class="p">(</span><span class="o">&amp;</span><span class="n">thread_ready_list</span><span class="p">))</span> <span class="p">{</span>
        <span class="n">thread_unblock</span><span class="p">(</span><span class="n">idle_thread</span><span class="p">);</span>
    <span class="p">}</span>
</code></pre></div></div>

<p>idle 线程用于系统空闲时，运行（idle ：翻译：懈怠的；懒惰的；闲置的；没有工作的。）</p>

<pre><code class="language-assembly">    内核线程/用户进程
    |---- FILE: thread/thread.c     thread_init()
    |       | 初始化线程环境
    |       | list_init()     初始化就绪/全部队列
    |       | pid_pool_init() 初始化pid池，指定起始pid为1 (基于bitmap和lock)
    |       |
    |       | process_execute(init, "init") 创建第一个用户进程init，其pid为1
    |       | make_main_thread() 将当前内核main函数创建为线程
    |       | idle_thread = thread_start("idle", 10, idle, NULL) 创建idle线程 
    |       |
    |       | 至此，参与调度的有: init进程、main线程、idle线程
    |       |
    |       |---- FILE: user/process.c      process_execute()
    |       |       | 创建用户进程
    |       |       | struct task_struct *thread = get_kernel_pages(1) 申请1页内核内存作为用户进程PCB
    |       |       | init_thread() 在PCB中初始化线程基本信息
    |       |       |     申请pid allocate_pid()
    |       |       |         {bitmap_scan(); bitmap_set(); return (index + pid_pool.pid_start);}
    |       |       |     进程名、状态READY、内核态时的栈顶(PCB顶部)、优先级、嘀嗒时间数
    |       |       |     初始化文件描述符数组pthread-&gt;fd_table[8]，标准输入/输出/错误012，其余为-1 
    |       |       |     根目录作为默认工作路径 pthread-&gt;current_work_dir_inode_id = 0
    |       |       |     父进程pid初始为-1
    |       |       |     页目录表pgdir初始为NULL，在紧接着的create_page_dir()创建页目表时赋值
    |       |       | create_user_vaddr_bitmap() 创建用户虚拟内存空间的bitmap
    |       |       |     指定用户进程虚拟地址起始值; 申请1页内核内存
    |       |       | 
    |       |       | thread_create(thread, start_process, filename)
    |       |       |     初始化PCB中的thread_stack。当处理器进入kernel_thread函数体时
    |       |       |         栈顶为返回地址、栈顶+4为参数function、栈顶+8为参数func_arg
    |       |       |         kthread_stack-&gt;eip = kernel_thread      函数kernel_thread
    |       |       |         kthread_stack-&gt;function = start_process 函数start_process
    |       |       |         kthread_stack-&gt;func_arg = filename      待创建的进程
    |       |       |      
    |       |       | thread-&gt;pgdir = create_page_dir()     创建页目录表
    |       |       |     在内核空间申请一页内存作为用户进程的页目录表  get_kernel_pages(1)
    |       |       |     从内核页目录表中拷贝内核空间的页目录项到用户进程的页目录中  memcpy()
    |       |       |     页目录表物理基地址写入页目录表最后一项
    |       |       |
    |       |       | block_desc_init(thread-&gt;u_block_desc) 初始化内存规格信息，为malloc/free做准备
    |       |       | list_append() 添加到就绪队列和全部队列
    |       |       
    |       |---- FILE: thread/thread.c     make_main_thread()
    |       |       | 将 kernel 中 main 函数完善为主线程
    |       |       | main 线程早已运行，在LOADER阶段已预留并指定了PCB "mov esp, 0xc009_f000"
    |       |       | 即，PCB基址为0xc009_e000
    |       |       |     main_thread = running_thread();
    |       |       |     init_thread(main_thread, "main", 31);
    |       |       |     list_append() 添加到全部队列
    |       |       
    |       |---- FILE: thread/thread.c     thread_start()
    |       |       | 创建内核线程
    |       |       | struct task_struct *thread = get_kernel_pages(1) 申请1页内核内存作为内核线程PCB
    |       |       | init_thread() 在PCB中初始化线程基本信息
    |       |       |     初始化PCB底部的线程信息struct task_struct
    |       |       |     申请pid allocate_pid()    
    |       |       | thread_create(thread, function, func_arg)
    |       |       |     初始化PCB中的thread_stack
    |       |       |     不同于创建进程时的参数function为start_process，这里直接为所要创建的线程
    |       |       |       即switch_to()任务切换后，将直接执行对应的线程函数
    |       |       |       kthread_stack-&gt;eip = kernel_thread      函数kernel_thread
    |       |       |       kthread_stack-&gt;function = function      线程对应的函数
    |       |       |       kthread_stack-&gt;func_arg = func_arg      线程参数
    |       |       |
    |       |       | list_append() 添加到就绪队列和全部队列
    |
    |---- FILE: thread/thread.c     idle()
    |       | 系统空闲时运行的线程(block/unblock)
    |       | while(1){thread_block(TASK_BLOCKED); asm volatile("sti; hlt" : : : "memory");}    
    |       | idle线程在创建时会被加入到就绪队列，因此会执行一次，然后阻塞;
    |       | 当就绪队列为空时，schedule会将idle解除阻塞，也就是唤醒
    |       |
    |       |---- thread_block()
    |       |       | 当前线程将自己阻塞
    |       |       | 修改线程状态为阻塞、触发调度，切换线程执行
    |       |       | schedule() 由当前阻塞线程主动触发的任务调度
    |       |       | 由于idle线程触发调度后没有被加入就绪队列，所以将得不到执行，除非被唤醒
    |       |
    |       |---- thread_unblock()
    |       |       | 将指定的线程解阻塞
    |       |       | 添加到就绪队列头部，修改状态为READY
    |       |       | list_push(&amp;thread_ready_list, &amp;pthread-&gt;general_tag)
    |       |       | pthread-&gt;status = TASK_READY
    |
    |---- FILE: kernel/main.c   main()
    |       | 内核主线程
    |       | init_all()
    |       | thread_exit(running_thread(), true);
    |       | 主线程完成使命后退出 return 0;
    |
    |---- FILE: kernel/main.c   init()
    |       | init进程
    |       | 第一个用户进程，pid为1
    |       | init是所有进程的父进程，它还要负责回收过继给它的子进程
    |       | if(fork())    // 父进程
    |       | { while(1){wait(&amp;status);} }
    |       | else          // 子进程
    |       | { my_shell(); }
</code></pre>

<h2 id="3中断和系统调用">3、中断和系统调用</h2>

<p>详情见 下列 Blog</p>

<p><a href="http://husharp.today/2020/11/22/Signal/">终端控制和信号</a></p>

<p><a href="http://husharp.today/2020/11/27/interrupt-HuSharpOS/">中断原理详解，以及中断与信号的关系</a></p>

<p>本项目支持的中断有：时钟、键盘、硬盘、int 0x80（系统调用）。</p>

<h2 id="4内存管理">4、内存管理</h2>

<p>详情见下列 Blog</p>

<p><a href="http://husharp.today/2020/12/01/HuSharp-Memory-01/">内存管理（一）前置知识 &amp; 虚拟地址布局</a></p>

<p><a href="http://husharp.today/2020/12/03/HuSharp-Memory-02/">内存管理（二）物理内存管理</a></p>

<p><a href="http://husharp.today/2020/12/05/HuSharp-Memory-03/">内存管理（三）虚拟内存与物理内存的映射关系 &amp; pagefault</a></p>

<p>这里先从指定位置处读取LOADER写入的物理内存大小。本项目中，物理内存的配置为32M(bochs配置文件bochsrc.cfg中”megs:  32”)，减去低端的1MB、减去LOADER开启分页机制时创建PDT和PT占用的1MB（紧邻低端1MB之上），还有30MB，内核和用户内存池各占15M。所以，内核物理内存池的起始地址为 0x20_0000（2MB）。</p>

<p>以页(4KB)为单位的内存管理，采用bitmap(位图)技术。本项目中，自定义内核物理内存的bitmap存放于0xc009_a000，自定义内核主线程栈顶为0xc009_f000、内核主线程PCB为0xc009_e000。所以，本系统最大支持4个页框的位图（一个页框大小的位图可表示128M内存，4个页框即512M），用于内核/用户物理内存池bitmap、内核虚拟地址池bitmap。</p>

<blockquote>
  <p>9f000 - 1000 = 9e000 作为主线程的 PCB</p>

  <p>9e000 - 4000 = 9a000 作为位图地址，可以容纳 4 个页框</p>
</blockquote>

<p>实现方法类似 Linux 中的伙伴系统，在以页(4KB)为单位的内存管理基础上，实现小内存块的管理，可满足任意内存大小的分配与释放(malloc/free)。这里采用arena模型。</p>

<h2 id="5任务调度">5、任务调度</h2>

<p><a href="http://husharp.today/2020/12/09/thread-schedule/">进程管理（四）调度流程 &amp; Linux中的调度相关</a></p>

<p>传统操作系统的调度基于分时(time sharing)技术: 多个进程以”时间多路复用”方式运行，因为CPU的时间被分成”片(slice)”，给每个可运行进程分配一片CPU时间片，当然单处理器在任何给定的时刻只能运行一个进程。</p>

<p>如果当前可运行进程的时限(quantum)到期时(即时间片用尽)，而该进程还没有运行完毕，进程切换就可以发生。</p>

<p>分时依赖于定时中断，因此对进程是透明的，不需要在承租中插入额外的代码来保证CPU分时。</p>

<p>这也是HuSharpOS 的实现策略</p>

<p><img src="/assets/blog_image/2020-07-24-Os-MakeByBook/image-20201207195514895.png" alt="image-20201207195514895" /></p>

<p>详情见 此 Blog</p>

<h2 id="6文件系统">6、文件系统</h2>

<p>详情见 <a href="http://husharp.today/2020/12/12/FileSystem-Thinking/">文件系统总结</a></p>

<h2 id="7shell">7、Shell</h2>

<p>CRT相关</p>

<p>fork 、execv、wait、load、cmd_execute</p>

<p><a href="http://husharp.today/2020/11/18/fork-exec-wait-exit/">fork exec wait exit探究</a></p>

<p>详情见 <a href="http://husharp.today/2020/12/07/process-create/">进程管理（二）shell 是如何运行程序的? &amp; 进程的创建</a></p>

<h2 id="8锁">8、锁</h2>

<p>二元信号量的锁</p>

<pre><code class="language-assembly">锁
| struct lock pid_lock;        // 申请pid  FILE: thread/thread.c    
| struct lock console_lock;    // 控制台锁 FILE: device/console.c   console_init()
|
|---- FILE: thread/sync.c   lock_init(&amp;console_lock)
|       | 初始化锁
|       | 基于二元信号量实现的锁
|       | struct semaphore{
|       |     unsigned char value; struct list waiters; };
|       |     信号量初值，此信号量上阻塞的所有线程    
|       | struct lock{
|       |     struct task_struct *holder; struct semaphore sema; unsigned int holder_repeat_num; };
|       |     锁的持有者，信号量，锁的持有者重复申请锁的次数    
|       
|---- FILE: thread/sync.c   lock_acquire()
|       | 获取锁
|       | sema_down(&amp;lock-&gt;semaphore)信号量P操作
|       |     while(sema-&gt;value == 0)   // value为0表明已经被别人持有
|       |         list_append()当前线程把自己加入该锁的等待队列
|       |         thread_block()当前线程阻塞自己，并触发调度，切换线程
|       |         ************************************* 调度 *********
|       | lock-&gt;holder = running_thread()
|       |
|       |---- FILE: thread/thread.c     thread_block()
|               | 当前线程将自己阻塞
|               | 修改线程状态为阻塞、触发调度，切换线程执行
|               |
|               |---- FILE: thread/thread.c     schedule()
|                       | 任务调度 (由当前阻塞线程主动触发)    
|
|---- FILE: thread/sync.c   lock_release()
        | 释放锁
        | lock-&gt;holder = NULL
        | sema_up(&amp;lock-&gt;semaphore)信号量V操作
        |     list_pop(&amp;sema-&gt;waiters)从等待队列中取出一个线程
        |     thread_unblock()唤醒该阻塞线程: 将阻塞线程加入就绪队列，并修改状态为READY
        |     sema-&gt;value++    
        |
        |---- FILE: thread/thread.c     thread_unblock()
                | 唤醒阻塞线程
                | 将阻塞线程加入就绪队列，并修改状态为READY
</code></pre>

<p>信号解析见此 Blog</p>

<h2 id="9环形队列">9、环形队列</h2>

<p>生产者消费者模型</p>

<pre><code class="language-assembly">环形队列
| struct ioqueue keyboard_buf;  // 键盘
| struct ioqueue * xxx = xxx;   // 管道
|
|---- FILE: device/ioqueue.c    ioqueue_init(&amp;keyboard_buf)
|       | 初始化环形队列
|       | 结合锁机制、生产者消费者模型
|       | struct ioqueue{
|       |     struct lock lock; // 锁
|       |     struct task_struct *producer, *consumer; // 睡眠的生产者/消费者
|       |     char buf[buffersize]; // 缓冲区
|       |     signed int head, tail; }; // 队首写入，队尾读出
|
|---- FILE: device/ioqueue.c    ioq_getchar()
|       | 消费者消费一个字符
|       | while(ioq_empty(ioq)) // 缓冲区为空时，消费者睡眠
|       |     lock_acquire(&amp;ioq-&gt;lock);    // 获取锁，每个锁对应的信号量都会有一个阻塞队列
|       |     ioq_wait(&amp;ioq-&gt;consumer);    // 消费者睡眠
|       |     lock_release(&amp;ioq-&gt;lock);    // 释放锁
|       | char byte = ioq-&gt;buf[ioq-&gt;tail]; // 消费一个字符
|       | if(ioq-&gt;producer !=NULL) wakeup(&amp;ioq-&gt;producer); // 唤醒生产者(生产者睡眠是因为缓冲区满)    
|       
|---- FILE: device/ioqueue.c    ioq_putchar()
|       | 生产者生产一个字符
|       | while(ioq_full(ioq)) // 缓冲区满时，生产者睡眠
|       |     lock_acquire(&amp;ioq-&gt;lock); // 获取锁，每个锁对应的信号量都会有一个阻塞队列
|       |     ioq_wait(&amp;ioq-&gt;producer); // 生产者睡眠
|       |     lock_release(&amp;ioq-&gt;lock); // 释放锁
|       | ioq-&gt;buf[ioq-&gt;head] = byte;   // 生产一个字符
|       | if(ioq-&gt;consumer !=NULL) wakeup(&amp;ioq-&gt;consumer); // 唤醒消费者(消费者睡眠是因为缓冲区空)
</code></pre>

<h3 id="名词解释">名词解释</h3>

<p>全局描述符表：保护模式下内存段的登记表 即位于 Loader 0x900处
描述符desc 占 8 个字节，含有 base，limit，addr等
选择子：位于段寄存器，是 GDT 的索引
——–选择子结构———
15    3  2   0</p>

<p>描述符索引值 TI  RPL</p>

<p>而 total_mem_bytes 与loader.bin 之间还有 4 个段描述符（第 0 个不可用，第 1 个为代码段，第 2 个为数据段和栈，第 3 个为显存段）
以及 60 个预留段描述符槽位，因此 (60 + 4) * 8 = 512 = 0x200
total_mem_bytes : 0xb00 (存储获取到的内存变量)</p>

<p>页目录表： （物理地址）0x100000~0x100fff 4KB
第一个页表：（物理地址）0x101000~0x101fff 4KB
为映射到 0xc0000000，对应的页目录项为第 768 个，由于一个页表(页表项4字节)表示 4MB = (4GB/4KB)*4字节
所以第 768 个页目录项对应的虚拟地址 4MB：0xc0000000~0xc003ffff 指向低端 4MB之内的物理地址
为了实现所有用户共享内核，因此将 各个用户的虚拟地址高 1 GB都指向内核所在的物理内存空间。即每个用户 768~1022（共254个PDE）都与其他进程一致。（即：提前将内核的所有PDE都定下来，在创建用户进程时，直接将内核对应PDE复制，以达到内核共享）。</p>

<p>虚拟地址 0xc0000000~0xc00fffff 映射 物理地址 0x00000000~0x000fffff(低端 1Mb 内存)
0xc0100000：堆的起始地址（注意：由于0x100000~0x101fff为页目录表和页表，因此 0xc0100000并不映射到此处，需要绕开）
0xc009f000 内核主线程栈顶
0xc009e000 内核主线程的pcb. PCB占用 1 页 0x1000
0xc009a000 位图位置
0xc0000000 内核从虚拟地址3G起. 0x100000意指跨过低端1M内存</p>

<p>0x9f000：内核主线程栈顶
内核估计 70 kb 左右。装载到 0x9f000绰绰有余
因此在 低端 1MB 下所用到的最高地址，即为 main线程的栈顶地址 0x9f000</p>

<p>0xc009a000:位图位置
一个页框大小的位图可表示128M内存， 位图位置安排在地址0xc009a000</p>

<p>由于 虚拟机配置 32 MB 物理内存，因此需要 1024 字节 bitmap -&gt; 4kb * 1024 * 8 = 32 MB
即  1/4 页 ，但是我很任性，想搞 4 页，即 0x4000
又因为 pcb 位于 0xc009e000，所以将位图放在下面 0xc009e000 - 0x4000 = 0xc009a000</p>

<p>堆的起始地址：（为了让虚拟地址连续）</p>
<h1 id="define-k_heap_start-0xc0100000">define K_HEAP_START 0xc0100000</h1>

<div class="language-c highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">PCB</span> <span class="o">----&gt;</span> <span class="n">task_struct</span>
<span class="k">struct</span> <span class="n">task_struct</span> <span class="p">{</span>
   <span class="kt">uint32_t</span><span class="o">*</span> <span class="n">self_kstack</span><span class="p">;</span>     <span class="c1">// 各内核线程都用自己的内核栈，用来记录栈顶指针</span>
   <span class="n">_pid_t</span> <span class="n">pid</span><span class="p">;</span>
   <span class="k">enum</span> <span class="n">task_status</span> <span class="n">status</span><span class="p">;</span>
   <span class="kt">char</span> <span class="n">name</span><span class="p">[</span><span class="mi">16</span><span class="p">];</span>
   <span class="kt">uint8_t</span> <span class="n">priority</span><span class="p">;</span>
   <span class="kt">uint8_t</span> <span class="n">ticks</span><span class="p">;</span>             <span class="c1">// 每次在处理器上执行的时间嘀嗒数</span>
   <span class="kt">uint32_t</span> <span class="n">elapsed_ticks</span><span class="p">;</span>    <span class="c1">// 此任务自上cpu运行后至今占用了多少cpu嘀嗒数，也就是此任务执行了多久</span>
   <span class="k">struct</span> <span class="n">list_elem</span> <span class="n">general_tag</span><span class="p">;</span><span class="c1">//general_tag的作用是用于线程在一般的队列中的结点    </span>
   <span class="k">struct</span> <span class="n">list_elem</span> <span class="n">all_list_tag</span><span class="p">;</span><span class="c1">// all_list_tag的作用是用于线程队列thread_all_list中的结点 </span>
   <span class="kt">uint32_t</span><span class="o">*</span> <span class="n">pgdir</span><span class="p">;</span>              <span class="c1">// 进程自己页表的虚拟地址</span>
   <span class="k">struct</span> <span class="n">virtual_addr</span> <span class="n">userprog_vaddr</span><span class="p">;</span>   <span class="c1">// 用户进程的虚拟地址</span>
   <span class="kt">uint32_t</span> <span class="n">stack_magic</span><span class="p">;</span>         <span class="c1">// 用这串数字做栈的边界标记，用于检测栈的溢出</span>
<span class="p">};</span>
</code></pre></div></div>

<p>寄存器映像     —中断栈 intr_stack:    | kernel.S 中的 intr_exit 的出栈操作为此结构的逆操作
   1.任务被中断时，保存寄存器映像
   2.给进程预留，用来填充用户进程上下文，即寄存器环境
栈         —线程栈 thread_stack：保存待运行的函数，并进行任务切换  | 内核栈 = 中断栈 + 线程栈
栈指针     —记录线程栈栈顶，因为中断栈不固定 &lt;—-self_kstack
pid
进程状态
优先级
时间片
页表
打开文件描述符
父进程
…</p>

<p>系统调用步骤：</p>

<ol>
  <li>在 syscall.h 的结构 enum SYSCALL_NR 中添加新的子功能号</li>
  <li>在 syscall.c 中增加系统调用的用户接口</li>
  <li>在 syscall_init.c 定义子功能处理函数，并在syscall_table 中注册</li>
</ol>

<p>端口就是位于 IO 控制器上的接口</p>

<p>command 寄存器要最后写入，因此一旦写入，硬盘便开始工作</p>

<h2 id="实现的系统调用">实现的系统调用</h2>

<div class="language-c highlighter-rouge"><div class="highlight"><pre class="highlight"><code>   <span class="n">syscall_table</span><span class="p">[</span><span class="n">SYS_GETPID</span><span class="p">]</span> <span class="o">=</span> <span class="n">sys_getpid</span><span class="p">;</span>
   <span class="n">syscall_table</span><span class="p">[</span><span class="n">SYS_WRITE</span><span class="p">]</span> <span class="o">=</span> <span class="n">sys_write</span><span class="p">;</span>
   <span class="n">syscall_table</span><span class="p">[</span><span class="n">SYS_MALLOC</span><span class="p">]</span> <span class="o">=</span> <span class="n">sys_malloc</span><span class="p">;</span>
   <span class="n">syscall_table</span><span class="p">[</span><span class="n">SYS_FREE</span><span class="p">]</span> <span class="o">=</span> <span class="n">sys_free</span><span class="p">;</span>
   <span class="n">syscall_table</span><span class="p">[</span><span class="n">SYS_FORK</span><span class="p">]</span> <span class="o">=</span> <span class="n">sys_fork</span><span class="p">;</span>
   <span class="n">syscall_table</span><span class="p">[</span><span class="n">SYS_READ</span><span class="p">]</span> <span class="o">=</span> <span class="n">sys_read</span><span class="p">;</span>
   <span class="n">syscall_table</span><span class="p">[</span><span class="n">SYS_PUTCHAR</span><span class="p">]</span> <span class="o">=</span> <span class="n">sys_putchar</span><span class="p">;</span>
   <span class="n">syscall_table</span><span class="p">[</span><span class="n">SYS_CLEAR</span><span class="p">]</span>   <span class="o">=</span> <span class="n">cls_screen</span><span class="p">;</span> <span class="c1">// 位于 print.S</span>
   <span class="n">syscall_table</span><span class="p">[</span><span class="n">SYS_GETCWD</span><span class="p">]</span>     <span class="o">=</span> <span class="n">sys_getcwd</span><span class="p">;</span>
   <span class="n">syscall_table</span><span class="p">[</span><span class="n">SYS_OPEN</span><span class="p">]</span>       <span class="o">=</span> <span class="n">sys_open</span><span class="p">;</span>
   <span class="n">syscall_table</span><span class="p">[</span><span class="n">SYS_CLOSE</span><span class="p">]</span>      <span class="o">=</span> <span class="n">sys_close</span><span class="p">;</span>
   <span class="n">syscall_table</span><span class="p">[</span><span class="n">SYS_LSEEK</span><span class="p">]</span>    <span class="o">=</span> <span class="n">sys_lseek</span><span class="p">;</span>
   <span class="n">syscall_table</span><span class="p">[</span><span class="n">SYS_UNLINK</span><span class="p">]</span>   <span class="o">=</span> <span class="n">sys_unlink</span><span class="p">;</span>
   <span class="n">syscall_table</span><span class="p">[</span><span class="n">SYS_MKDIR</span><span class="p">]</span>    <span class="o">=</span> <span class="n">sys_mkdir</span><span class="p">;</span>
   <span class="n">syscall_table</span><span class="p">[</span><span class="n">SYS_OPENDIR</span><span class="p">]</span>  <span class="o">=</span> <span class="n">sys_opendir</span><span class="p">;</span>
   <span class="n">syscall_table</span><span class="p">[</span><span class="n">SYS_CLOSEDIR</span><span class="p">]</span>   <span class="o">=</span> <span class="n">sys_closedir</span><span class="p">;</span>
   <span class="n">syscall_table</span><span class="p">[</span><span class="n">SYS_CHDIR</span><span class="p">]</span>    <span class="o">=</span> <span class="n">sys_chdir</span><span class="p">;</span>
   <span class="n">syscall_table</span><span class="p">[</span><span class="n">SYS_RMDIR</span><span class="p">]</span>    <span class="o">=</span> <span class="n">sys_rmdir</span><span class="p">;</span>
   <span class="n">syscall_table</span><span class="p">[</span><span class="n">SYS_READDIR</span><span class="p">]</span>  <span class="o">=</span> <span class="n">sys_readdir</span><span class="p">;</span>
   <span class="n">syscall_table</span><span class="p">[</span><span class="n">SYS_REWINDDIR</span><span class="p">]</span>   <span class="o">=</span> <span class="n">sys_rewinddir</span><span class="p">;</span>
   <span class="n">syscall_table</span><span class="p">[</span><span class="n">SYS_STAT</span><span class="p">]</span>  <span class="o">=</span> <span class="n">sys_stat</span><span class="p">;</span>
   <span class="n">syscall_table</span><span class="p">[</span><span class="n">SYS_PS</span><span class="p">]</span>    <span class="o">=</span> <span class="n">sys_ps</span><span class="p">;</span>
   <span class="n">syscall_table</span><span class="p">[</span><span class="n">SYS_EXECV</span><span class="p">]</span>    <span class="o">=</span> <span class="n">sys_execv</span><span class="p">;</span>
</code></pre></div></div>

<h2 id="实现函数">实现函数</h2>

<div class="language-c highlighter-rouge"><div class="highlight"><pre class="highlight"><code>   <span class="kt">uint32_t</span> <span class="nf">getpid</span><span class="p">(</span><span class="kt">void</span><span class="p">);</span>
   <span class="kt">uint32_t</span> <span class="nf">write</span><span class="p">(</span><span class="kt">int32_t</span> <span class="n">fd</span><span class="p">,</span> <span class="k">const</span> <span class="kt">void</span><span class="o">*</span> <span class="n">buf</span><span class="p">,</span> <span class="kt">uint32_t</span> <span class="n">count</span><span class="p">);</span>
   <span class="kt">void</span><span class="o">*</span> <span class="nf">malloc</span><span class="p">(</span><span class="kt">uint32_t</span> <span class="n">size</span><span class="p">);</span>
   <span class="kt">void</span> <span class="nf">free</span><span class="p">(</span><span class="kt">void</span><span class="o">*</span> <span class="n">ptr</span><span class="p">);</span>
   <span class="kt">int16_t</span> <span class="nf">fork</span><span class="p">(</span><span class="kt">void</span><span class="p">);</span>
   <span class="kt">int32_t</span> <span class="nf">read</span><span class="p">(</span><span class="kt">int32_t</span> <span class="n">fd</span><span class="p">,</span> <span class="kt">void</span><span class="o">*</span> <span class="n">buf</span><span class="p">,</span> <span class="kt">uint32_t</span> <span class="n">count</span><span class="p">);</span>
   <span class="kt">void</span> <span class="nf">putchar</span><span class="p">(</span><span class="kt">char</span> <span class="n">char_asci</span><span class="p">);</span>
   <span class="kt">void</span> <span class="nf">clear</span><span class="p">(</span><span class="kt">void</span><span class="p">);</span>
   <span class="kt">char</span><span class="o">*</span> <span class="nf">getcwd</span><span class="p">(</span><span class="kt">char</span><span class="o">*</span> <span class="n">buf</span><span class="p">,</span> <span class="kt">uint32_t</span> <span class="n">size</span><span class="p">);</span>
   <span class="kt">int32_t</span> <span class="nf">open</span><span class="p">(</span><span class="kt">char</span><span class="o">*</span> <span class="n">pathname</span><span class="p">,</span> <span class="kt">uint8_t</span> <span class="n">flag</span><span class="p">);</span>
   <span class="kt">int32_t</span> <span class="nf">close</span><span class="p">(</span><span class="kt">int32_t</span> <span class="n">fd</span><span class="p">);</span>
   <span class="kt">int32_t</span> <span class="nf">lseek</span><span class="p">(</span><span class="kt">int32_t</span> <span class="n">fd</span><span class="p">,</span> <span class="kt">int32_t</span> <span class="n">offset</span><span class="p">,</span> <span class="kt">uint8_t</span> <span class="n">whence</span><span class="p">);</span>
   <span class="kt">int32_t</span> <span class="nf">unlink</span><span class="p">(</span><span class="k">const</span> <span class="kt">char</span><span class="o">*</span> <span class="n">pathname</span><span class="p">);</span>
   <span class="kt">int32_t</span> <span class="nf">mkdir</span><span class="p">(</span><span class="k">const</span> <span class="kt">char</span><span class="o">*</span> <span class="n">pathname</span><span class="p">);</span>
   <span class="k">struct</span> <span class="n">dir</span><span class="o">*</span> <span class="nf">opendir</span><span class="p">(</span><span class="k">const</span> <span class="kt">char</span><span class="o">*</span> <span class="n">name</span><span class="p">);</span>
   <span class="kt">int32_t</span> <span class="nf">closedir</span><span class="p">(</span><span class="k">struct</span> <span class="n">dir</span><span class="o">*</span> <span class="n">dir</span><span class="p">);</span>
   <span class="kt">int32_t</span> <span class="nf">rmdir</span><span class="p">(</span><span class="k">const</span> <span class="kt">char</span><span class="o">*</span> <span class="n">pathname</span><span class="p">);</span>
   <span class="k">struct</span> <span class="n">dir_entry</span><span class="o">*</span> <span class="nf">readdir</span><span class="p">(</span><span class="k">struct</span> <span class="n">dir</span><span class="o">*</span> <span class="n">dir</span><span class="p">);</span>
   <span class="kt">void</span> <span class="nf">rewinddir</span><span class="p">(</span><span class="k">struct</span> <span class="n">dir</span><span class="o">*</span> <span class="n">dir</span><span class="p">);</span>
   <span class="kt">int32_t</span> <span class="nf">stat</span><span class="p">(</span><span class="k">const</span> <span class="kt">char</span><span class="o">*</span> <span class="n">path</span><span class="p">,</span> <span class="k">struct</span> <span class="n">file_attr</span><span class="o">*</span> <span class="n">buf</span><span class="p">);</span>
   <span class="kt">int32_t</span> <span class="nf">chdir</span><span class="p">(</span><span class="k">const</span> <span class="kt">char</span><span class="o">*</span> <span class="n">path</span><span class="p">);</span>
   <span class="kt">void</span> <span class="nf">ps</span><span class="p">(</span><span class="kt">void</span><span class="p">);</span>
   <span class="kt">int</span> <span class="nf">execv</span><span class="p">(</span><span class="k">const</span> <span class="kt">char</span><span class="o">*</span> <span class="n">pathname</span><span class="p">,</span> <span class="kt">char</span><span class="o">**</span> <span class="n">argv</span><span class="p">);</span><span class="kt">uint32_t</span> <span class="nf">getpid</span><span class="p">(</span><span class="kt">void</span><span class="p">);</span>
   <span class="kt">uint32_t</span> <span class="nf">write</span><span class="p">(</span><span class="kt">int32_t</span> <span class="n">fd</span><span class="p">,</span> <span class="k">const</span> <span class="kt">void</span><span class="o">*</span> <span class="n">buf</span><span class="p">,</span> <span class="kt">uint32_t</span> <span class="n">count</span><span class="p">);</span>
   <span class="kt">void</span><span class="o">*</span> <span class="nf">malloc</span><span class="p">(</span><span class="kt">uint32_t</span> <span class="n">size</span><span class="p">);</span>
   <span class="kt">void</span> <span class="nf">free</span><span class="p">(</span><span class="kt">void</span><span class="o">*</span> <span class="n">ptr</span><span class="p">);</span>
   <span class="kt">int16_t</span> <span class="nf">fork</span><span class="p">(</span><span class="kt">void</span><span class="p">);</span>
   <span class="kt">int32_t</span> <span class="nf">read</span><span class="p">(</span><span class="kt">int32_t</span> <span class="n">fd</span><span class="p">,</span> <span class="kt">void</span><span class="o">*</span> <span class="n">buf</span><span class="p">,</span> <span class="kt">uint32_t</span> <span class="n">count</span><span class="p">);</span>
   <span class="kt">void</span> <span class="nf">putchar</span><span class="p">(</span><span class="kt">char</span> <span class="n">char_asci</span><span class="p">);</span>
   <span class="kt">void</span> <span class="nf">clear</span><span class="p">(</span><span class="kt">void</span><span class="p">);</span>
   <span class="kt">char</span><span class="o">*</span> <span class="nf">getcwd</span><span class="p">(</span><span class="kt">char</span><span class="o">*</span> <span class="n">buf</span><span class="p">,</span> <span class="kt">uint32_t</span> <span class="n">size</span><span class="p">);</span>
   <span class="kt">int32_t</span> <span class="nf">open</span><span class="p">(</span><span class="kt">char</span><span class="o">*</span> <span class="n">pathname</span><span class="p">,</span> <span class="kt">uint8_t</span> <span class="n">flag</span><span class="p">);</span>
   <span class="kt">int32_t</span> <span class="nf">close</span><span class="p">(</span><span class="kt">int32_t</span> <span class="n">fd</span><span class="p">);</span>
   <span class="kt">int32_t</span> <span class="nf">lseek</span><span class="p">(</span><span class="kt">int32_t</span> <span class="n">fd</span><span class="p">,</span> <span class="kt">int32_t</span> <span class="n">offset</span><span class="p">,</span> <span class="kt">uint8_t</span> <span class="n">whence</span><span class="p">);</span>
   <span class="kt">int32_t</span> <span class="nf">unlink</span><span class="p">(</span><span class="k">const</span> <span class="kt">char</span><span class="o">*</span> <span class="n">pathname</span><span class="p">);</span>
   <span class="kt">int32_t</span> <span class="nf">mkdir</span><span class="p">(</span><span class="k">const</span> <span class="kt">char</span><span class="o">*</span> <span class="n">pathname</span><span class="p">);</span>
   <span class="k">struct</span> <span class="n">dir</span><span class="o">*</span> <span class="nf">opendir</span><span class="p">(</span><span class="k">const</span> <span class="kt">char</span><span class="o">*</span> <span class="n">name</span><span class="p">);</span>
   <span class="kt">int32_t</span> <span class="nf">closedir</span><span class="p">(</span><span class="k">struct</span> <span class="n">dir</span><span class="o">*</span> <span class="n">dir</span><span class="p">);</span>
   <span class="kt">int32_t</span> <span class="nf">rmdir</span><span class="p">(</span><span class="k">const</span> <span class="kt">char</span><span class="o">*</span> <span class="n">pathname</span><span class="p">);</span>
   <span class="k">struct</span> <span class="n">dir_entry</span><span class="o">*</span> <span class="nf">readdir</span><span class="p">(</span><span class="k">struct</span> <span class="n">dir</span><span class="o">*</span> <span class="n">dir</span><span class="p">);</span>
   <span class="kt">void</span> <span class="nf">rewinddir</span><span class="p">(</span><span class="k">struct</span> <span class="n">dir</span><span class="o">*</span> <span class="n">dir</span><span class="p">);</span>
   <span class="kt">int32_t</span> <span class="nf">stat</span><span class="p">(</span><span class="k">const</span> <span class="kt">char</span><span class="o">*</span> <span class="n">path</span><span class="p">,</span> <span class="k">struct</span> <span class="n">file_attr</span><span class="o">*</span> <span class="n">buf</span><span class="p">);</span>
   <span class="kt">int32_t</span> <span class="nf">chdir</span><span class="p">(</span><span class="k">const</span> <span class="kt">char</span><span class="o">*</span> <span class="n">path</span><span class="p">);</span>
   <span class="kt">void</span> <span class="nf">ps</span><span class="p">(</span><span class="kt">void</span><span class="p">);</span>
   <span class="kt">int</span> <span class="nf">execv</span><span class="p">(</span><span class="k">const</span> <span class="kt">char</span><span class="o">*</span> <span class="n">pathname</span><span class="p">,</span> <span class="kt">char</span><span class="o">**</span> <span class="n">argv</span><span class="p">);</span>
</code></pre></div></div>

<p>over</p>]]></content><author><name></name></author><category term="linux" /></entry><entry><title type="html">HuSharp 的由来</title><link href="/life/2020/07/18/HuSharp-origin.html" rel="alternate" type="text/html" title="HuSharp 的由来" /><published>2020-07-18T01:00:00+00:00</published><updated>2020-07-18T01:00:00+00:00</updated><id>/life/2020/07/18/HuSharp-origin</id><content type="html" xml:base="/life/2020/07/18/HuSharp-origin.html"><![CDATA[<p># 汉语中因形似 “井”，读作井号（Jinghao），通常用于数字符号（Number Sign），如在一些国家 <code class="language-plaintext highlighter-rouge">#1</code> 代表 No.1。</p>

<p><img src="/assets/blog_image/2020-07-18-HuSharp-origin/musical_sharp.png" alt="musiceol" /></p>

<p>数字符号（#）极易和乐谱中的升音符（♯ 读作 sharp /ʃɑ:rp/）相混淆，意为将一个音符提升半音。数字符号（#）横线水平，竖线向右倾斜；而乐谱的升音符（♯）为了在五线谱中容易识别，横线改为斜向上但竖线垂直。</p>

<p>而 C#（C Sharp）本源于升音符（♯），代表在 C 基础上升高半音。但由于（♯）在计算机显示、输入不方便，因此在书写体中用（#）代替（♯），但读音保持不变。于是就出现了书写成 <code class="language-plaintext highlighter-rouge">C#</code> 念作 <code class="language-plaintext highlighter-rouge">C Sharp</code> 的情形。</p>

<p>而本人名字（Jinhao）发音大致同 “井号”（Jinghao，暴露了不念后鼻音= =），便因此以 <code class="language-plaintext highlighter-rouge">Hu#</code> 为 ID 进行冲浪了。</p>]]></content><author><name></name></author><category term="life" /><summary type="html"><![CDATA[# 汉语中因形似 “井”，读作井号（Jinghao），通常用于数字符号（Number Sign），如在一些国家 #1 代表 No.1。]]></summary></entry></feed>